

这周腾讯混元放权重跟流水席似的:11月18日前后 Hy4-Flash 权重开源,隔天官方 GGUF 量化和 Mac、N 卡、DGX Spark 适配方案跟上;11月20日,770B 的旗舰 Hy4 也放出指令版、FP8、Base 三套权重,加一份 System Card,GitHub、Hugging Face、ModelScope、GitCode 四平台同步——混元 LLM 系列至此全部开源。标题很热闹,但落到你自己那台机器上,能认真考虑的只有 Hy4-Flash 这一个,而它也不是白给。知乎知乎
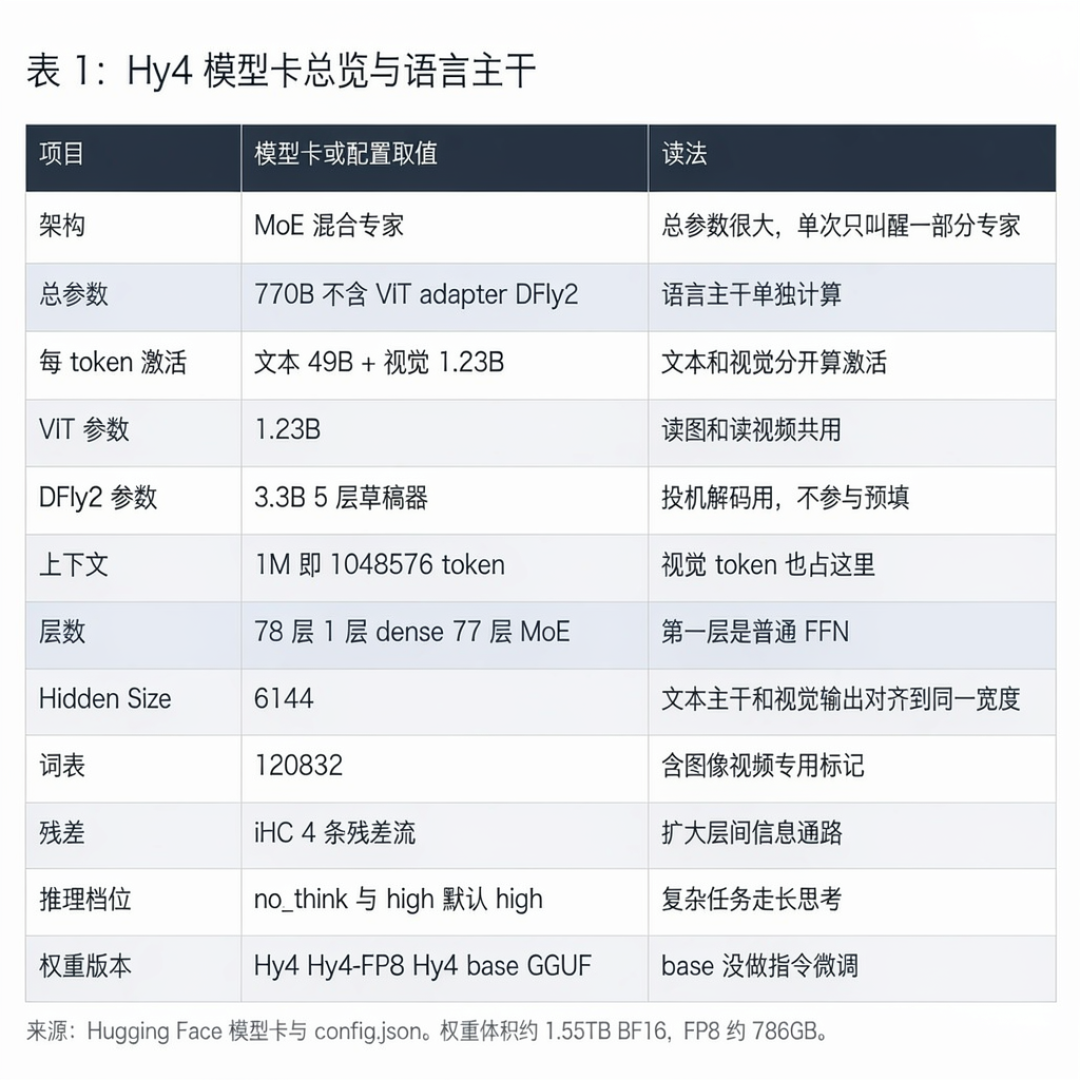
先说 770B 为什么轮不到个人。 按 FP8 每个参数占 1 个字节粗算,770B 参数光权重就是 774GB。一张 80GB 的专业卡装个零头都不到,官方部署口径建议 vLLM/SGLang,起步就是多卡张量并行,真扛并发还得再堆 KV cache。更要紧的是许可:官方 LICENSE 是 Tencent Hy License 1.0,文件开篇写明派生自 Apache 2.0、但不是 Apache 2.0,媒体误报 Apache 2.0 的不少。自用、内部研究、把模型收在具体产品功能里都不触发额外义务;但要拿它对外提供通用模型服务,且连续 12 个月全球总收入超 5000 万美元或任一产品月活超 1 亿,须另签腾讯书面许可。翻译成人话:下载随便,拿它卖接口之前先照照自己的体量。知乎知乎
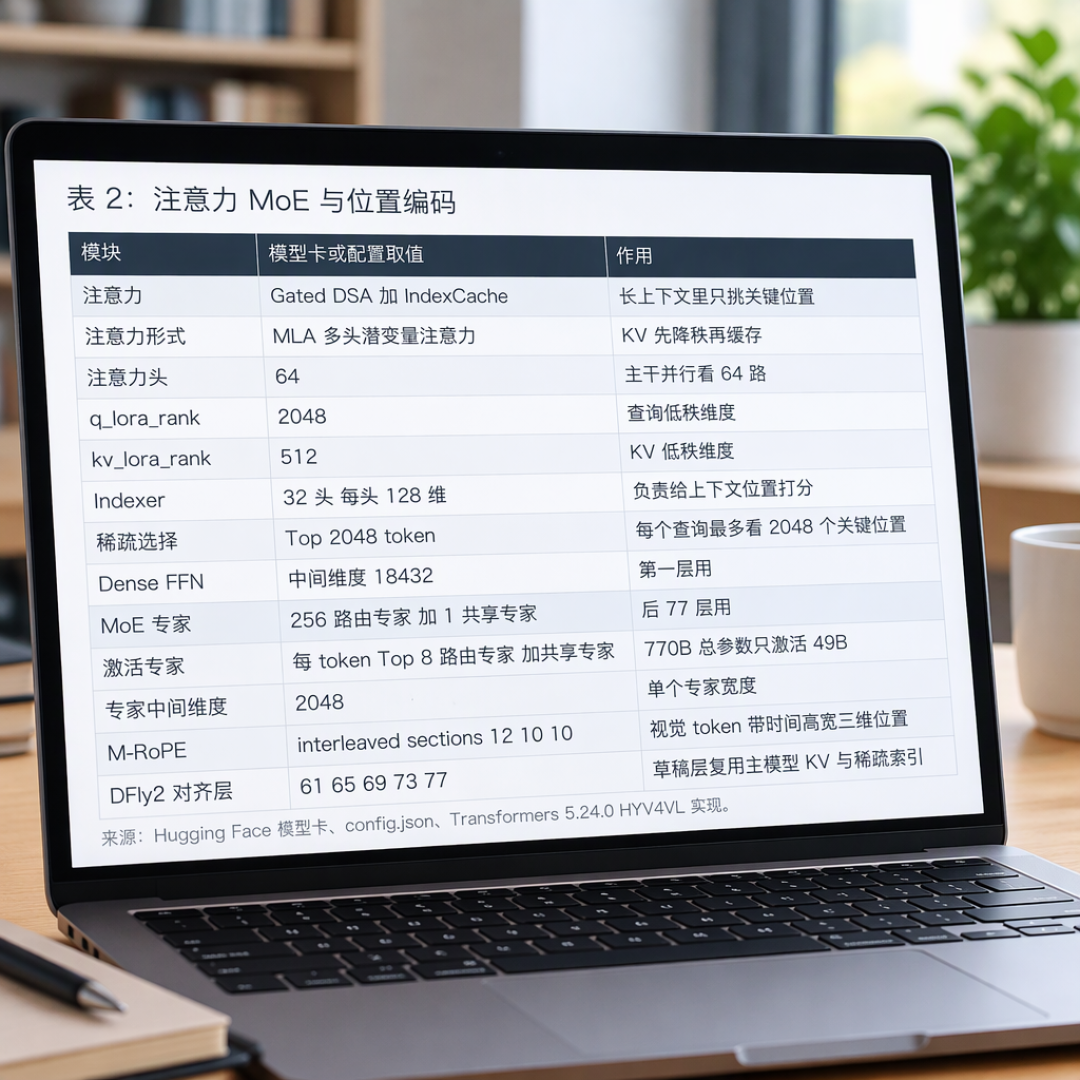
Flash 才是本地党的题:224B 总参,单 token 只激活 12B。 秘诀是把"常驻计算"和"可挪走"分开:64B 的 Engram 参数可以挪出去,KV cache 压到 Hy4 的约 1/6。所以"220B 跑本地"不是营销话术,是显存账真的能平——前提是你内存够厚。这次腾讯连中间商都省了,直接发官方 GGUF:包括 Q4、Q3、IQ2 等多个版本。官方仓库里 Q3_K 一档文件就是 144.7GiB。文件躺在磁盘上、参数钉进内存里,不用赌野鸡量化包的成色。知乎哔哩哔哩哔哩哔哩
已有一手实测给你兜底。 B站 dotAI 用单张 96GB 专业卡跑 Q3_K:44 层主干进显存、63.5B Engram 钉主机内存,热启动 9 秒还剩 8.5G 余量,日常解码 31–40 tok/s,12.5K 长文预填 1326 tok/s。Mac 侧官方数据:M5 Max 在 4K 上下文下最高约 48 tok/s,拉到 32K 仍有 44。评论区也有人纠正:DGX Spark 的官方适配是单机成绩,目前不支持双机互联,小盒子并联乘速度的想象先收一收。哔哩哔哩哔哩哔哩
四个坑,教程大概率不讲。 ①llama.cpp 支持还挂在 PR#32517 上,想尝鲜得源码编译,等官方合并再用 Ollama/LM Studio 点按钮;②Engram 卸载的配置项张量名是 `per_layer_token_embd`,有人凭直觉写成 “engram”,写错不报错,直接静默炸显存。③解码快不等于全程快,长文档的体感卡在 prefill,扔一份大 PDF 进去要有耐心;④别拿旗舰的活考 Flash——自家 WorkIndex 只给 Flash 42 分、低于旗舰 Hy4 的 51,长程编程这类硬活官方自己都建议留给旗舰,85 位内部用户 259 项日常任务盲测里,Hy4-Flash 满意度 2.79、贴着 Haiku 5.5 的 2.81。哔哩哔哩知乎
最后算另一本账。 如果你不是要折腾硬件、只是要干活:Hy4-Flash 每百万 Token 输入 0.5 元、输出 2 元,命中缓存时仅需 0.02 元。11 月 30 日前 WorkBuddy 限时免费、腾讯云 TokenHub 的 API 限时 5 折,想试的人这两周是成本最低的窗口。调用量已经冲上 OpenRouter 日榜第一——而这第一名的含金量在成本不在智能。这是送鸡蛋阶段的性价比,评测数字全是官方口径、尚无独立复核,评论区"偷懒""下限稳上限一般"的两派口碑都在。所以分工很清楚:大内存 Mac、96G 级显卡用户可以跟着官方 GGUF 开玩;24G、48G 卡的用户先别动手,等社区把量化和适配趟平了再说;770B?那是企业的故事,不进你的采购清单。知乎知乎知乎
当前文章无评论,是时候发表评论了