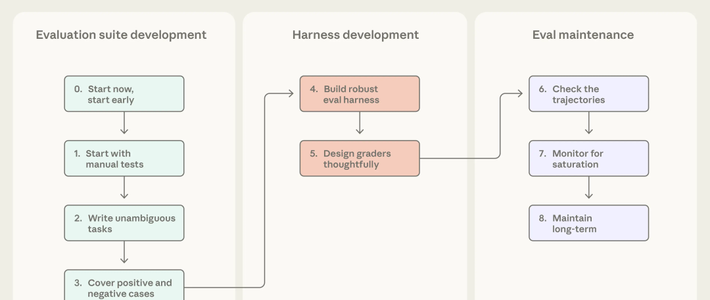
知乎最近一篇被收藏了157次的面试经验帖,开头足够直白:纯 RAG、只会调用框架、做过几个个人 Demo Agent,基本过不了简历关。同一时间窗口,纳德拉在一档播客里把话挑明了:未来每家企业都会构建自己的私有评测基准,这将成为企业最核心的商业知识产权。一边是招聘端的现实,一边是巨头掌门的判断——AI工程化,已经从“能不能搭出来”进入“怎么证明它行”的阶段。知乎36氪知乎
从全场惊艳到账号闲置,中间只隔着一场“验收”
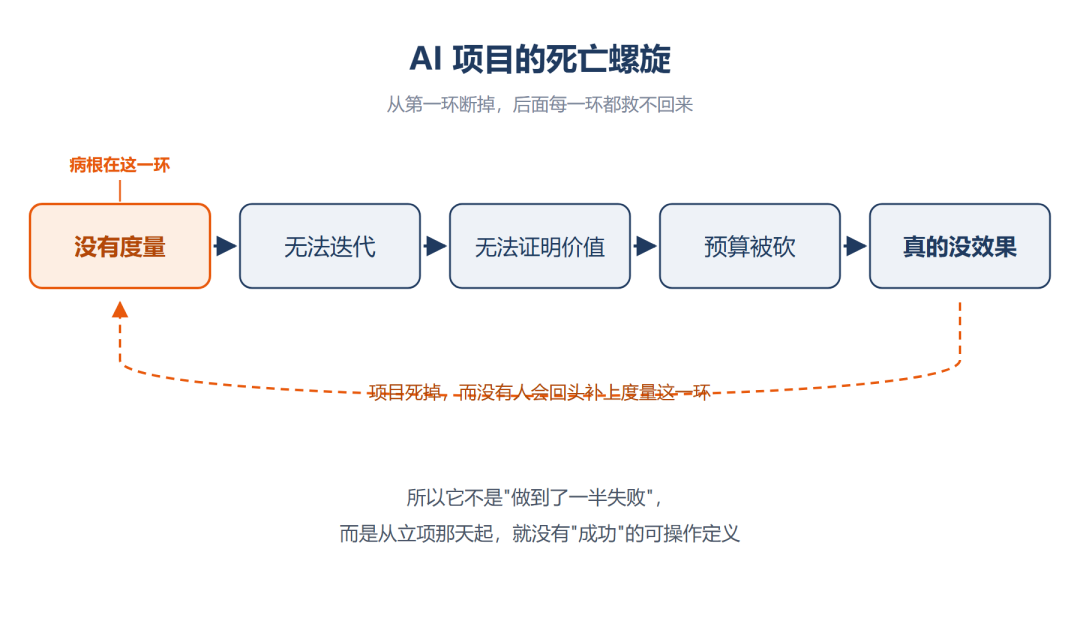
业内被反复转述的场景:第一年,给管理层演示大模型,全场震惊;第二年,账号陆续闲置。知乎
Gartner 调研显示,真正部署 AI 智能体的组织只有 17%,而超过 40% 的智能体项目,预计会在 2027 年前被砍掉。知乎
卡点则是数据孤岛、流程断点、治理缺位——这五件事,没有一件是“换个更强的模型”能解决的。知乎
拿0分不等于Agent不会,先把账拆成三笔
有博主测了88道任务,16道题拿了0分。他不修题,只加预算重跑——2倍预算9道直接转正,4倍预算再多转1道,还有1道是验证器自己404根本没跑起来,最后真能力缺口只剩5道。总分描述的是默认预算下的表现,不是能力本身。知乎
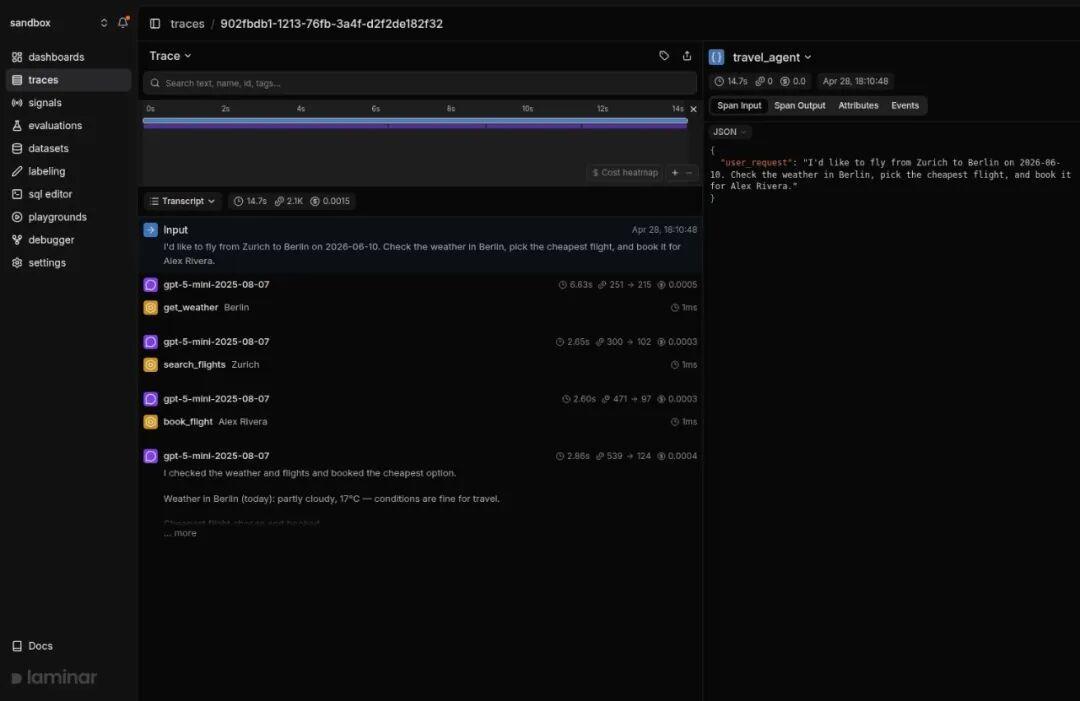
所以验收要分三层:契约回归(协议、沙箱)→外部基准(固定预算下可比)→失败归因(harness/环境/产品bug/时限/评分严格度/能力,只有确认是产品缺陷才开issue)。最阴的坑是“假完成”:工作区被整体只读挂载,模型多次写入全被拒,最后仍以 success 收尾。“完成”必须有可观测的写入凭证,模型自述不算数。知乎
核心循环几十行,几万行花在“最后一公里”
知乎上有个问题:编程Agent核心才几十行,剩下几万行在解决什么?高赞回答先泼冷水:当年那个核心循环,在整个工程里连百分之一的篇幅都占不到。知乎
真正塞满那几万行的,是极其繁琐的状态机、AST 语法树解析、进程树监控、增量 diff 计算和上下文管理。崩溃接管、按已提交进度回滚、防止错误上下文滚雪球,全靠这些机制——这就是“演示惊艳、上线拉胯”的真实距离。知乎
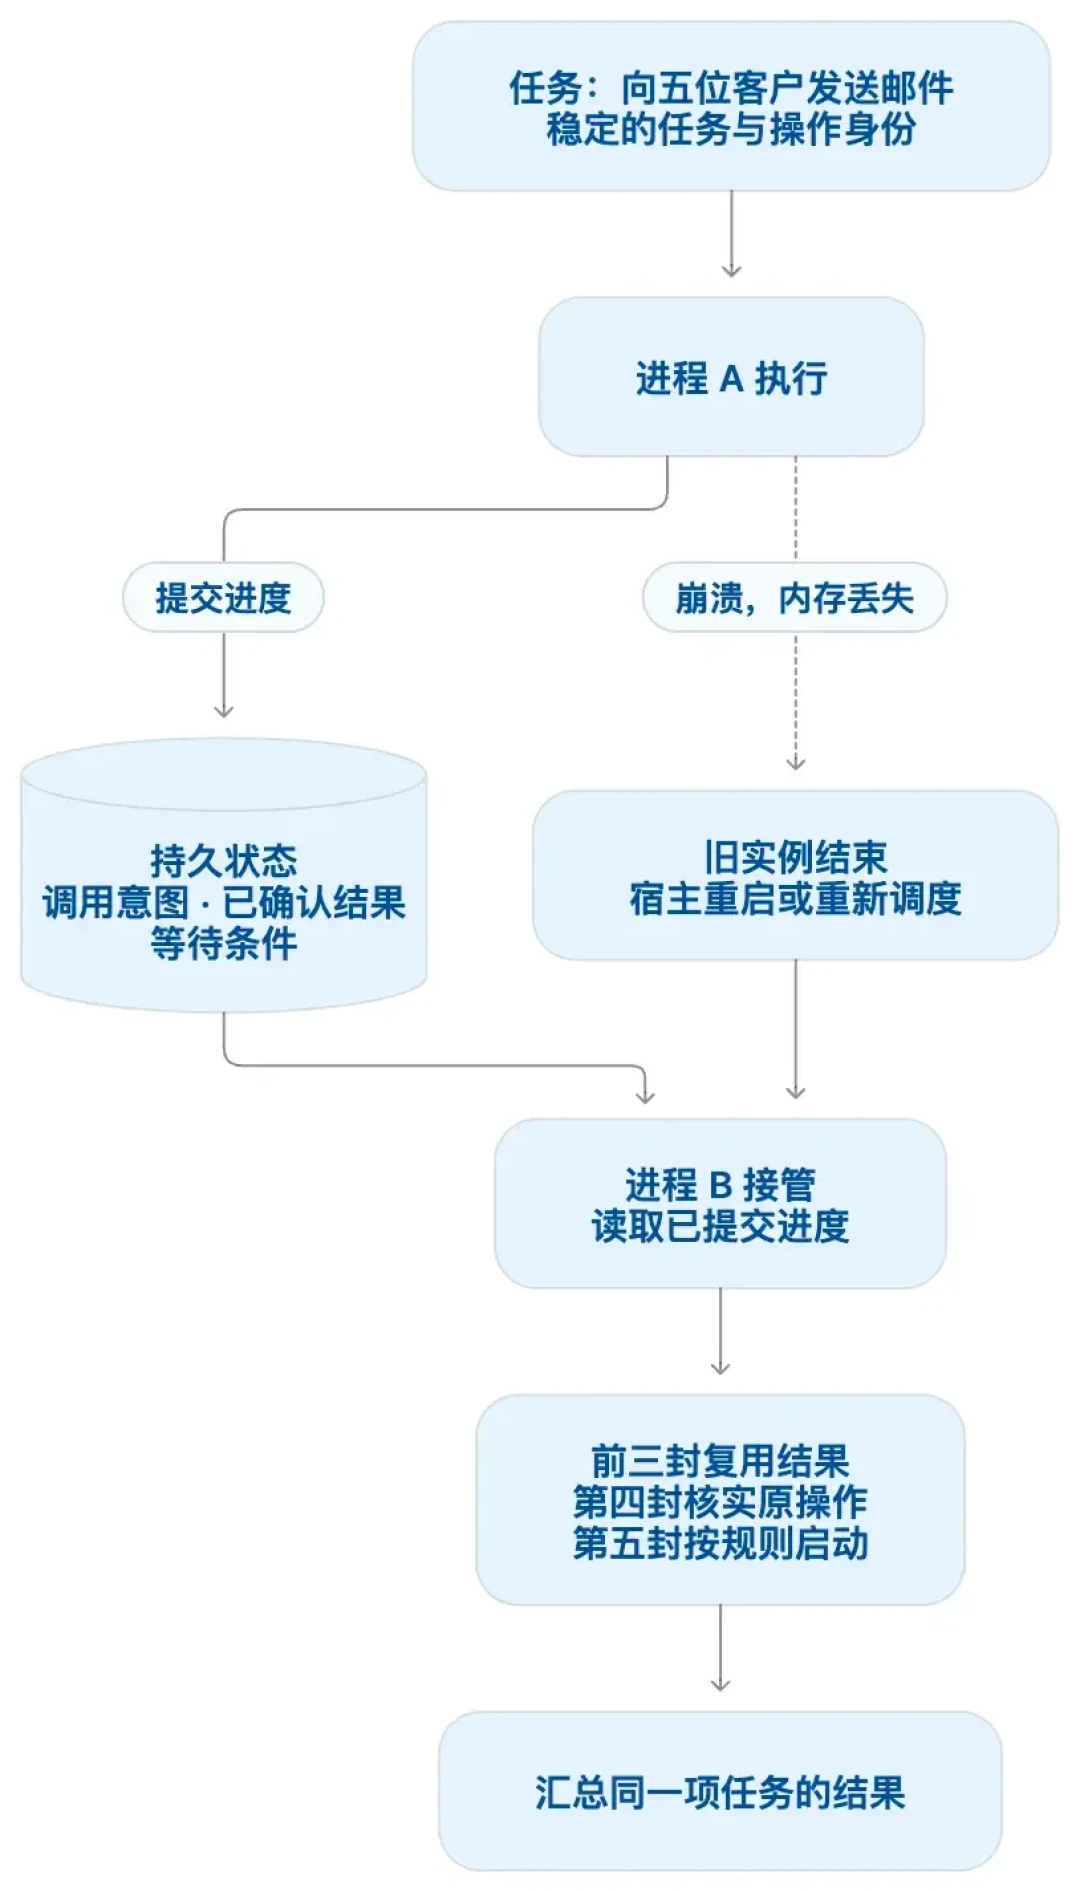
小评测集,越早动手越值钱
大厂已经下场:金蝶联合大模型厂商和高校,发布了国内首个面向企业管理场景的智能体评测基准 Lingee Bench,覆盖通用办公、财务、供应链、制造4套评测集、1400多道题。知乎
信通院也在今年7月牵头发布了《云上Agent基准度量模型》。普通团队直接抄作业:几十上百题的小评测集先建起来,固定预算口径,每次失败逐一归因。连面试官都开始卡这个:算法思维依然非常重要,甚至越来越重要,例如 Evaluation-driven、消融实验。知乎知乎
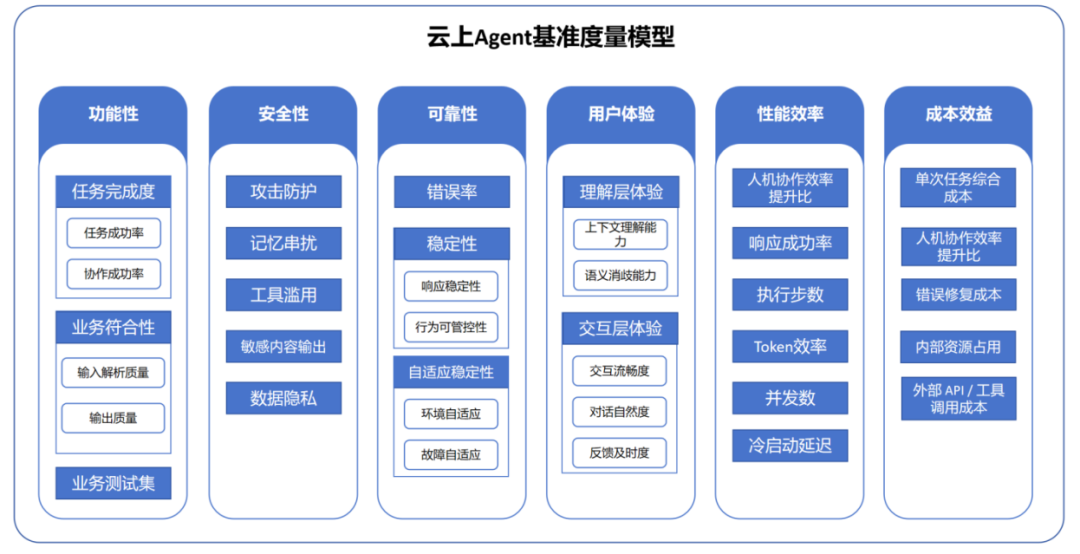
模型是外部的,评测是自己的。纳德拉把话说明白了:五年后企业最核心的资产,就是一套自己的专有评测基准。这是唯一拿不走的东西。