

这几天,只要你混本地 AI 圈或者显卡圈,大概率被同一类帖子刷屏:「英伟达显卡算力免费翻倍」「3090 白捡 80% 算力」「4090 吞吐从 165 干到 331 TFLOPS」。更刺激的还在后面——有社区文章提到,海外二手平台上原本 1000 美元左右的 3090 Ti,一周内被炒到了 2650 美元。知乎
先把结论放在前面:这事是真的,不是营销号炒作,GitHub 上的开源项目、独立复测数据、B 站和知乎的实测帖都能对上。但「算力翻倍」这四个字水分很大——它只发生在一条非常特定的计算路径上,不同人实际到手的收益从 0 到 100% 不等。动手之前,值得先弄清楚三件事:锁的到底是什么、你能捡到多少、坑在哪里。
同一颗芯片,游戏卡只让出一半的拳
先说这次解锁的对象。以 30 系为例,RTX 3090 和专业卡 A6000 用的是同一颗 GA102 芯片,CUDA 核心、Tensor Core 硬件完全一样,没有任何物理阉割。差别在哪?英伟达在固件里留了一组叫速度选择器(Speed Selector,SS0/SS1)的寄存器,把消费级卡在「FP16/BF16 输入 + FP32 累加」这条混合精度路径上的指令发射速率写死成了专业卡的一半。同样的肌肉,游戏卡被固件要求每秒只能出一半的拳——这是纯粹的商业分级,不是物理限制。知乎知乎
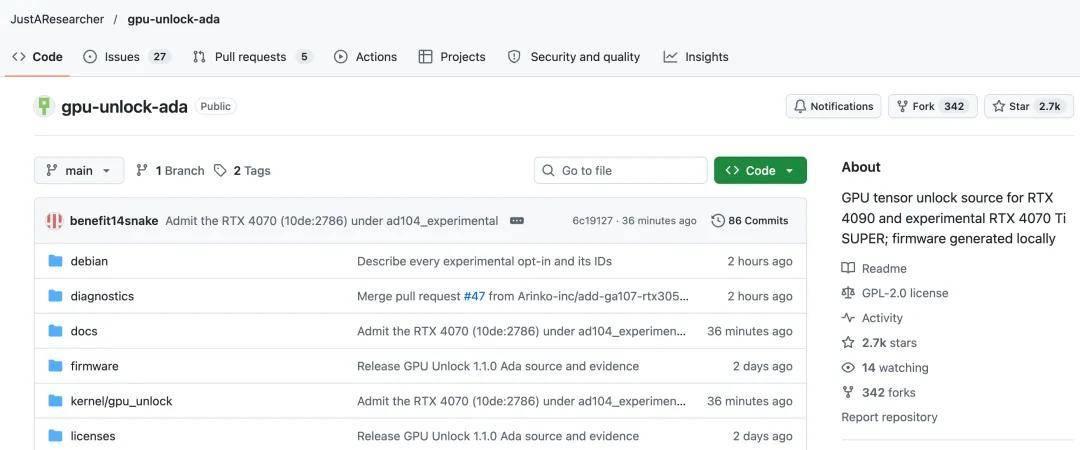
10 月 18 日,GitHub 用户 Zagitta 建了个叫 gpu-unlock 的仓库,七天攒了三千多颗星。它的思路相当巧:不碰驱动、不刷 VBIOS、不改硬件,而是一个塞进系统启动流程的 Linux 内核模块,抢在英伟达官方驱动接管显卡之前,借用显卡 VBIOS 里签名固件的一个漏洞改掉那两个速率寄存器,再做一次 PCIe 复位,然后把卡「干干净净」交还给原版驱动。Zagitta 自己在 Hacker News 上的总结是:这个漏洞翻转的就是两个 bit,而这两个 bit 把某些指令的发射速率砍成了专业卡的一半。知乎
更关键的是,解锁是易失的——断电即失效,注册表状态不写进任何固件,官方驱动一个字节都不用动,输出结果和解锁前逐位一致(有人专门比对了 SHA-256 哈希)。这也意味着英伟达很难靠发一版新驱动就把它堵死。哔哩哔哩
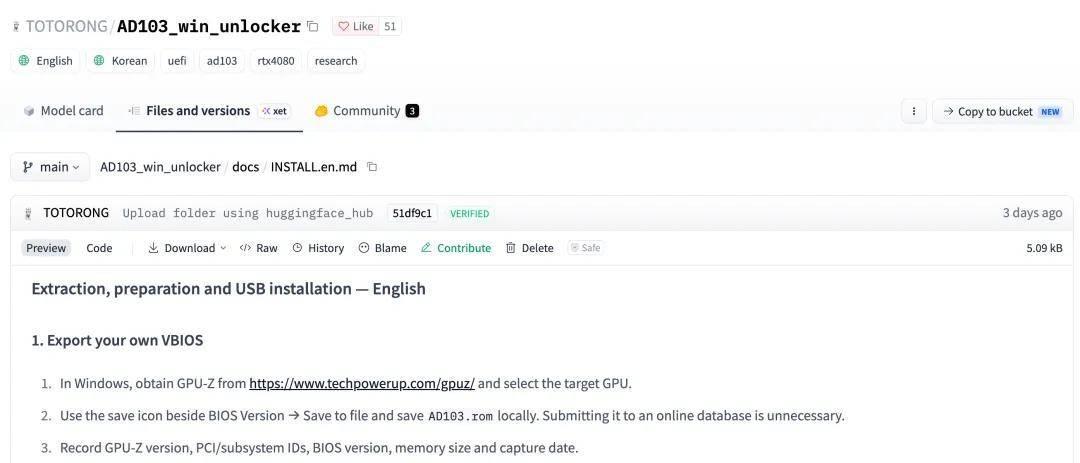
一周之内,战线迅速扩大:40 系有了 gpu-unlock-ada,2018 年的 2080 Ti 有了 turing-unlock,Windows 侧出现了基于 UEFI 的实验性版本,连 RTX 20/30/40 三代都齐了。而据快科技等媒体报道,英伟达在 50 系(Blackwell)上已经从硬件层面加固了安全机制——这场解锁狂欢,基本是 20~40 系老卡的「末代福利」。知乎微博
「翻倍」的真相:三层数据差距很大
这是全文最重要的部分。网上的数字分三层,一层比一层缩水,但也一层比一层接近你的真实体验。
第一层,底层指令吞吐,也就是传播最广的「翻倍」:
显卡 | 测试项 | 解锁前 | 解锁后 | 增幅 |
|---|---|---|---|---|
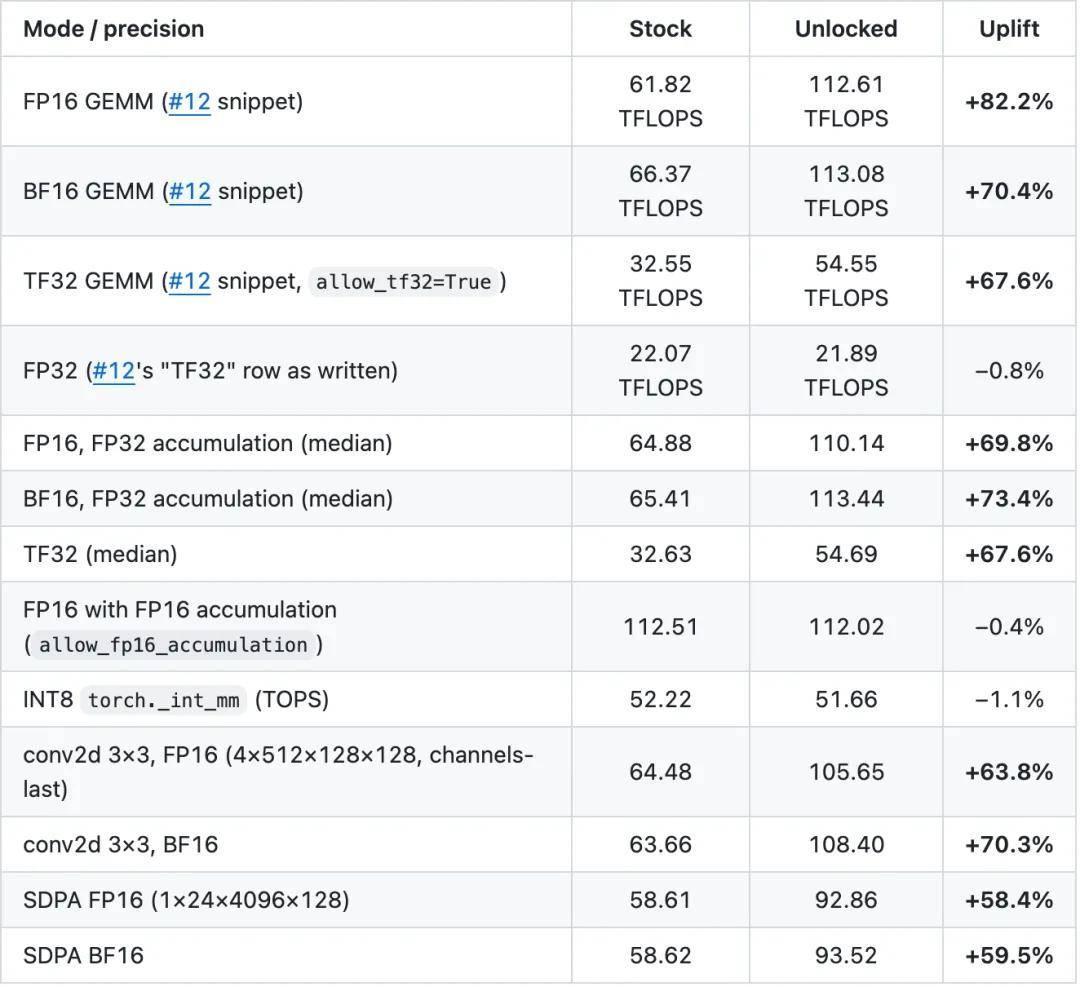
RTX 4090 | FP16 输入 / FP32 累加 | 165.6 TFLOPS | 331.6 TFLOPS | +100% |
RTX 3090 Ti | BF16 矩阵吞吐 | 87.5 TFLOPS | 157.4 TFLOPS | +80% |
RTX 3090 Ti | TF32 | 42.6 TFLOPS | 82.6 TFLOPS | +94% |
RTX 3080 10G | BF16(320W) | 65.4 TFLOPS | 113.4 TFLOPS | +73% |
RTX 3070 / 3060 | BF16 | - | - | +81% / +76% |
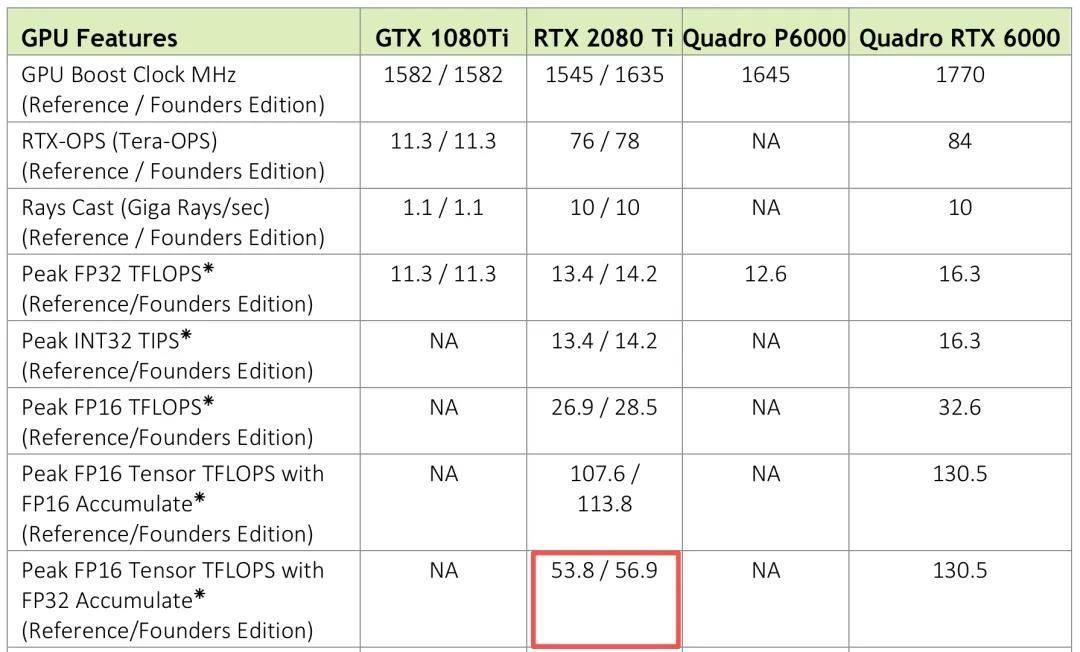
RTX 2080 Ti(22G 魔改) | cuBLAS FP16/FP32 | 55.7 TFLOPS | 91.4 TFLOPS | +64% |
注意这些数字都有独立复测背书,但同样要注意:INT8、普通 FP32、以及 FP16 输入 FP16 累加这几条路径本来就没被限速,解锁前后纹丝不动。「翻倍」只属于 FP16/BF16 + FP32 累加这一条路。知乎
第二层,标准矩阵乘法(cuBLAS):4090 的实测增幅收窄到 12%~34%,跟矩阵规模有关;4096×4096 规模下从 153.2 提升到 206.0 TFLOPS,约 +34%。知乎
第三层,真实 AI 任务,分化最严重:
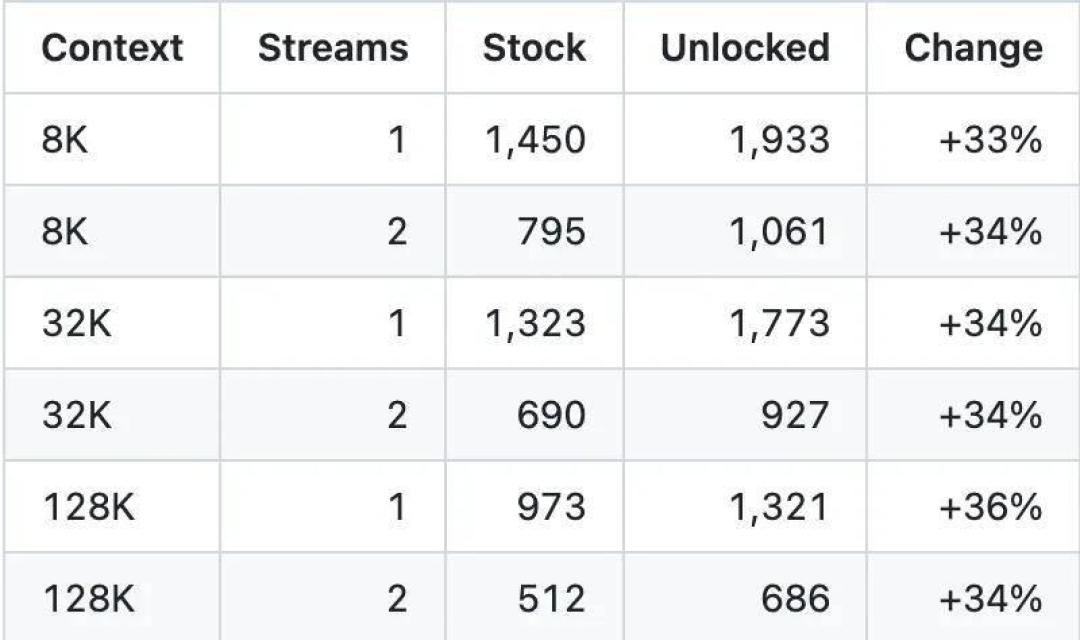
大模型推理的 prefill(预填充)阶段:有人用 vLLM 跑 27B BF16 模型,prefill 提速约 33%,首 token 响应时间缩短约 24%;双 3080 20G 的受控 A/B 测试也给出 +33%~36%。知乎
大模型推理的 decode(逐字生成)阶段:提升为 0。多个测试者一致确认,因为 decode 卡的是显存带宽,不是算力。你日常「和大模型聊天」的速度,一帧都不会快。知乎
训练:B 站有 3090 Ti 用户实测,YOLO 系列约 +5%,ImageNet 分类约 +15%,DINO 自监督约 +18%;也有扩散模型个例报告接近翻倍。
AI 出图:B 站视频给出的区间是提速 25%~55%。4060 Ti 16GB 上 ComfyUI 有「提升明显」的实测,但按项目官方说明,量化模型收益不大。这也是知乎评论区吵得最凶的点:量化路径完全不在解锁范围内。哔哩哔哩
游戏:无关。光栅性能、帧生成一帧不会多,「游戏帧率翻倍」的说法全是误传。
还有个容易被忽略的细节:功耗墙会把收益打折。有人把 3080 锁在 220W 测试,解锁后算得更快、更早撞墙,SM 频率从约 1720MHz 掉到 1330~1365MHz,理论 2 倍的收益实际只剩 1.5 倍左右。想吃满收益就得放开功耗墙,而放开又回到散热和稳定性的取舍上。知乎
谁值得上车,谁纯属白折腾
对照上面的数据,可以直接给判断:
值得折腾的:原生 Linux 用户,手里是 20/30/40 系卡,负载以大模型训练、微调、长上下文 prefill、FP16/BF16 精度的扩散模型出图为主。这条人群解锁基本是「白捡」,50% 以上的收益有实测背书。
先想清楚的:Windows 用户。目前验证过的是 EDK2 重写的 UEFI 方案,要在系统启动前动手,意味着要改 ESP 分区和引导记录,而且按整机写死配置、经过真机验证的机型 profile 只有个位数。风险倒不是烧卡——写错的后果是「开不了机」而不是「卡坏了」,重建引导的成本远低于换卡,保留原厂启动项随时能退回。但折腾门槛和风险都实打实存在。WSL2 用户注意:内核模块方案在 WSL2 里物理上跑不通(拿不到 BAR0),别在里面做实验。知乎
纯属白折腾的:主要跑 LLM 聊天推理的(decode 卡显存带宽,0 收益);ComfyUI 工作流已全面 INT8 量化的;纯游戏玩家;50 系用户(社区测试认为 Blackwell 这条路径本来就是全速,且漏洞已被硬件封堵)。
关于「烧卡」:B 站教程视频的高赞评论是「项目刚出不稳定,建议稳定后再用,防止烧显卡」。但翻遍原理和实测,这个担心缺乏支撑——工具不碰电压、不碰频率、不碰功耗墙,只改指令发射速率,有人同卡对照实测解锁后满载功耗约 318W、峰值温度 78~79℃,和解锁前几乎一样,计算结果逐位一致。真正需要谨慎的场景只有一个:Windows 上动引导分区。哔哩哔哩知乎
二手市场被点着了,等等党怎么看
这次解锁最现实的溢出效应,是给了 20/30 系老卡一个新叙事:「能解锁的 AI 折扣卡」。海外二手 3090 Ti 一周从 1000 美元炒到 2650 美元的传闻如果坐实,等于解锁消息直接改写了老卡的残值曲线。B 站评论区已经有人在喊「4090 又要涨价了」。
结合当下显卡市场的背景——5080 渠道价摸到 2 万、内存涨价传导、5060 Ti 刚经历三天掉 900 的回调——这波「老卡第二春」对买卖双方的含义完全不同:
手里有 20/30/40 系卡、又正好想出手的:解锁叙事是短期利好,二手报价可以硬气一点,但这种消息驱动的溢价持续性存疑,见好就收比赌长期更合理。
想捡二手卡跑本地 AI 的:3090 24G 这类「穷鬼尊严卡」的性价比逻辑被强化了,但注意你现在入场是在为别人刚发现的利好付溢价;如果负载以聊天推理为主,显存容量和带宽远比这次解锁重要,别为「能解锁」多花冤枉钱。
纯游戏玩家:这事和你半毛钱关系没有,反而可能要跟着承受一波老卡涨价,看到「解锁」字样的加价卡直接绕开。知乎
接下来盯什么
这个事还在发酵期,几个值得持续观察的信号:gpu-unlock 系列项目的 issue 区里更多型号的复测数据(尤其笔记本卡和 4060 Ti 这类中端卡);Windows UEFI 方案经过验证的机型 profile 会不会扩大;英伟达官方会不会回应、会不会通过微码更新封堵 20~40 系(目前截至发稿没看到官方动作,Blackwell 已经先堵为敬);以及二手 30 系价格的实际走势——如果一周后价格还站在高位,说明市场认可了「解锁卡」的长期叙事,而不只是凑热闹。
最后提醒一句:所有解锁操作都有变砖以外的隐性成本——时间、稳定性和二手残值的不确定性。数据看起来再香,先想清楚自己的负载到底卡在哪:算力、显存带宽,还是精度路径。这题答对了,再动手也不迟。
当前文章无评论,是时候发表评论了