这周的知乎 GPU 板块有点魔幻。9 月 18 号是《CUDA 和 Triton 哪个好用》,21 号上午是《triton 是否会冲击 cuda 生态》,同一天下午又杀出一条《是否应该放弃 Triton》。三连问,问的是同一群人:已经啃完 grid/block/thread、写过 reduce 和 GEMM tile、正打算往算子和 Infra 方向进阶的人。他们不怕 Triton 难学,怕的是"刚上手,工具就过气了"。
这份焦虑确实有来由——因为 NVIDIA 自己下场了。
先把坐标摆正:cuTile 到底是什么
2025 年 12 月,CUDA 13.1 引入 Tile 级编程模式,英伟达 GPU 计算官方账号把它称为自 CUDA 平台发明以来最核心的更新之一。 开发者直接用 Python 写 tile kernel,把数据切成块定义运算,不用再指定每个线程干什么。今年 3 月 GTC 上 cuTile C++ 补位,从单 Python 变成双语言;到 9 月这轮,官方又摆出 cuda-oxide 和 cutile-rs 两条 Rust 路线,SIMT 和 Tile 正式双轨。微博知乎
注意这条时间线传递的真实信号:不是"NVIDIA 要做个新 DSL 灭 Triton",而是 NVIDIA 亲手承认了 Bug Labs 那期刷屏视频说的裂缝——2017 年 Tensor Core 之后,硬件已经和"一线程一操作"的 SIMT 抽象错位了。 切 tile 这件事,从 2021 年 Triton 替你做,变成了 2025 年底 CUDA 原生替你做。哔哩哔哩
抽象层的战争,这才是"要不要放弃"系列刷屏背后的真问题。
这轮刷屏里,三个账算错了
误读一:cuTile 来了,Triton 要完。 恰恰相反。社区这周讨论里反复出现的一条事实是:NVIDIA 把最新的 CUDA Tile IR 做成了 Triton 的后端。 在《是否应该放弃 Triton》那条回答里,这个动作被概括得很直白——你写的 Triton 代码,改个环境变量,就能直接跑在最新的硬件上,性能还更好。 老黄这套打法,SemiAnalysis 那篇研报讲得直白:问题从"CUDA 护城河牢不牢"变成了"Agent 时代护城河怎么换打法"——前台用 Python 和低门槛 DSL 把不想学 C++ 的 AI 研究员"招安"进自己的硬件迭代节奏,比封杀划算得多。知乎知乎知乎
误读二:Triton 已经全面强过 CUDA。 "代码量少 75%、性能局部反超"这个被转烂的数字,出自微软,口径是规整算子——矩阵乘、注意力这类 tile 友好的活,Triton 确实是降维打击。 但同一批讨论里也有反例:某些不规则 HPC 算子,编译器"脑补"不过来、寄存器疯狂溢出,有实测比朴素 CUDA 还慢十几倍。两句话拼起来才是全貌:规整算子归 tile DSL,不规则算子是 CUDA 最后的堡垒。只看到任何一半就下结论的,都是被信息流喂偏了。知乎
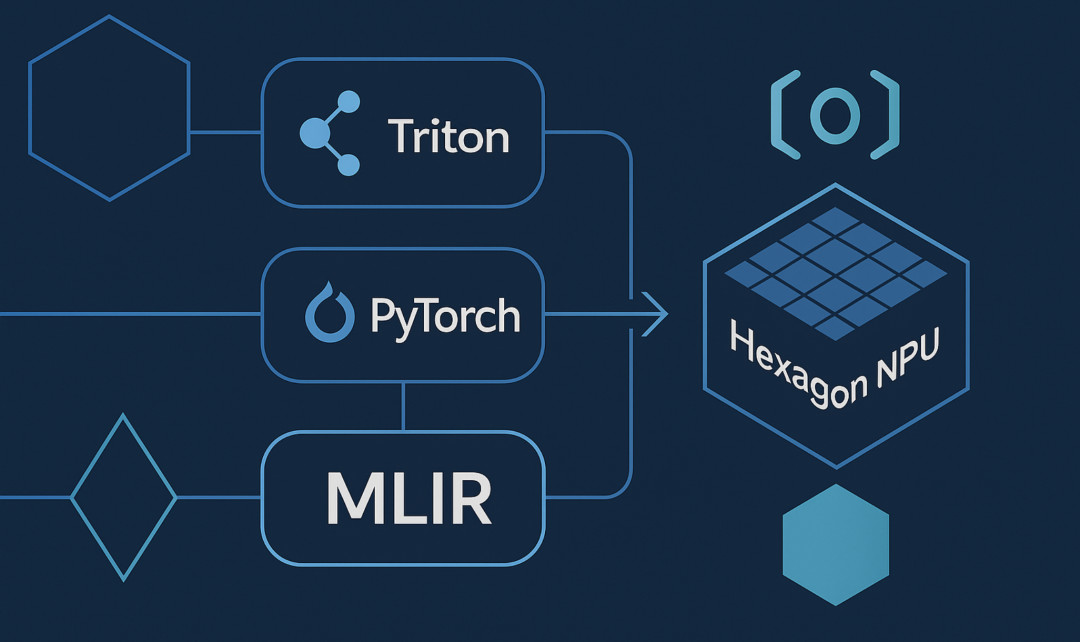
误读三:CUDA 护城河已破。 结论强度不能超过证据。Triton 编译的最终产物默认还是 NVIDIA 的 PTX——这谈不上破防,更像是换了个入口继续进城。 真正在凿墙基的是多后端这条线:triton-ascend 基于上游 Triton 模板开发,FlagTree 把各家芯片的 Triton lower 路径整理成谱,这些后端是绕开 PTX 直接落到自家硬件的。 连高通都开源了 Hexagon-MLIR 编译软件栈,支持把自定义 Triton 内核直接编译部署到自家 NPU 上运行。 护城河的分歧点已经从"你用哪门语言写 kernel"挪到了"你的代码最终在哪份 ISA 上落地"——这才值得深度玩家盯,而不是"要不要弃坑"的情绪贴。知乎知乎微博
三张投入清单:你的功夫该花在哪
CUDA 老兵(SIMT 熟、shared memory 门儿清):最不用慌的一档。cuTile、Triton、TileLang 的 tile 思维对你只是换视角,一周能上手。真正该补的是编译器行为这一课:Triton 的 autotune 搜的是你手写的 configs 列表、版本间性能会漂,笔记圈现在的通行做法是版本 pin 住、升级走全量 benchmark 流程。 抽象层替你干活之后,会调编译器比会写 kernel 更值钱。知乎
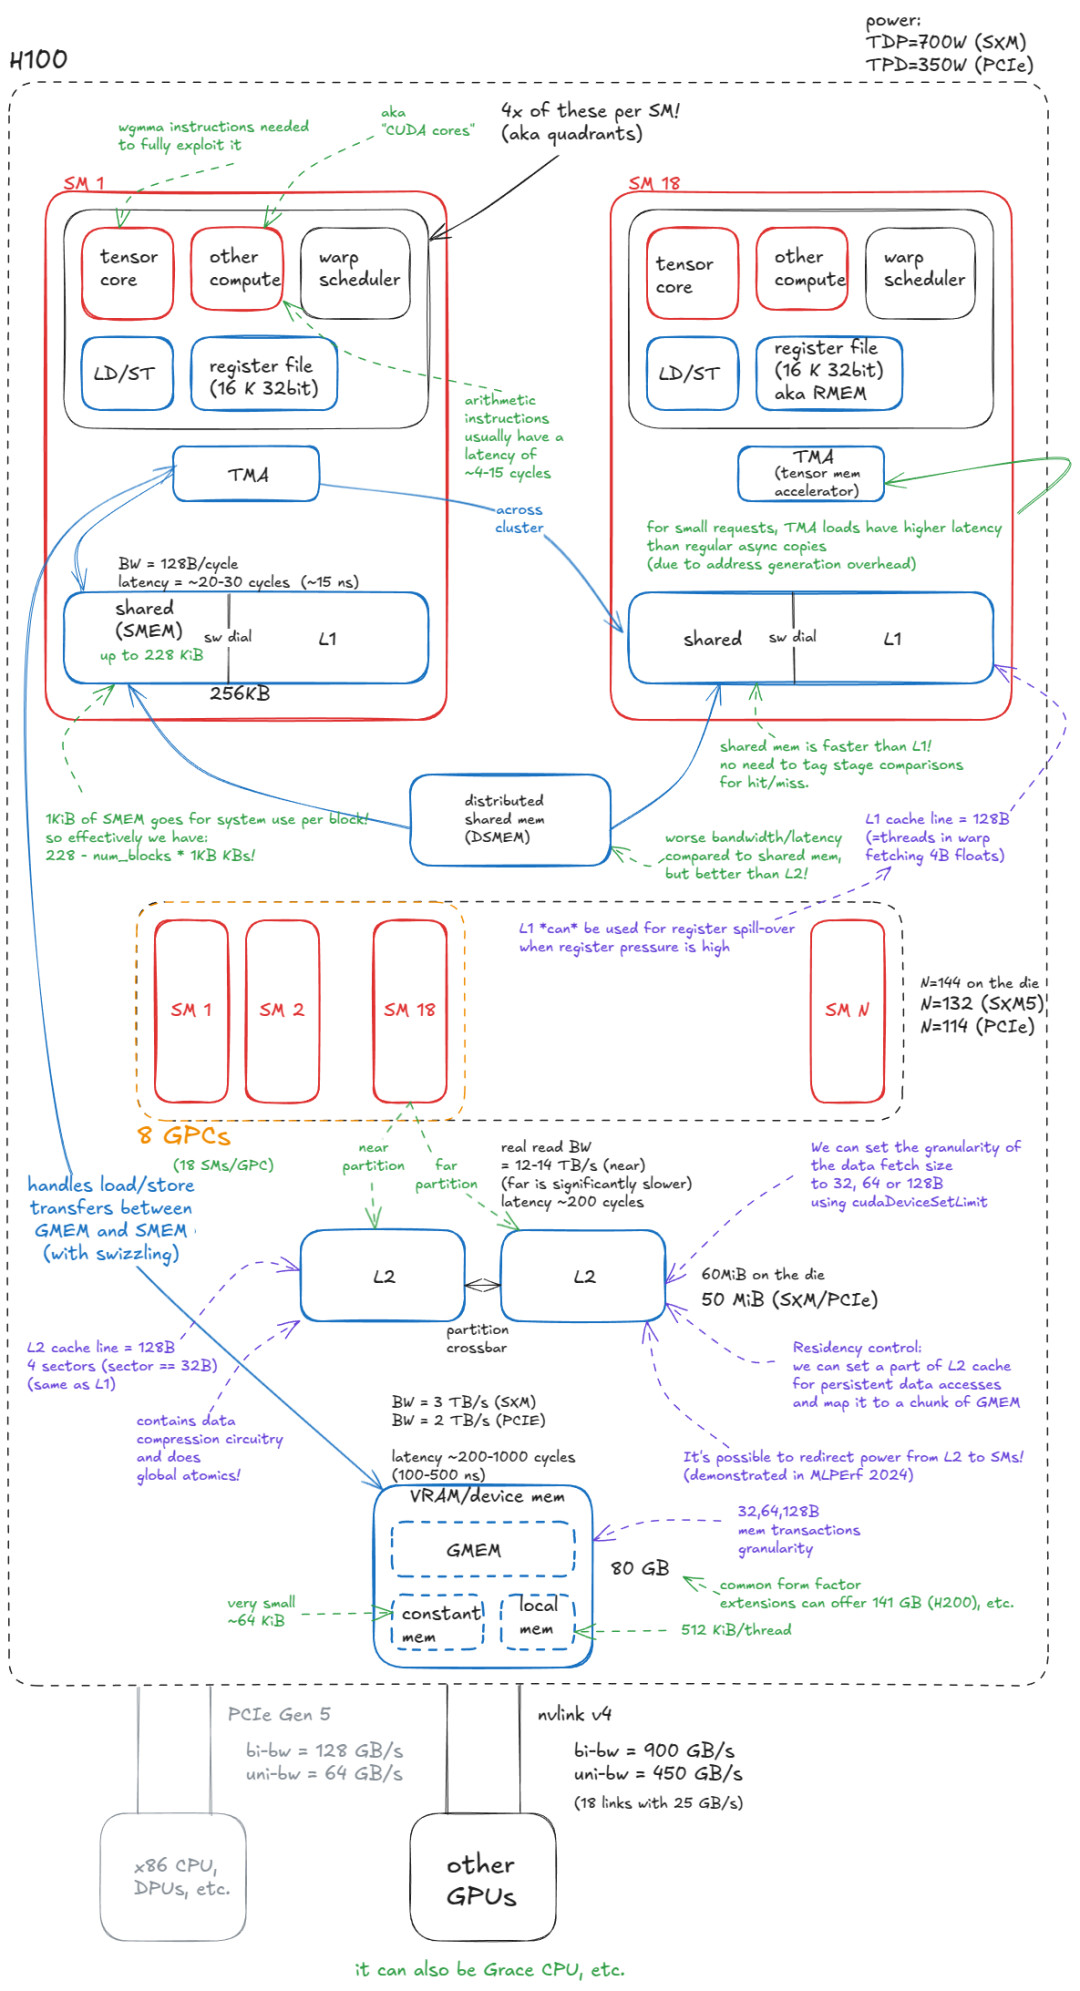
Python 系新手(没写过 CUDA,想直接 Triton 出活):你的风险不是选错工具,是黑盒。tl.dot 只是"自动路由到 Tensor Core",dtype 和 shape 不匹配就静默退化到 CUDA core 路径;attention 里 qk_scale 要乘 1/log(2) 改用 exp2,才有 GPU 上的快速近似;LayerNorm 反向那把锁,底下就是 atomic_cas 一条硬件指令。 建议按"wmma / mma.sync / Triton 三层 API 落到同一条 HMMA"的顺序把底层看穿一次——看穿一次,之后 cuTile、TileLang 随便出,对你都只是换语法糖。知乎
国产算力方向:Triton 目前是一份代码能对着多家后端写的现实路线。该盯的不是"CUDA 会不会死",而是 triton-ascend、FlagTree 这条线上各家 lower 路径的差距收敛到什么程度——这才是国内算子岗简历上真正在涨价的部分。
接下来看什么
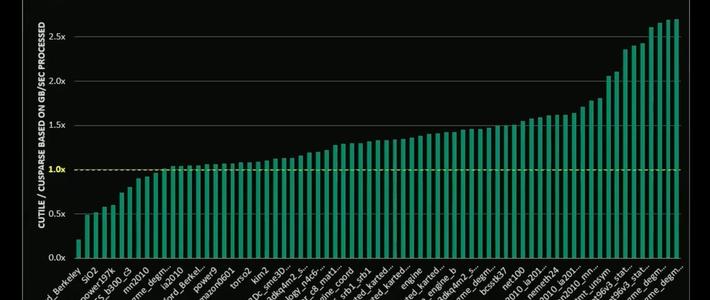
CuTile-Bench 这套独立评测基准已经开源,用它把 cuTile 和 Triton 在同代卡上的差距跑出分布,比引用任何一方的 demo 都硬。 社区已经有人报"用 CuTile 写的 FlashAttention,forward 可以达到 FA4 的 102%",目前是单例,别当结论。 NVIDIA 的 Tile IR 和 Triton 上游的跟进节奏,是判断"双轨合流还是分家"最直接的信号。知乎知乎
一周三条求助帖,本身就是这个切片最真实的情绪指标。证据能说到哪就说到哪:抽象层之战刚开场,"谁替代谁"没有任何一方能下结论——但"该在哪下功夫"这件事,这周其实比上个月清楚多了。