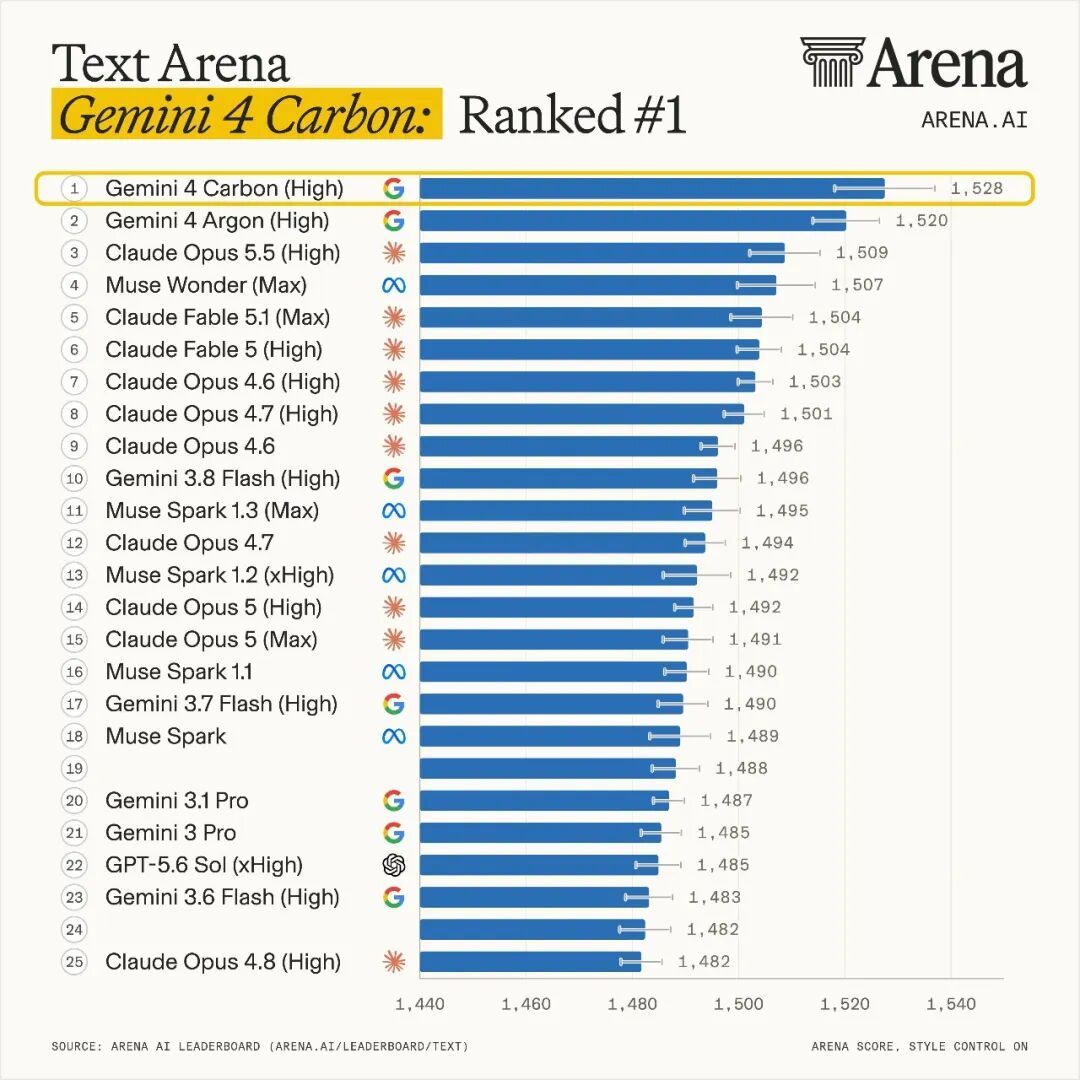
上周你可能刷到过这条新闻:谷歌发布Gemini 4 Carbon,在Artificial Analysis最新智能指数上拿下59分,把Claude Opus 5.5(58分)和GPT-6 Astra(57分)都压了下去,时隔半年重回全球第一。朋友圈里一片"谷歌翻身了",有人已经开始琢磨把编程助手的默认模型换掉。新智元字母AI
先别急。这事对AI编程用户来说,有三个细节比"屠榜"重要得多。
第一,写代码这件事上,它其实没赢。
综合榜59比58,确实反超了。但翻开Artificial Analysis专门衡量AI编程能力的Coding Agent指数,画风就变了:Carbon 59分,Claude Opus 5.5是62分,最贴近真实编程场景的FrontierCode测试它同样落后。知乎微博
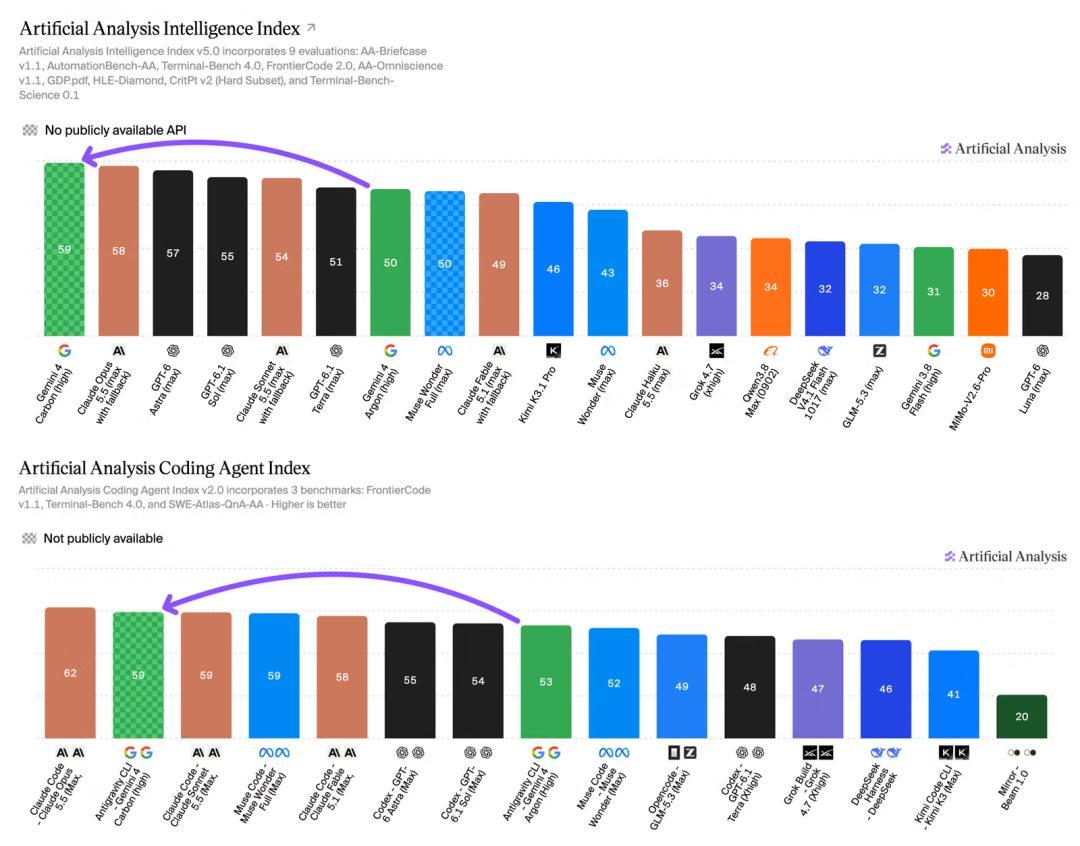
一句话总结:谷歌追上来了,但恰恰在"帮你写代码"这个赛道上,还没追平。榜单总分和干活能力,是两码事。
第二,你现在根本用不上。
官宣写得很清楚:首批只开放给一小部分网络安全防御团队,再通过Fairwind计划分阶段扩量给受信伙伴,普通开发者和企业"尽快"开放——具体日期,没有。知乎字母AI
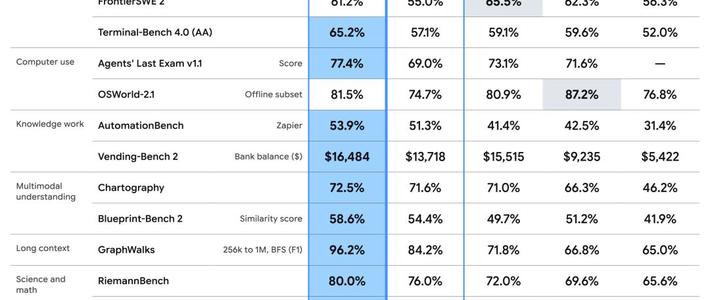
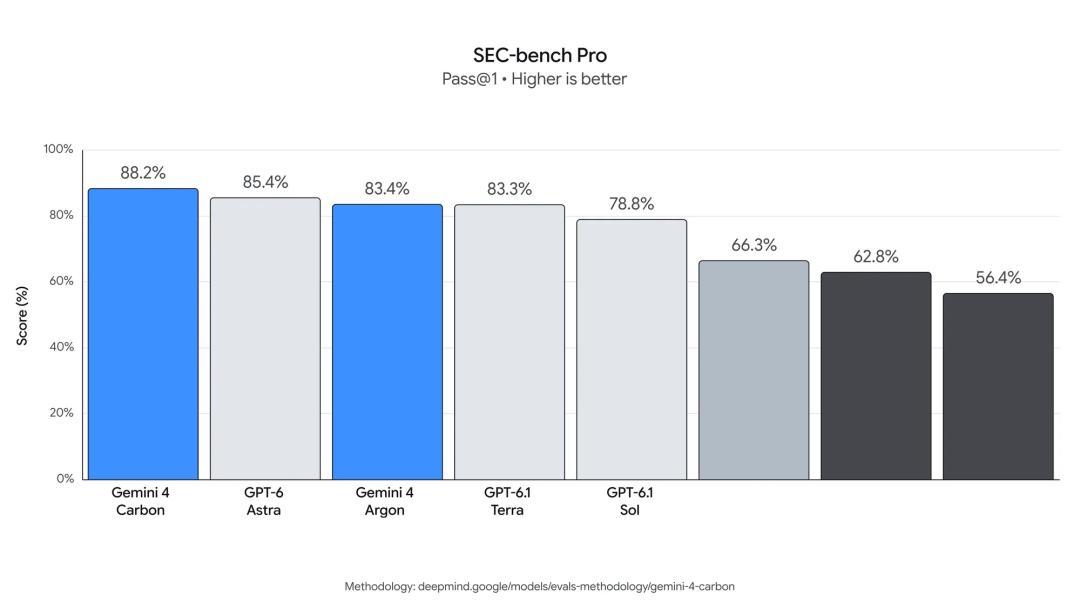
为什么这么抠门?因为Carbon在安全测试里表现太猛:找漏洞的SEC-bench Pro拿了88.2%。验证漏洞的ExploitGym冲到54.8%,把Opus 5.5的34.5%远远甩在身后。这种"找洞、验证、打补丁"一条龙的能力是双刃剑,谷歌选择先给防御方,队列排到普通人手里还得等。字母AI新智元
Hacker News上有个损评很传神:这就像有人炫耀"我有个女朋友,只不过她在另一所学校,你们都不认识她"。
第三,半价很香,但有代价。
价格确实是杀手锏:引入期每百万token输入2美元、输出10美元,约为Claude和GPT同级模型的一半。谷歌内部测试里,它能连续跑好几天,在大型代码库里反复尝试不同方法定位、修复复杂bug,听着像"数字员工"到岗。新智元字母AI
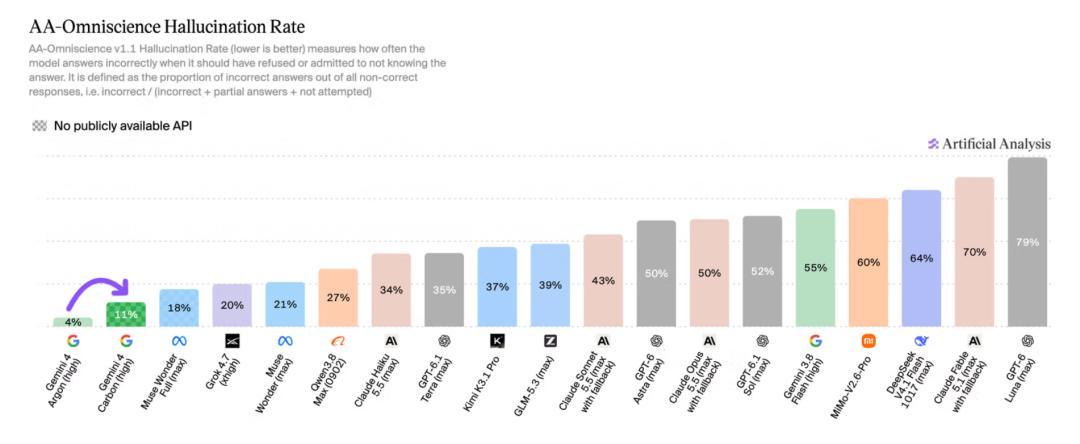
但早期测试者也泼了冷水:Carbon比上一代Argon慢2到4倍,法律研究任务平均要跑52分钟。知识诚实度评测里,Carbon的幻觉瞎猜率是11.4%,虽低于对手的50%,但比上一代Argon的4%明显上升。变强了,也变慢了——赶工期的开发者未必等得起。字母AI新智元
那普通人现在该干嘛?
三件事。一是别看到"榜一"就切默认模型,编码场景Opus 5.5这类的领先还在,榜单测的从来不是你的代码库。二是可以蹲一个信号:谷歌正在做Carbon的蒸馏版,准备塞进10亿用户级的产品里。三是记住这轮价格战的逻辑,半价首发抢的是入口,谁先用顺手谁的团队就迁不动了。等各家真打起来,省钱的是我们。字母AI知乎
模型拿了第一,作业还没发下来。榜可以追,生产环境别抢跑。