10月下旬,科技UP主谈三圈的一条视频上了热门:《机密不能上云,芯片厂怎么用AI?》,几天里播放量13万+、点赞4000+。视频开头的问题相当冷门:制造芯片的公司,也需要算力吗?哔哩哔哩
答案藏在评论区。有人自嘲工艺配方不能出厂,只能用脑子记;也有人直白爆料指令集和源码被偷拿出去喂给GPT分析。更硬核的是保密口径,涉密GB10一体机要物理拆除WiFi模块,因为无线信号会被空中截收,光关开关不算数。哔哩哔哩知乎
数据出不去,又想让AI进工作流——这就是本地部署一体机这波走红的原因,也是这期视频主角H3C LinSeer MegaCube的存在理由。
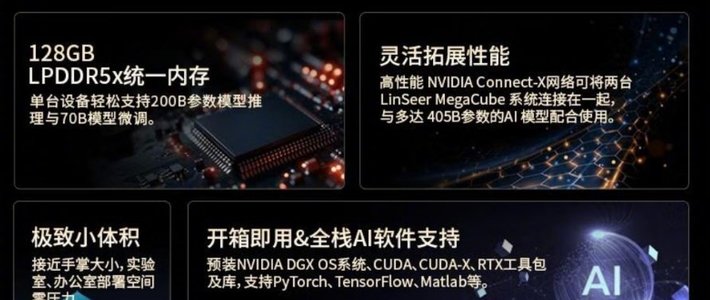
它是什么?一台桌面级AI超算一体机:英伟达GB10 Grace Blackwell芯片、128GB统一内存、预装DGX OS,最高能跑2000亿参数大模型,售价36999元。微博
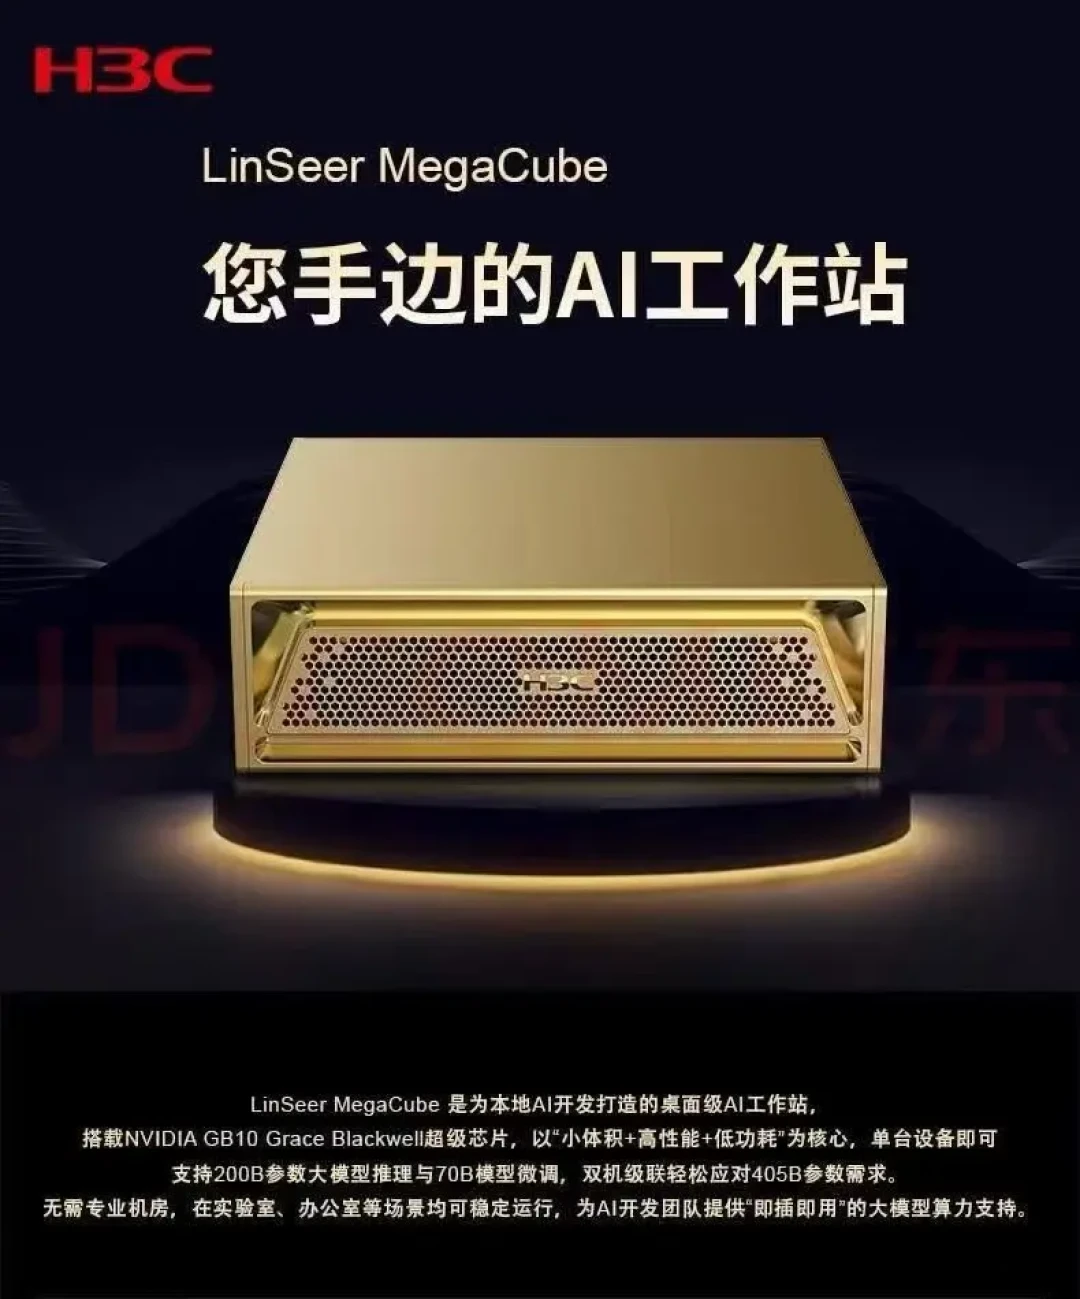
评论区最高赞的留言不太客气:“这不就是DGX Spark的OEM版本嘛,硬盘才1TB有点抠”(71赞)。平心而论,核心硬件确实是同一档位:都是GB10,出厂甚至直接预装英伟达DGX OS。只看到这一层,MegaCube确实不是新闻。哔哩哔哩
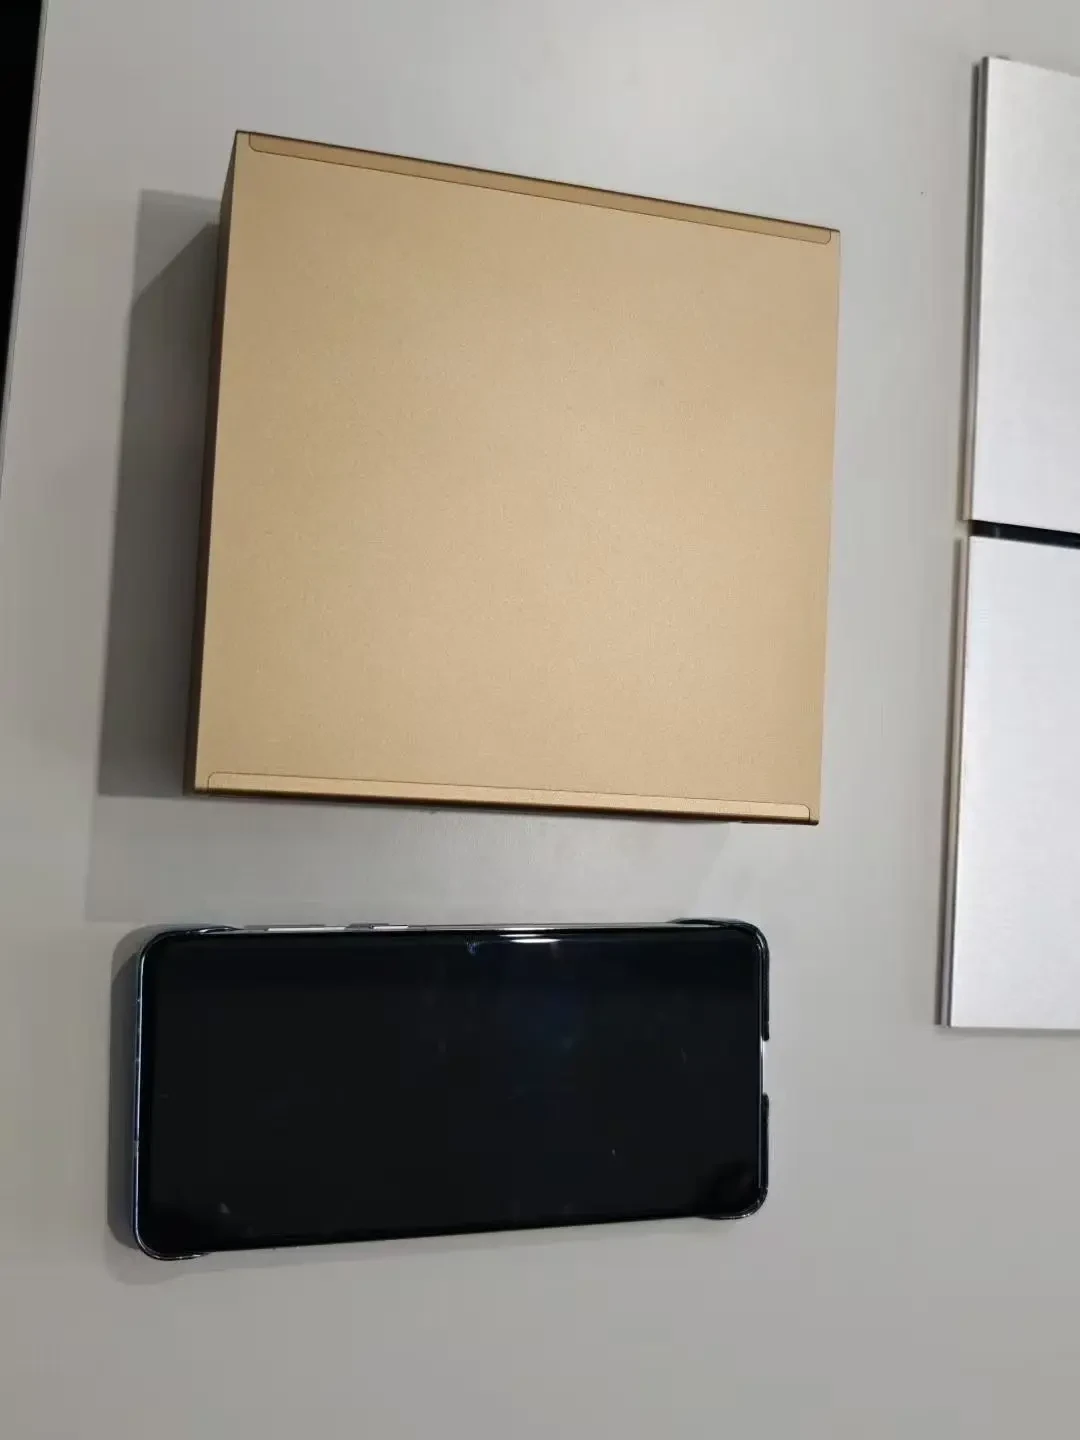
但新华三真正的手艺不在“盒子”,而在把盒子连起来。官方已实测多台RoCE级联,让Qwen3-Coder 480B大模型在桌面流畅运行。10月28日,官方账号又自测4台MegaCube协同运行DeepSeek-V4.1-Flash-1017,8路并发总吞吐达171.66 token/s。官方战报还写明:26万token长文找回目标信息、17项基础功能逐项通过。桌面单机变成部门级小集群,这正是网络厂商的老本行。哔哩哔哩微博小红书
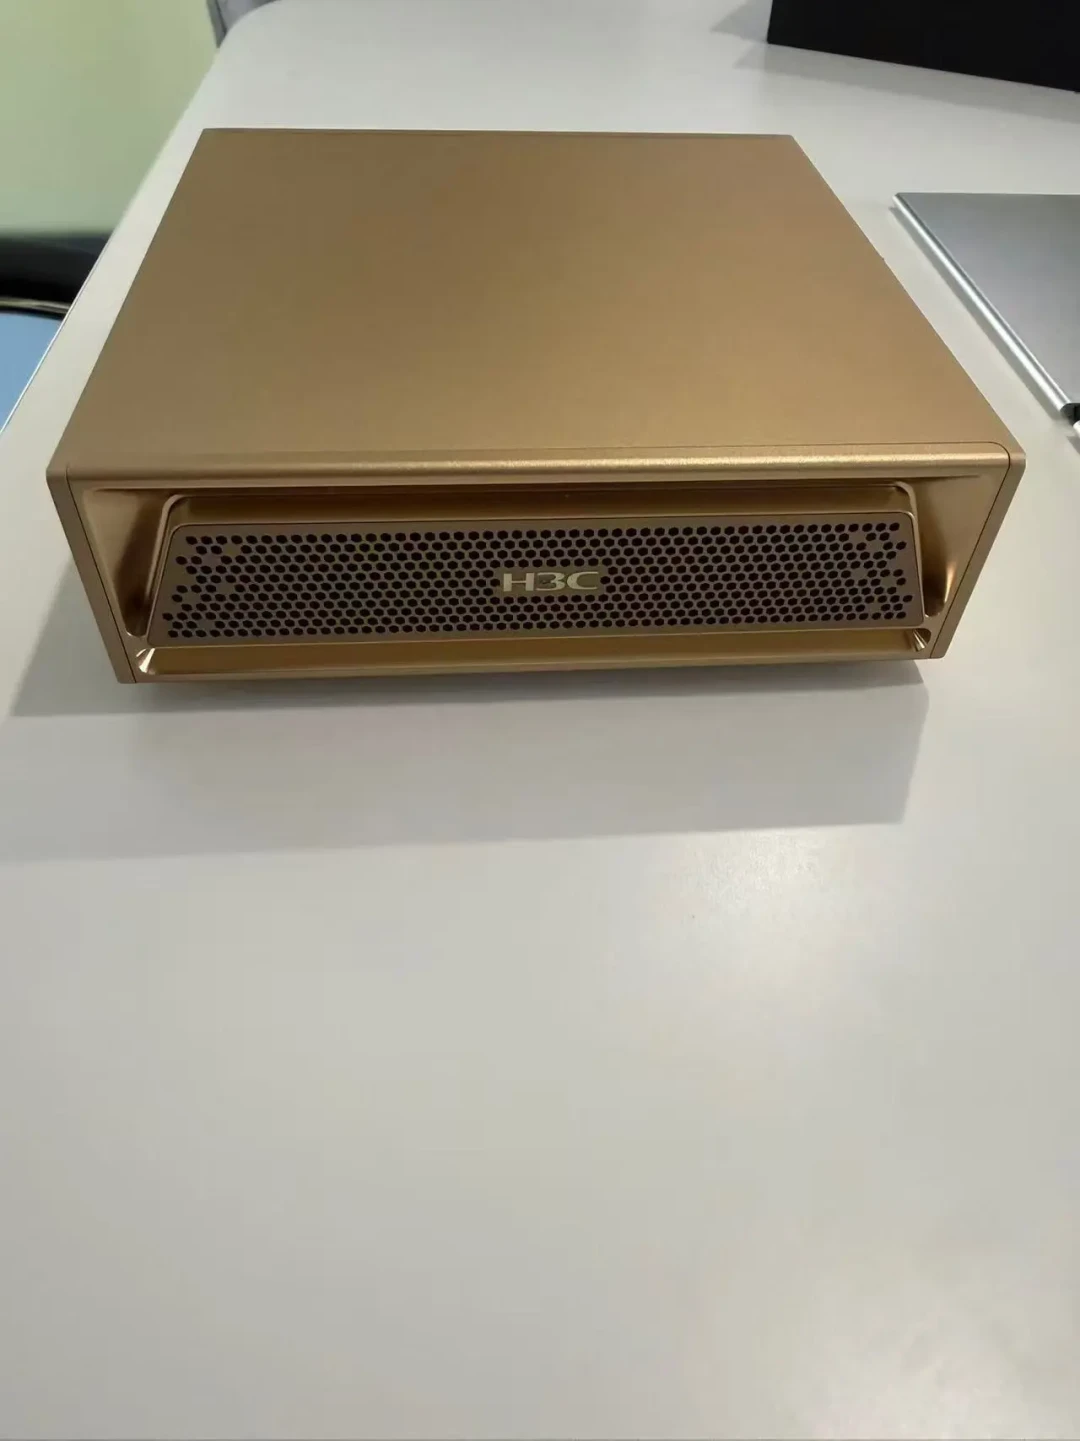
质疑也得听,同一条视频下的高赞评论点得很透:正经芯片厂花几百万就能部署一套正经AI节点,小盒子进不了产线。没关系——官方对这台盒子的定位本来就不是产线,而是“本地大模型部署和应用开发”:写代码、做内容、调试模型,数据不出机房。171 token/s谈不上快,但数据不出界,本身就是有人愿意买单的理由。哔哩哔哩小红书
而这颗小盒子只是新华三AI棋局的“下限”。9月底,新华三发布UniPoD S81000 X1超节点:单个Scale-Up域最多支持40张国产加速卡,任意两卡之间的P2P带宽可达448GB/s。云栖资料里还有个更扎心的数字:万卡集群里,数据IO瓶颈导致GPU空等时间占比可达40%以上。从桌面到万卡,新华三干的都是同一件事:让算力别把时间花在等数据上。知乎36氪
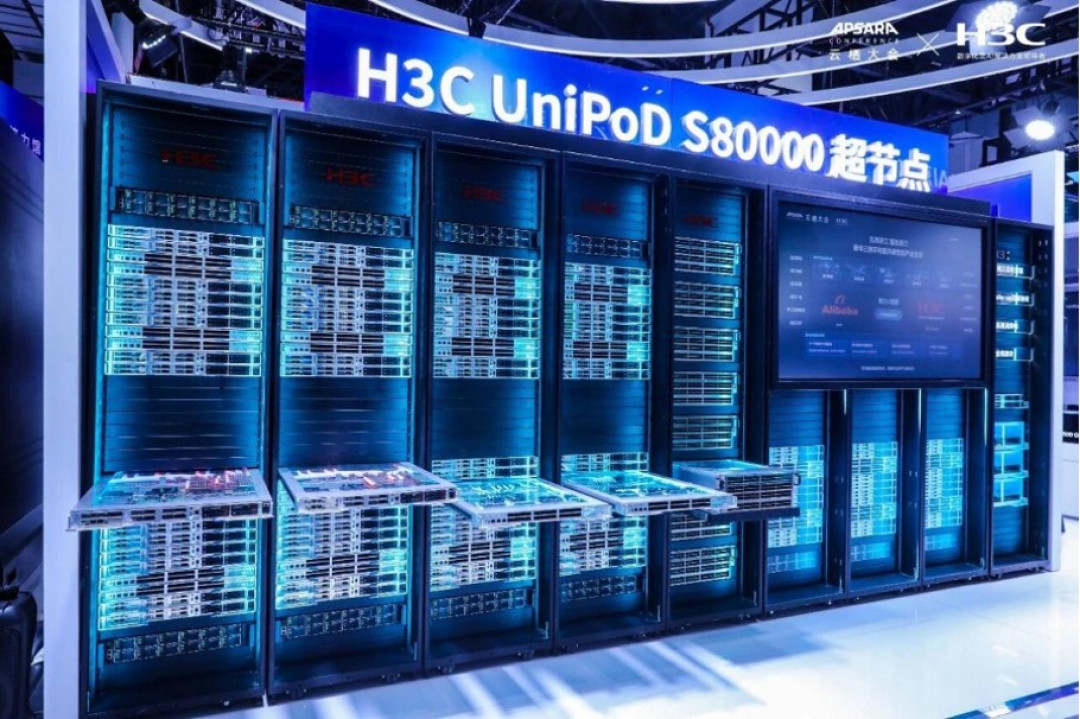
如果你就是管企业网络的工程师,不妨这么读这个信号:AI落地卡脖子的下一站未必是GPU,而是GPU背后的RoCE网络和互联架构——那是你的主场。