10 月 29 日,法国公司 Mistral 把旗舰模型 Mistral Large 4 的完整权重放上 Hugging Face,发布前后反复强调的叙事是“编程智能体与中国模型并列第一”,甚至“性能超过中国对手”。但把独立评测摆回同一张榜,位置完全不同:Artificial Analysis 智能指数 v5.0 只给 26 分,21 个开放权重模型中排第 9。 也就是说,跑分数字大多不假,“超过中国 AI”却是精心挑选口径后的结果——它真正超过的是分项冠军和每任务账单,不是中国开源模型的总分。知乎
它到底宣称“超”了什么
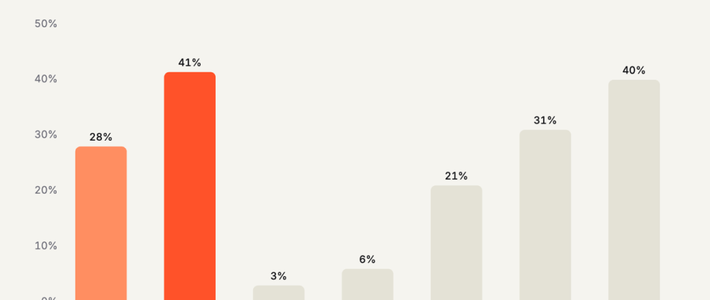
10 月 6 日公开预览时,Mistral CEO 的说法还相当克制,强调超过的只是部分领域的部分模型。 三周后放出的开源版在预览版基础上做了额外强化学习,官方成绩单集中在三条线:编程智能体评测中取得与 GLM-5.3 基本持平的得分,同时每项任务平均 Token 消耗减少 47%。 Terminal-Bench 4.0 则从预览版的 28% 提到 41%,官方称领先参评的其他开放权重模型。知乎知乎知乎
同是“网络安全”,两把尺子结论相反
最有意思的细节是,同一个指标换个尺子,结论就掉头。在官方发布材料自己引用的 Artificial Analysis Cyber Index 图上,Mistral Large 4 得分为 51%,而同一张图里 DeepSeek V4.1 Flash 是 57%、小米 MiMo-V2.6-Pro 是 56%,都排在它前面。 但在另一项自报的 CyberGym-E2E 里,它又变成与 MiMo 并列、领先 DeepSeek——“网络安全超中国”取决于允许官方引用哪张图。预览期的宣传同样经不起直接对比:预览版当时在旧版指数上得分为 38,进入全球较强模型行列。 开源版在新版 v5.0 下的 26 分与它不是同一把尺子,发布方不会提醒这一点。值得肯定的是,模型卡至少承认:这是西方开源最高分,但领先的中国开源模型分数更高。知乎知乎知乎
真正的卖点是账单
把分数放到一边,官方口径里最扎实的是成本:按每任务成本算,Mistral Large 4 是 2.06 美元,GLM-5.3 是 5.00 美元。 对连续跑几小时的编程智能体,省下的 token 比 6 分差距更能决定账单。钱的故事也在配合叙事:9 月 Mistral 完成 30 亿欧元融资,投后估值超过 210 亿欧元,三星电子领投、阿斯麦跟投。 用 3800 张英伟达 Grace Blackwell 在欧洲自建数据中心从零训练、三年只融约 60 亿美元的账本,被门施包装成“每美元买到多少分数”的追赶叙事。知乎知乎
“开源”两个字也有折扣
这次放权重用的是改过的 MIT 许可:下载可商用,但把模型当托管 API 卖要另拿商业许可。 所以更准确的说法是“开放权重”,不是传统意义上的开源。部署门槛同样不低:官方部署示例是单机 8×B300 跑 FP8 权重,量化版面向 Blackwell GPU。 有开发者实测 FP8 双卡 4090 勉强可运行,但约 70GB 的显存门槛会把多数团队挡在门外。 跑分好看,不等于养得起。知乎知乎知乎
水分到底有多少,可以拆成三层:总分落后是真、分项并列是真,但“超中国 AI”的印象是话术拼出来的。关键自报成绩包括 Terminal-Bench 41%、Cognition 私有基准 FrontierCode 领先等,截至发稿,这些数字均为 Mistral 官方口径,第三方尚未全部复现。 门施 11 月 3 日仍在为这套叙事补充动机:欧洲如果只搞工业 AI 应用、把最核心的“前沿大模型”留给美国和中国去做,就会掉进“彻底的陷阱”。 对用户来说,能下载不等于能用得起。 真正值得盯的,是接下来几个月独立评测能否复现那 41% 的编程分——复现得了,这是欧洲拿下的第一张开源头部入场券;复现不了,这就是一次贴着断供保险卖出的定价策略。知乎微博知乎