Anthropic在IPO路演里讲了一件以前没人敢当众宣布的事。11月10日,Claude母公司正式启动上市路演,同步上线42分钟路演视频与57页路演PPT,计划11月18日定价、11月19日在纳斯达克挂牌,股票代码ANT。 路演中,联合创始人兼首席算力官Tom Brown披露:前沿模型Claude Mythos Preview在基本无需人工干预的情况下,仅用约3天就完成了核心GPU底层计算内核的移植与重写,把Claude模型跑在了AMD的旗舰GPU上。 而在传统做法里,把大模型适配到一款全新异构芯片平台,通常意味着数十名顶级编译器与高性能计算工程师花费6到12个月的攻坚周期。知乎36氪IT之家
先把结论摆正:这不是CUDA在3天内被替代,英伟达的代码也没有一夜之间失去价值。被动摇的是围绕代码建立的那道经济学防线——芯片切换成本。过去客户明知对手纸面参数不错仍多年不换卡,因为迁移要付出一整年稀缺工程师工时和停摆风险;当这笔开销被AI压缩到几天,换卡的经济账就必须重算。
3天完成了什么,没完成什么
路演图表的附注把成绩划界划得很具体:Mythos Preview达成的是让一款Claude模型的提示词处理阶段(Prefill),在配备288GB HBM3E显存的AMD Instinct MI355X上达到可用性能,过程中几乎100%的底层内核由Claude独立移植或编写。36氪
边界同样清晰。Prefill负责并行吞入全部输入上下文并建立KV缓存,是高度计算密集型环节,恰好是MI355X大显存发挥的空间;而后半段逐字生成的Decode阶段,更依赖多卡互联带宽与网络通信延迟。路演没有宣布在Decode上达成同等结论,也没有给出吞吐量基准和与CUDA环境下的性能损耗对照——这毕竟是面向投资者的自述材料,目前尚无第三方跑分可以交叉验证;从单机架实验到万卡集群的生产级稳定运行,中间还隔着明确的工程鸿沟。
内核移植为什么曾是"一年的活"
CUDA诞生于2006年,二十年里英伟达围着它建成了计算库、编译链、性能分析器和数百万开发者的使用习惯,主流框架长期默认CUDA优先。真正的难点藏在架构细节里:英伟达以32线程的Warp调度,AMD的CDNA架构用64线程的Wavefront,分支预测和掩码计算逻辑要全面重做;片上共享内存、寄存器容量、访存机制各不相同,算子代码稍有偏差就引发流水线停顿或显存溢出。36氪
AMD并非没有牌:开源的ROCm平台长期提供HIP、HIPIFY等代码转换工具,行业内还有Triton这类跨硬件DSL,但自动化工具通常只能解决"语法能编译",遇到深度优化的复杂算子,生成代码效率大幅缩水,最后还是得专家团队花数月逐行排查汇编。
对已经在英伟达硬件上部署大量模型的企业来说,更换计算架构并不是简单换一张显卡:软件迁移、性能优化、工程团队培训、系统稳定性验证,每一环都可能让项目停摆一年。知乎
3天是怎么做到的:Anthropic出模型,AMD出工具
这套打法今年7月就有预演。AMD向Anthropic送来一台MI355X机架,一名工程师把机器控制接口接入Claude、布置好硬件适配任务,让系统在周末无人值守运行;周一回来看监控时,工程师惊讶地发现,模型在新硬件上的性能曲线已在AI自主调优下稳步攀升,AMD方面一度想派人帮忙,得到的答复是不用、已全部搞定。36氪
更关键的是AMD把"AI能读"做成了基础设施:在Advancing AI大会上发布面向Claude这类Agent的ROCm工具箱,每代GPU公开指令集并提供AI可读的ISA手册,Agent可以自己读硬件白皮书、调用ROCm命令行在真实机器上测试;自动调优系统Hyperloom会自己跑基线、找瓶颈、生成定制内核,现场演示把MiniMax M3的输出速度提升了38%,还能一次跑过1.4万个模型,把结果沉淀成可复用经验。新智元
两家公司的商业绑定已经落地。7月22日宣布的深度合作里,Anthropic计划在AMD Helios系统中部署最高2GW的Instinct GPU,首批1GW计划2027年上半年启动。 AMD同时承诺向Anthropic进行最高达50亿美元的战略股权投资,双方明确要用Claude直接加速ROCm软件栈的开发。 7月的周末轶事与11月写进路演的"3天",口径虽都是公司自述,但时间线显示这不是偶发,而是正在被工业化的流水线。新智元36氪
护城河之危,分歧到底在哪
分歧真实存在。硅谷投资人Marcelo P. Lima直言CUDA护城河已经消失;一线工程师的反驳同样在理:跑通部分推理算子,与支撑万卡集群在大规模生产中稳定运行,中间依然隔着巨大的工程鸿沟。 传播这条消息的帖子评论区里,整体态度比兴奋更谨慎,其中就能看到不太敢上生产环境的直接表态。 这不是技术层面的反驳,但它指出了同一个落差:跑通,和生产,是两回事。36氪微博
公允的判断是把"护城河危机"拆成两个命题。“AI已经克隆出另一个CUDA”,目前没有证据;“跨出CUDA生态的工程转换成本正在数量级下滑”,现在有了3天案例、Agent工具链和GW级合作三样东西的共同支撑。英伟达真正要守的从来不是几段算子代码,而是那个让所有人不愿动手的高昂价码——价码被AI压低之后,硬件参数表上的性价比,才开始真正兑现成订单。
一个耐人寻味的细节
值得注意:在这轮上市中,英伟达和AMD同时出现在了260亿美元基石私募的名单上。 给"拆自己护城河"的故事做背书的,恰恰包括护城河的主人——资本对多芯片算力的未来,已经提前出了一份价。知乎
对买算力的人意味着什么
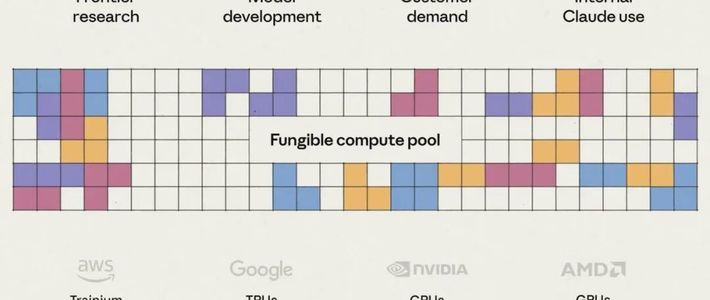
Anthropic的顶层蓝图是把不同厂商、不同架构的芯片当成一个可互换的算力池,其模型已宣布可在英伟达GPU、AMD GPU、谷歌TPU、亚马逊Trainium四大芯片家族上混合训练与推理,按任务特性分流,并开始跳过云厂商打包、直接租赁裸芯片。 路演材料还称,以"收入除以算力和基础设施开支"衡量的经营效率自2025年一季度以来提升了超过4倍——两个数字都出自公司口径,但至少说明异构迁移不是停在路演的口号。36氪
这条路的参照系也不止一家。今年10月初,媒体披露DeepSeek开源了适配华为昇腾的全套底层算子,实现和英伟达算子一一对应,一套代码两边都可以跑。 一个在存量代码上动手,一个把硬件接口直接对AI开放,这场实验的启示同样属于正在自研定制芯片的云巨头和推进软件生态的国产AI芯片厂商。 芯片竞争力的评价表上,"AI能不能读懂它、调用它"正在和峰值算力、显存带宽摆进同一栏。微博36氪
接下来几个月有三个可观察的信号:Anthropic是否会公布AMD平台上的正式基准测试,首批1GW MI450部署能否如期在2027年上半年上线,以及ROCm的生产采用能否从Anthropic扩散到其他大客户。CUDA的护城河不会在3天里消失,但水位第一次变得可以测量。