

同一个办公室,现在有两套活法。
你:定方案、卡架构,让AI实现,再逐行拉diff看完才敢合入。同事:只跟AI对齐Spec和约束,搭好harness自动验收,代码从头到尾基本没碰。两种活法被摆上知乎,评论区一句话很扎心:“看了一圈,感觉大家都在黑盒作业。” AI写的代码,光靠Spec+Harness验收到底够不够?Review还要不要做?知乎
Review没死,死的是逐行读代码这种干活方式。已经"放得手"的团队,不是不看质量,是把"看什么"换了。
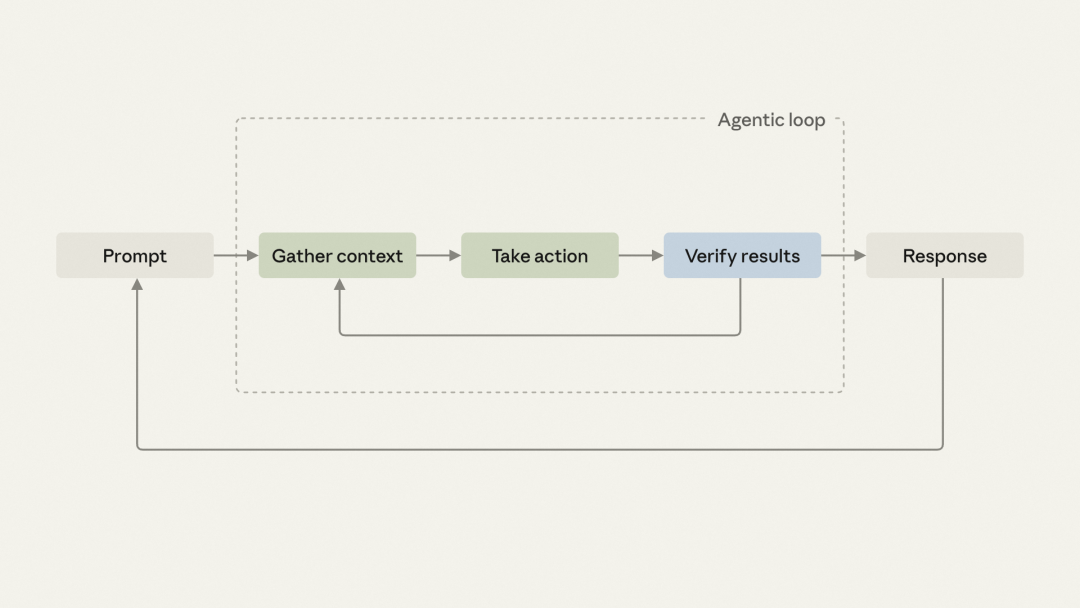
让数据先开路。Claude Code团队公开过他们的作业:代码约90%是Claude写的,monorepo每天落地的change从5月约2,500个涨到9月超30,000个,四个月超过12倍。这个速度下,逐行人工review不是看不完,是根本做不到。他们给人只留5类决定:该不该做、高风险代码、会被别人照抄的架构、看懂证据、为结果负责。结果反直觉:6到9月合并的PR翻了一倍多,revert(合了又撤)的比例反而降了40%以上。知乎小红书
同一阵营还有参与Grok Bot研发的首席工程师Lauren Tan。她演讲前一个月往生产环境合了3,127个PR,团队单月10,926个,回滚率稳在0.47%。她的核心动作不是把提示词写得更长,而是把规矩写进代码库:单功能单目录、禁止跨边界import,类型和lint挡在最前面,再配运行时验证和TLA+、Lean形式化检查兜底。用她的话说叫"code is memory"——只有写进代码的检查才可复现。坑要是只记在文档里,下一个agent照抄一遍,就成"团队既定范式"了。知乎
所以真正的验收组合拳,大致是三层:
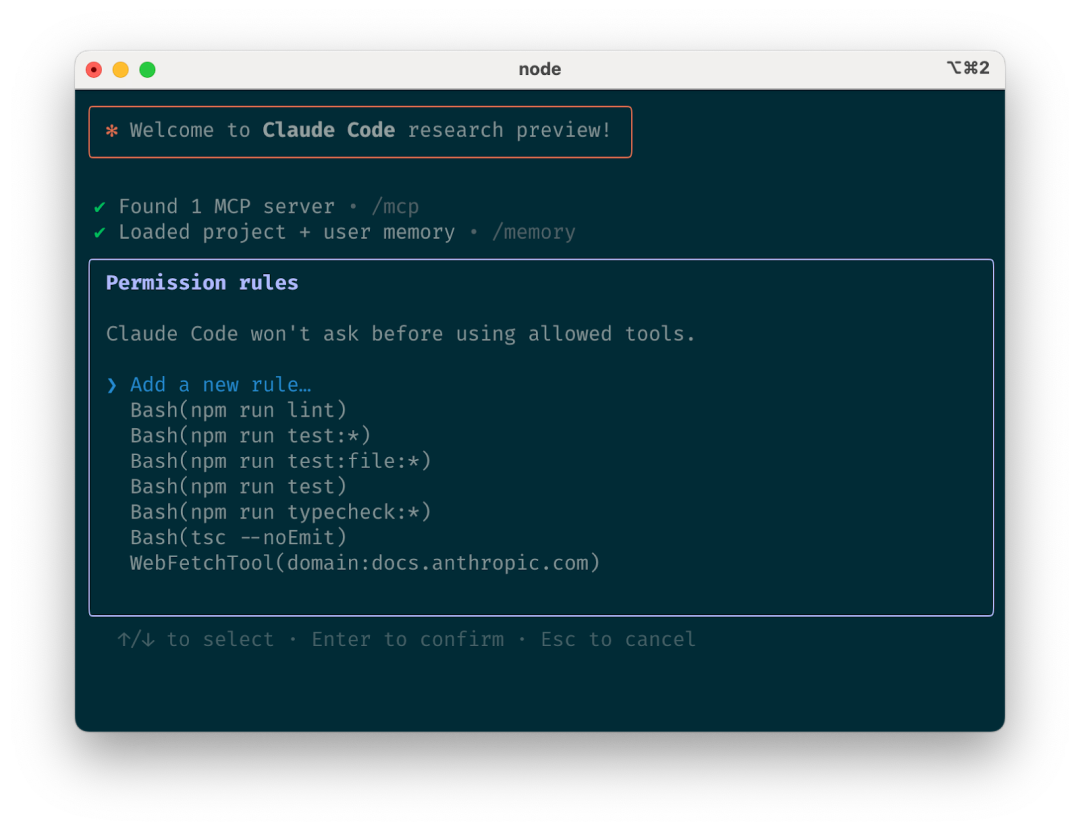
第一层:写之前,先把AI能犯错的路堵死。架构约束、类型边界、lint规则就是墙。《代码整洁之道》的作者Uncle Bob现在也不逐行review AI代码了,靠设计好路径和架构管质量,拿CRAP风险分数当合入证据。教整洁代码的人先违背了祖训,这事本身就很有信号量。知乎
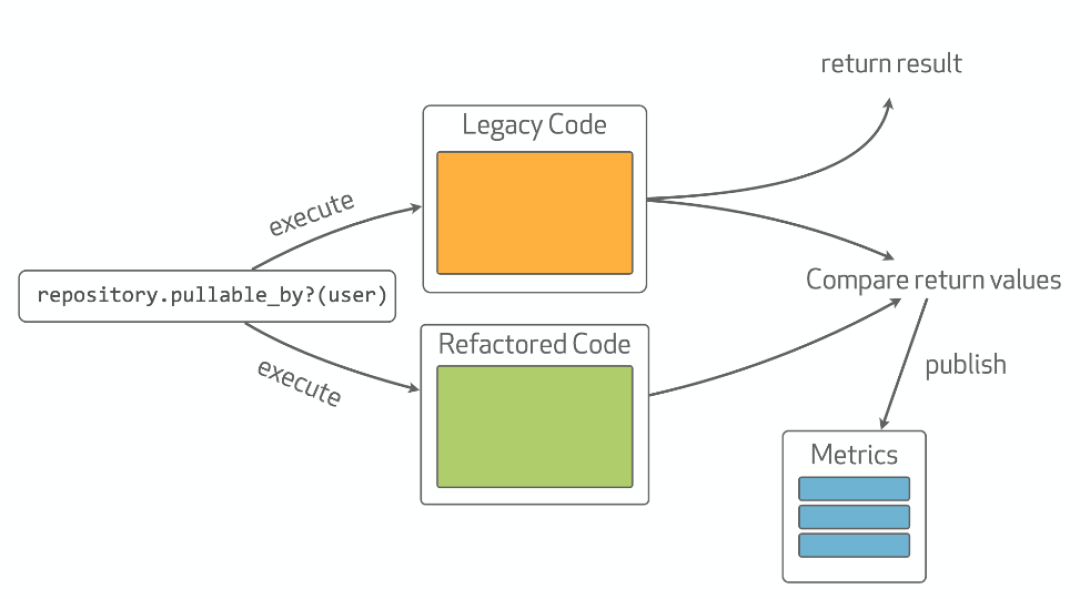
第二层:验收行为和spec,不验代码。AI自己写的测试不能单独算证据。同一个模型会照着自己的实现反推断言,覆盖率能刷到九成以上,上线遇到没预料的行为直接歇菜。成熟团队上影子流量:新版旧版同时吃同一份真实请求,新版不落库,后台逐条比对,对不上的才捞出来看。要验的是"行为符不符合预期",不是"代码看着舒不舒服"。知乎
第三层:人只守高价值区。低风险PR自动过,中风险1人,高风险2人。敏感路径和CI配置永远要人看,agent的approval不算人的approval,谁prompt了这个change,谁就算一个必须到场的reviewer。知乎
但先别急着抄作业,对照自己手里的牌:
harness不稳、环境不可控、日志trace不全,就先别放review的手。这时候放手不叫AI-Native,叫赌博。真把"修得快"跑起来的团队,先补的是可观测性,不是再买一个更贵的模型。知乎
初学者,老老实实一行行看。有个零基础自学Python的答主说,自己读AI代码就是一行一行认真看,并且建议其他新手也这么干。"能嗅到哪里不对"的嗅觉就是从这来的,没捷径。知乎
代码可以是AI的,锅得是你的。有个回答骂得很响:AI传话筒,问他bug为什么出、这功能能不能做,一问三不知,还得跑去问AI。“这种人头,甲方绝对不会付钱。”知乎
有个高赞比喻值得记住:vibe coding像玩崇祯模拟器,给你汇报的都是忠臣,单测冒烟测试全绿,一上战场全垮。所以Review不需要死,但也不用逐行读——退场的是"读代码"这个动作,上岗的是读约束、读证据、读行为。工程师越来越像园丁:不用数每朵花,但得拔杂草,你今天留下的workaround,下一个agent会顺着根系抄满一园子。知乎知乎
至于Spec+Harness到底够不够?看两件事:你的Spec有没有牙齿,你的Harness敢不敢跑真话。都有,你才有放手的资格;还没有,先别争论,回去补作业。

当前文章无评论,是时候发表评论了