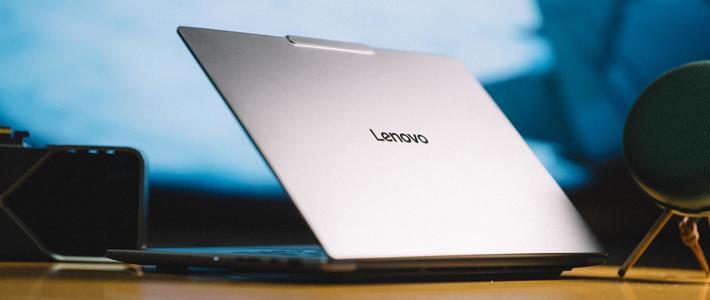
10月16日,搭载英伟达RTX Spark N1X芯片的全球首批AI笔记本里,出现了国产品牌联想的身影——YOGA Pro 15 RTX Spark正式开售,官方卖点直接写着支持本地运行超千亿参数大模型,还内置了天禧AI超能模式。它的64GB内存版售价29999元,128GB版42999元。这台机器的意义,是坐实了一个行业逻辑的变化:PC跑千亿模型,卡脖子的不再是显卡显存有多大,而是内存容量够不够大、带宽够不够快。如今想在本地跑千亿模型,现实路径只有三条:三万至五万元的统一内存新笔记本,是开箱即用的官方级方案;已有12GB显存加大内存的游戏本,靠开源卸载方案能跑千亿级MoE模型;而大多数人真正需要的,可能只是8000—10000元的入门独显主机,跑9B级日常模型已经相当流畅,不必为「千亿」概念买单。微博知乎知乎
千亿模型为什么突然装得下:MoE加低比特量化
拦路的一直是一个数字:1370亿参数按FP16或BF16格式存储,仅模型权重就需要约274GB。而普通独显台式机的显存到24GB基本到顶,RTX 5090的32GB已是消费级顶端,也只能跑中等参数的模型,再大,输出速度就很慢。知乎知乎
墙被搬开,靠两项技术的组合拳。第一招是模型结构变了:微软本月发布的代码模型MAI-Code-1.1-Flash拥有1370亿总参数,但每次推理仅激活约68亿参数,MoE混合专家架构让千亿参数只需要「住」在内存里,单轮计算量接近小模型。知乎
第二招是低比特量化。10月7日,微软「通过低比特量化,将一款拥有1370亿参数的AI模型压缩至约53GB,并成功部署到个人电脑上」,还保留了256K上下文窗口;在其公布的测试中,量化后的代码处理能力与云端高精度版本接近。知乎
装得下不等于跑得爽:先买内存,再谈显卡
量化的代价有多大?微软公布的工程测试显示,SWE-Bench Verified评测中该模型高精度版本72.6%,本地量化版本70.8%,相差1.8个百分点。知乎
更要紧的是运行时开销:模型开启256K上下文时,峰值内存占用可达75.5GB,微软因此建议用120GB以上内存的设备——生成过程中,KV缓存和计算中间结果都在持续吞内存。所以配置单上的第一优先级,是把预算从显卡挪给内存。知乎
新平台正是按这个逻辑造的:RTX Spark把Blackwell GPU(最高6144核)和20核Grace CPU集成进同一颗芯片,「它们之间走NVLink-C2C互连,互连带宽能达到600GB/s」,还能共享最高128GB统一内存池,CPU和GPU直接共用一池内存,告别了「显存吃满、内存围观」的老问题。知乎
主流机型与三条价位线
官方口径上,RTX Spark可以在本地运行通义千问3.8 Flash Next等125B参数级模型,效果对标云端。首发同步上市五款机型,价格梯度一目了然:微软Surface Laptop Ultra 24GB版21988元、128GB顶配48388元,华硕创14/16 32GB版18999元、128GB版35999元起,微星尊爵N16 Flip 128GB版45999元,戴尔XPS 16要到11月才上市、价格暂未公布。对照微软120GB的建议门槛,24GB、32GB的基础款与千亿目标基本无关,那档买到的是更强的AI轻薄本;奔着千亿去,64GB是起步,128GB才稳妥。知乎
预算不够怎么办?开源生态给出了第三条路。GitHub上获2.6万标的Strata项目,「在 12GB 显存起步的游戏电脑上本地运行 1250 亿参数的 Qwen3.8-Flash-Next」,Windows/Linux一键安装,本机直接提供OpenAI / Anthropic兼容接口,可接入编程智能体。已有用户拿32GB内存加16GB显存的老游戏本实机跑通了这款千亿模型。极客玩法更压到极限:老服务器CPU配64GB内存、两块P100计算卡,「硬件总计6000块」也能凑出一套。但这档的前提要看清:跑的都是量化版MoE模型,输出速度和长上下文体验有折扣。知乎小红书知乎
至于稠密大模型,社区的原话更直接——满血DeepSeek(671B)任何笔记本都别想。知乎
不追千亿的用户,升级线同样清晰:24GB显存就能舒服跑当下热门的27B模型,这才是进阶级的真正门槛。知乎
但想流畅跑72B就超出了单卡消费级显卡的范围,需要多卡或48G、96G专业卡,那已经不是个人电脑的账。知乎
至于本地部署能否省下钱,社区已经吵过一轮:知乎「本地部署大模型真能实现token自由」相关问题冲到115万浏览,高赞结论是本地部署省下的调用费,会从硬件这个口子原样花出去。知乎
下单前,先看清三个边界
第一个边界是游戏兼容性。这类机型是Arm架构Windows,部分游戏需要转译,「涉及反作弊驱动的网游,以及一些老游戏、小众游戏,仍然可能遇到兼容性问题」,同价位的传统RTX独显电脑依然是更稳妥的选择。知乎
第二个边界,是别把「AI小主机」当电脑。英伟达的DGX Spark定价4999美元,卖点同样是本地跑千亿参数大模型。但据实测,它实际跑大模型解码时内存带宽就是瓶颈,只有273GB/s,27B级模型的输出速度约每秒13token,加上只预装Ubuntu Linux、不支持Windows,本质是一台纯开发工具,不适合普通用户当家用主力机。微博知乎
第三个边界,是别为概念买单。Gartner初步数据显示,「2026年第三季度全球PC出货量约为5540万台,同比下降22.4%」,存储涨价推高整机售价,厂商都在把本地大模型当成新的换代理由——这对消费者意味着,现阶段想本地跑千亿模型,就必须接受高端定价,而实际体验取决于你每周真正跑多少次本地推理。对高频AI编程、私有知识库、敏感数据处理的用户,3万元档的64GB统一内存机型是当下能开箱跑千亿模型的最低门槛;想折腾的用户,可以先在旧电脑上用开源卸载方案试跑,确认速度能接受再谈升级;至于只在云端聊过天的普通用户,这笔钱暂时一分都不用花。