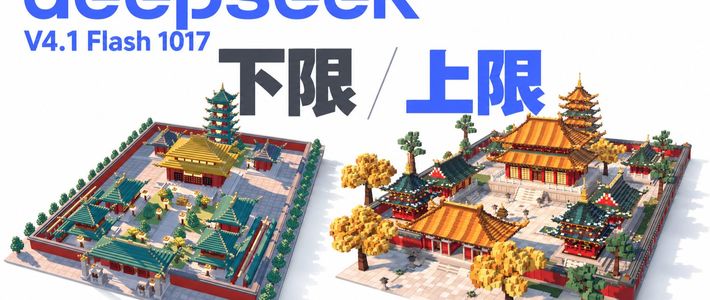
10 月 17 日,DeepSeek 把 V4.1 Flash 悄悄切到了社区口中的「V4.1F」新版本 1017,随之冲上热榜的不只是官方跑分,还有一套把模型最好和最差输出摆在一起对比的「上下限测试」。测试给出的答案相当直白:如果任务是写代码、做页面这类「干活」,DeepSeek 自家免费入口加 OpenCode 的限时免费,是当下免费档位里上限最高的一档;如果是高知识密度的问答查证,免费档与顶级付费模型在纯知识项目上仍有明显差距,这不是靠低价能补平的。这次发布的版本号是 DeepSeek-V4.1-Flash-1017,网页端、App 和 API 同步切换,价格没涨,权重照旧开源。知乎
上下限测试测的是什么
这套玩法来自 B 站 UP 主「无机酸-_-」的 AI 前端/3D 能力测试系列:同一道提示词让模型多轮生成,最好一轮算上限、最差一轮算下限,结果画廊公开可查,测试排行榜来源于亿模亿样的双盲机制。10 月 17 日上限篇的标题毫不客气:前端能力世一 Flash,播放量两天接近 18 万。哔哩哔哩哔哩哔哩
上限确实撑得起场面。有博主只给几句需求,就让模型跑出了流程完整的 3D 跑酷小游戏《末班车》,撞车后弹出的结算页面配着车票样式和「代码还在,再赶一班」的文案;另一道题要求纯代码还原天坛祈年殿,模型先联网核对官方数据、下载实拍照片放大比对瓦垄细节才动笔,成品做到了三重檐、琉璃瓦和日夜切换。知乎
下限也摆得同样直白。有评测在严格约束指令下发现,「鹈鹕骑单车」SVG 转弯顺畅但鸟嘴结构奇怪、右脚被齿轮遮挡,复合弓动画出现箭羽反装、弦回弹后箭才射出等诡异现象。也有人总结它「2D 平面视觉不稳,锦鲤能画成泥鳅」。哔哩哔哩知乎
别只看榜单:官方口径与证据边界
官方对 1017 的定位是「性能和费用的帕累托改进」:跑分整体抬升,任务运行时间和输出长度双双下降,费用端同样兑现了说法,同一编程任务在最高推理档的成本砍了一半还多。知乎
基准层面确实有硬指标,DeepSWE 从上一版的 74.2 涨到 77.0、超过 Claude Opus 5 的 74.0,Terminal-Bench 从 31.2 跳到 42.3。但 11 项基准对 Opus 5 仍是 4 胜 7 负,纯知识科目 HLE 只有 42.6 对 56.3,是差距最大的一项——拿它当外包工程师够用,当百科全书不行。知乎知乎
模型本身仍是 763B 稀疏 MoE 架构的新 checkpoint,输入侧激活 8B、输出侧激活 16B,1M 上下文,MIT 协议开源,权重已上 HuggingFace 和 ModelScope。第三方整理的 Arena WebDev 竞技场榜单显示,10 月 18 日更新后 1017 以 1670 分排在开源模型第一、总榜第 12,旧版只有 1619 分、排 25 名。知乎
更值得注意的是证据边界:UP 主本人在置顶评论里先划定了适用面——只测了前端,不代表其他方面突出,指令遵循依旧是 Flash 模型的通病;随后他披露榜单已被「离谱地刷到第二」,参与者倾向只上传满意结果,还有人在五秒内完成了四十一票,双盲排行榜的可信度需要打折。哔哩哔哩
为什么同题会「抽卡」:工具链与档位
上下限差距大不全是运气。有开发者用同一套 Bug 修复测试对比,同样是 1017,配上官方开源工具 DeepSeek Harness 比配上 Claude Code 平均高 2 到 3 分,但成本多了 80%,原因就是子 Agent 和输出 token 更多。档位是第二个坑:默认档 High 会反复调工具、检查、迭代,有博主同题实测新版输出 token 达 45.6 万、比旧版多近一倍(他注明两次测试档位并不一致),社区也把这种特性称为「很难自我满足」。实用结论:短任务用 Low/Medium,认真的长任务直接拉满 Max,卡在默认档最容易白烧钱。知乎知乎
免费入口盘点:谁适合哪种用法
把当下能白嫖或近白嫖 1017 的路径摆开,不同需求对应不同入口。
日常聊天问答:网页和 App 免费、默认已是 1017,普通文案、问答和轻度代码检查够用。评论区有用户晒出从发布当天起用 1017 烧了约 7 亿 token 构建小说写作 Agent,称长程构建和提示词遵循明显好于前代、成品甚至被 GPT-6.1 Sol 误猜成 Opus 5 做的,属个体自述,看看即可。哔哩哔哩
跑代码任务:OpenCode 在 10 月 15 日就把 DeepSeek V4.1 Flash 上架为限时的免费模型,输入、输出、缓存读取按 0 元计费,这是目前免费 Agent 化体验上限最高的一档;只是免费版上下文缩到 200K、常规入口为 1M,且官方未公布免费结束日期,别把长期项目押在上面。知乎
搭检索类应用:官方开放了自研 Search/Fetch 接口,价格都是 5 元 / 千次,在 DSH、Claude Code、Codex 里通过 DeepSeek API 调用的服务端搜索 11 月 1 日之前仍免费,想省这笔钱的窗口只剩几天。知乎
同价位参照:MiniMax M3.1 Flash 预览版早前的四项目实测里,后端略胜旧版 V4.1 Flash、前端和 3D 两边都还差口气,但那场对比发生在 1017 发布之前,结论已经过期。哔哩哔哩
费用端的对比同样能支撑「干活选它」:有 AI 开发者晒出 GPT-6.1 Sol Ultra 与 1017 的同题渲染对比,感叹一个便宜九成的模型能产出几乎一致的效果,两者耗时也大致相同。微博
回到热榜的问题——免费 AI 工具谁更实用,可以收敛成三句话:干活选 DeepSeek 自家入口或 OpenCode 免费版,按任务复杂度拉档位,执行类基准它对 Kimi K3 除一项知识科目略输外全部领先、对 GLM-5.3 全胜。查知识类问题它仍与 Opus 5 一档有明显差距,付费模型在纯智力项上的优势不会降价;而「世一 Flash」这类结论只覆盖前端/3D 的双盲场景,榜单还被刷过票,选型时当参考,别当夺冠公告。知乎














