如果你这两年认真搞过笔记,今年大概率被两种内容轮番轰炸过:上半年刷到的是"用Codex+Obsidian搭建卡帕西同款知识库",下半年刷到的是"你的知识库不是第二大脑,是第二个垃圾场"。两边都不是小打小闹——这不是工具之争,是一场正在分胜负的路线之争。今天把两边的账本摊开,给已经在Obsidian、Notion、flomo里折腾过的你,一个能直接用的判断。
先看热度:这半年的"建库潮"是真的
把三个平台按收藏量拉一遍时间线,趋势非常清楚:
4月初,"大神Karpathy个人知识库AI工作流,我直接抄"在小红书拿了3254收藏;4月中,"搭建全网千万收藏的AI第二大脑"教程又冲上19214收藏。
5-6月是B站高峰:UP主Xuan_酱的"Codex联动Obsidian,搭建卡帕西同款知识库"拿到25431收藏、38万次播放。 "摄影师云飞"的Obsidian保姆级入门也攒了18720收藏。哔哩哔哩
9月新变量出现:主打"3分钟搭好个人知识库"的WorkBuddy类教程在小红书冲到16119收藏、450条评论。 "用Obsidian打造自进化知识系统"的教程9月底还在密集更新。小红书
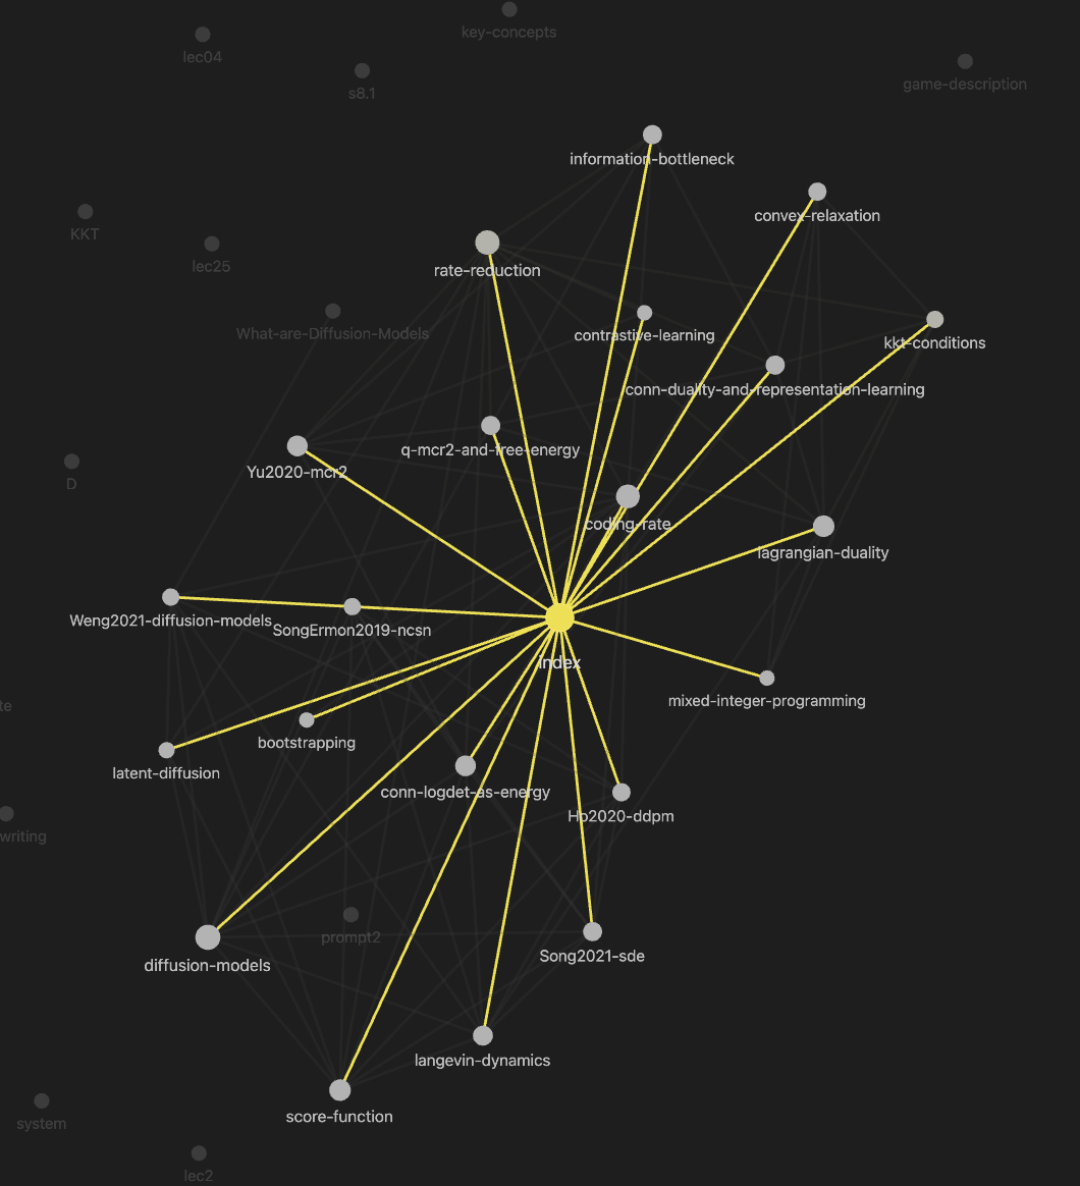
10月中旬,一个律师(或者说法律工作者)身份的博主"老井"晒出自己的成果:四个半月、给DeepSeek充过20块钱起步,攒出"41个能调用的能力,14个能查的知识库,32个自动跑的任务",底下压着5万多条法条、1.1万多条判例、1.7万本电子书。这条晒单,几乎就是"AI第二大脑"叙事最完整的样本。知乎
收藏量不会撒谎:教程侧的供给和用户需求都在放量。但同一批平台里,另一条曲线也在抬头。
再看分歧:反方文章从7月开始一篇篇出现
7月25日,知乎专栏"AI时代重谈’第二大脑’:你建的到底是大脑还是仓库"直接把矛头对准教程潮:Tiago Forte当年的CODE方法论(捕获、组织、提炼、表达),在博主们的AI叙事里"CODE里的最后一步’表达’消失了,换成了一个更省力的动作:‘消费’"。 存进去、问AI、要答案——这套被包装成第二大脑的东西,在该文作者看来只是仓库加一个话术流利的图书管理员,“这不是第二大脑,这是外包判断力”。知乎
7月28日,另一位长期记笔记的用户给知识库加"保质期",写下一句被很多库龄三年的人秒懂的话:“我需要的可能不是一个’永远记住’的第二大脑,而是一个知道什么时候该忘记的系统”。知乎
10月16日,"你的知识库不是第二大脑,是第二个垃圾场"发布,作者吾爱拆解AI实战的火力点更直接:“我找AI当合伙人,是想把活交出去,不是想再给自己找一份’知识库管理员’的工作”。他还顺手补了一句对教程潮最狠的诊断——资料一篇篇塞、标签一层层加、页面越搭越漂亮,“最后真正遇到问题的时候,还是得从头找、从头想、从头解释”。知乎
最有信息量的其实不是文章,是教程自己的评论区。在那条2.5万收藏的Codex教程下面,被顶在前排的两条回复:一条说"不要本末倒置,先有知识沉淀,然后才有搭建知识库的需求";另一条说"看完视频会恍然大悟,但实际上一上手还是废了"。建库热潮最忠实的观众,已经开始在教程底下劝退后来者。哔哩哔哩
算账:入坑之前,这三笔成本教程基本不会写
第一笔:环境与跟练成本。 评论区有人吐槽"用的Codex连代理环境配置都没搞,每次重连你是怎么用得下去的"。 也有人要求UP主把一步跳过的链接配置拆细。这不是个例,是这类"agent+本地vault"教程的通病:默认你会装环境、会配代理、看得懂报错。收藏教程的5分钟和真搭起来的5小时,中间隔着一整个周末。哔哩哔哩
第二笔:维护成本。 "垃圾场"一文的核心指控就在这——系统搭好那天,维护它的工作才开始。分类、打标签、定期复盘、清理重复条目,每一项都是人肉工时。对以推进项目为主的人,这笔账尤其不划算;反方给出的替代方案很朴素:先有问题,再让AI去找资料,只把这次真正参考过的内容留下来。知乎
第三笔:线索成本,也就是"卖课税"。 打开任何一条建库教程的评论区,“AI全套资料”"加V领取"的引流评论能刷屏。教程里最贵的一环——工作流怎么设计、什么内容该进库、什么该扔——恰恰是卖课话术里最舍不得讲的。看到"3分钟搭好"四个字,先想想3分钟后面跟着的私聊框。
人群适配:三条路线,对号入座
重度研究者、垂直实务者(法律、医疗、学术):本地知识库+AI,成立,但成立的原因不是"第二大脑"。 老井那条晒单真正的信息量不在库有多大,而在他存的是法条、判例、电子书这类"有唯一真源、要反复精确引用"的语料,库的用途是支撑32个自动化任务。这类人群用Obsidian这类本地方案还有离线和引用控制的需求,反方文章自己也承认:“如果一个人每天处理大量论文、文献和长期项目资料……本地知识库完全可能是合理的选择”。知乎
内容创作者、自媒体从业者:适合AI辅助,但顺序要反过来。 高收藏教程里那批"知识复利""5万粉博主搭库"的样本,共同点是库服务于输出管线。正确顺序是先有选题和输出压力,让真实问题决定库里长什么样;先搭空架子再找用途的,大概率滑向垃圾场。
收藏爱好者、"存了等于学了"选手:暂时别搭,先治囤积。 一条讲"存了一万张截图后治知识囤积癖"的视频在B站能拿53万播放。 这就是证据。这类用户现在最需要的不是一个vault,而是接受"AI本身就是检索引擎"这件事:把手机里吃灰的收藏夹,换成一次一次"带着具体问题去问"的练习。库可以以后建,从第一次真的复用成功之后开始。哔哩哔哩
已经建了库的人:用三个信号验收,别急着拆也别死守
如果你已经有几万条笔记的库,不必在两个阵营之间选边站,用这三问自检:
复用测试:最近一个月,有没有哪次工作因为你调出旧笔记而明显省力?一次都没有,库对你而言就是仓库,不是大脑。
判断测试:你问AI的问题,它给你答案时你能不能核对来源?你的库结构有没有让这件事变容易?如果完全依赖AI的"听起来合理",参照"外包判断力"警告。
工时测试:每周花在整理和维护上的时间,是否超过花在"用库解决真问题"上的时间?超过了,就按反方方案止损:停增、只留解决过问题的条目,给老库存加"保质期"。
这场建库潮走到现在,真正的共识其实已经浮出来了——不是"要不要Obsidian",也不是"要不要接AI",而是那句被正反两边都引用的话的反面版本:判断一套知识系统值不值,“不是比谁存得多,不是比谁页面漂亮”,而是下次遇到问题时,它能不能真的帮你省力。 教程可以继续收藏,但你的库值不值得建,让真问题说话。知乎