十月中旬,一个叫 Strata 的项目在大模型开发圈刷屏:它把总参数 125B 的 Qwen3.8-Flash-Next 塞进一张 12GB 显存的 RTX 5070,每秒还能吐出 53 到 94 个 token。知乎上"Strata 支持 12GB 显存运行 125B 大模型,其技术难度有多大?"这个问题 10 月 8 日挂出来,两周冲到 14 万+浏览,核心回答也拿下 340 赞同、412 收藏;据答主观察,项目在 GitHub 上两周内干到了约 1.7 万 star。评论区有一句话很诚实,也很危险:“完了,12G 显卡也要涨价了。”知乎知乎
先说结论:这波值得跟,但别急着花钱。看懂它为什么能成、在哪翻车,你再决定是装机、买小主机,还是干脆把现成的 API 账单先治一治。
一、12GB 凭什么装得下 125B:把"体格"和"工作量"拆开算
Strata 不是把 125GB 的东西硬塞进 12GB,它吃透了一个模型的架构红利。Qwen3.8-Flash-Next 是阿里 Qwen 团队 8 月发布的 MoE 模型:总参数 125B,但每生成一个字只激活约 6B 专家,不到 5%。整个项目本质上就是围绕这两个数字做"极限拉扯"。知乎
一个社区常用的显存粗算公式:BF16 权重占用 ≈ 参数量 × 2 字节。125B 原生要 250GB 上下,起步就是三张 80GB 专业卡、按单卡十万算约三十万的预算;压到 2-bit 量化后,体积骤降到 31GB 左右——这就是消费级硬件够得着的范围了。知乎
31GB 还是比 12GB 大,作者的解法是把一台普通电脑拆成三级仓库:
显卡:只放每生成一个字都要用的常驻部分(注意力层、路由器和共享专家,合计约 3.5GB),剩下的 12GB 空间拿来缓存最常点名的专家,能塞下大约 4500 个。模型一共 24576 个专家(48 层 × 每层 512 个,每次只挑 10 个),热专家命中显卡的概率被拉得很高。知乎
内存 + CPU:压到 2-bit 后全部专家合计约 34GB,显存放不下就全进内存,轮到显卡里没有的专家时,CPU 直接在内存里就地算,和 GPU 同时开工。GPU 选好本层要用哪 10 个专家,就把编号写进一小块共享内存,CPU 盯着这块地方、一有编号马上动手——论文里管它叫"门铃"(doorbell)。
SSD:那个 51B 参数的 N-gram 词组表,压缩后还有 28.8GB,内存都嫌占地方;但它每生成一个字只要读不到 23KB,而且查表位置可以提前预知,作者直接把它丢到硬盘上,几乎不影响速度。
另外两个巧思也很圈粉:显卡上的专家是动态调的,你一直聊代码,写代码常用的专家就被换进显卡,GPU 直接处理的比例从 50% 提到 72%;4B 的 MTP 层像"小学徒先猜",先猜后面三个字让大模型一次验收,对的留下、错的重来,结果逐字生成完全一致,速度提升 1.6 到 1.8 倍。48 层里有 36 层是 DeltaNet,"记忆"大小固定,从 1K 上下文聊到 262K,速度只掉三分之一左右。第三方在同等显存下和 llama.cpp 对比:写回答 62.9 比 23.4 tok/s,读长文档快了接近 10 倍。它还兼容 OpenAI 和 Anthropic 接口,Claude Code、Codex 能直接把它当本地模型用。知乎
二、穷鬼版终归是穷鬼版:先看清楚它哪里翻车
社区项目爆火最怕跟风装完发现吃灰,Strata 的答主和评论区把边界说得挺清楚:
只认这一个模型。整套方法是照 Qwen3.8-Flash-Next 的架构拆的,换个模型就跑不动——真正的门槛不是"12GB 显卡",而是"每次激活的参数量能不能小于 12GB"。激活参数超了这个数,起码得上 24GB 显存,那卡要大几千到上万,“就不算穷鬼版本了”。知乎
只跑得动 2~3 bit 的压缩版,效果相比原模型非常有限,别拿它对标云端旗舰模型的输出质量。
一次性只能接一个请求,启动时电脑会卡,生产、多人协作场景直接出局。
64GB 内存并不便宜,"穷鬼"是相对三十万的三卡方案说的,不是相对白嫖说的。
顺带一提行业背景:同一周,微软 10 月 15 日宣布 2.8T 参数的 MAI-Base-2 完成预训练;另一边,人们在一台游戏电脑上抠 12GB 显存。前沿在拼"更大",社区在拼"更省",这两条线同时成立,才是 2026 年做 AI 应用最真实的样子。知乎
三、大模型开发者做本地推理,2026 年其实只有三条路
把近一个月知乎、B 站、小红书上折腾派的一手记录放到一起,本地路线已经清晰分化为三档,适用人群完全不同。
路线 A:现有独显 + 卸载推理(Strata / llama.cpp 这条线)
适合已经持有 12GB 以上独显、32~64GB 内存的人——注意关键词是"已经持有"。llama.cpp 生态早就支持把 MoE 专家层甩进内存、显存只留热数据,Strata 是把这套思路在一个具体的新模型上压榨到了消费级下限。适合拿来做隐私敏感的文档问答、离线玩具、给编码 Agent 当兜底后端;不适合当生产力主力。要特别提醒一句很多新手踩过的坑:MoE 省的是计算量,不是显存,全部专家都得"装在家里随时待命",30B-A3B 的权重体积依然是 30B 级别的。知乎
路线 B:统一内存小主机(Strix Halo 这条线)
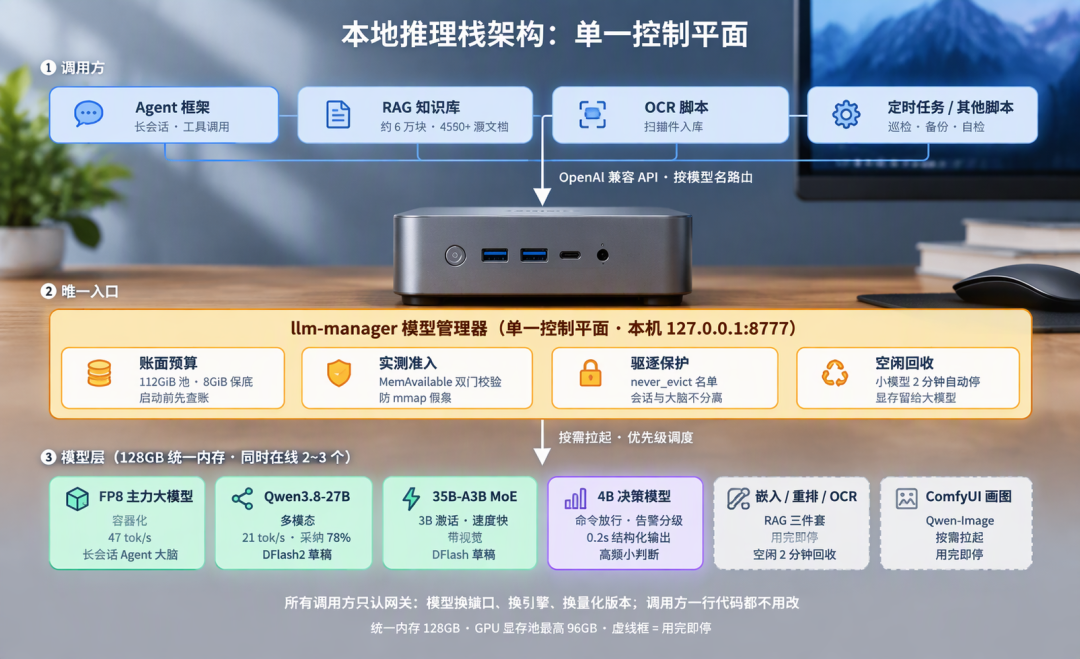
知乎一位用铭凡 MS-S1-MAX(AMD Ryzen AI MAX+ 395、128GB LPDDR5X)折腾了大半年的答主给了句很准的话:“本地推理的瓶颈不是算力,是显存”,而这类平台 GPU 最多能分到 96GB 显存池。他的取舍是"用带宽换容量,用容量换上下文,用上下文换 Agent 能力":实测解码 20~40 tok/s,做个人 Agent 大脑和全本地知识库(他跑了约 4500 份源文档,OCR→嵌入→检索→重排→大模型作答,数据不出门)完全够用;但指望它当每秒蹦一百个 token 的码农 Copilot,这条路线不适合你。这位答主到后期悟出来的反而是运维经验:“本地推理到后期,拼的不是跑通,是资源治理”——所有模型收敛到一个 OpenAI 兼容网关统一托管、启动前查内存预算、给正在用的 Agent 会话设 never_evict 保护名单、KV cache 超 80% 预警 93% 红线,以及最重要的一条:警惕"假绿",systemd 显示 active 不代表服务真的在干活。知乎
路线 C:继续用云端 API,但先把 token 账单治好
不是所有本地化都划算。小红书上一条"17k Agent 开发一天工作强度"的帖子(545 赞、290 评论)里,打工人早上九点的第一件事是打开链路追踪,“看昨晚 Agent 跑了多少 token,生怕半夜哪个环节跑飞了”——token 成本已经是这个圈层的真实焦虑。B 站配套生态因此火了一批工具:一个给 DeepSeek 减 50% token 消耗的插件视频拿到 1.7 千赞、4.2 千收藏;本地 AI 索引引擎 XERJ 主打"AI 写代码只会 grep、命中一句就得读完整个文件",一句命令索引整个项目、号称省 26 倍 token。同一条兴趣线里,"转卖大模型 Token 成为热门生意"也上了知乎热问——有灰色生意,恰恰说明 token 差价值得你亲自算一遍。小红书哔哩哔哩哔哩哔哩
四、下次新模型发布,三分钟判断自家电脑配不配
把几位答主的公式合起来,其实就四步:
看总参数量:决定能力上限,也是体积的地基。写小工具脚本、做总结,7B~14B 现在够用;想干复杂的 Agent 活儿,30B 级别起步才稳。知乎
看激活参数:是不是 MoE、每次激活多少。省计算量,但不省权重体积。
算量化后的权重:位宽除以 8 再乘参数量。27B 模型 BF16 要 54GB,Q4(实际混合位宽约 4.8bit)约 16GB,这就是 GGUF 下载页面文件大小由来;Q 后面那个数字,就是主干权重的位宽。
别漏 KV Cache:长上下文场景它比权重还凶。一个 40 层、8 个 KV 头、头维度 128 的模型,FP16 存 KV 把 32K 上下文拉满,要多塞约 5.4GB——相当于又往显存里塞了小半个模型。峰值显存 ≈ 权重文件 + KV Cache(随上下文线性涨)+ 1~2GB 框架开销,三项加起来小于可用显存才算"跑得动"。
顺手记一条命名规则:`Qwen3-30B-A3B-Instruct-2507-UD-Q4_K_XL.gguf` 这种"天书"文件名里没有一段是废话——总参数量、激活量、量化位宽全都写在脸上,学会读它,下载页面就从玄学变成配置单。知乎
五、要不要跟:一张行动清单
已经持有 12GB+ 独显和 32GB+ 内存:可以低成本跟一把,Strata 装起来试,反正边际成本只有折腾的时间;但把它定位成"实验田"而不是"生产环境"。
正打算买卡/买小主机:先停一停。评论区那句"12G 显卡也要涨价了"是真实风险——需求被一个爆款项目拉起来之后,性价比窗口往往关得比想象快。等一等看 Strata 思路有没有适配更多模型、看 Strix Halo 之外的统一内存平台跟进,再决定。
团队里有 Agent 上生产:本地方案暂时满足不了并发,先把路线 C 做扎实:给 Agent 设 token 预算和链路追踪,警惕半夜跑飞;这比换硬件见效快。
继续观察的信号:Strata 的方法论会不会泛化到下一个 MoE 模型(决定它是烟花还是革命);2-bit/3-bit 极限量化的质量损失有没有被社区工程手段救回来;12GB 显卡的价格走势。
证据覆盖到哪里,话就说到哪里:Strata 的 53~94 tok/s 和对比 llama.cpp 的数字,来自作者自述与第三方社区测试,不是生产环境基准;三条路线的取舍依据是近一个月圈内一手折腾记录,个案经验,未必普适。但有一点可以确定:当"能不能跑"逐渐被工程手段解决之后,大模型开发者的竞争力正在从"搞到更多算力"转向"管好每一份算力"——这才是 Strata 这波刷屏真正值得收藏的东西。
(你会冲 Strata 还是继续抱云端 API?评论区聊聊你的机器配置和 token 账单,这可能是 2026 年双 11 前最值得抄的作业。)