10月16日下午4点,商务部网站挂出一条公告:2026年第48号,就修订《中国禁止出口限制出口技术目录》公开征求意见,并对相关技术实施出口前登记的临时管理措施。几乎同一时间,知乎的开源时间线被两类文章刷屏——一类在拆这份目录里关于大模型的条款,另一类在复盘黄仁勋7月发的第一条X推文和那封联署公开信。知乎
如果你只盯模型发布,这两件事像两条不相关的新闻。但它们放在一起,才是本周开源圈真正的变化:"开源"这个词,正在同时被写进中美两边的规则文件——而且指向相反的方向。
一、先数我们这本新规则:40项里,开源被单独开了绿灯
这份征求意见稿涉及三个领域40项技术:人工智能23项、生物医药5项、光伏12项,其中拟禁止出口14项、拟限制26项;AI的23项覆盖大模型、智能体、算力集群和信息处理,点名的禁止项里有"人工智能驱动的恶意代码生成与变异技术",限制项里有"AI辅助漏洞挖掘技术"。第一财经
真正跟开源圈有关的,是答记者问里的三段话:
"对已通过开源、发表学术论文等方式进入公共领域的相关技术,拟不纳入出口管理范围。"这句话等于用官方文件给"公共领域"画了一道合规豁免线。知乎
对AI类技术开源、中国企业在境外自建自营算力中心、赴境外芯片流片、境外联合研发、参与国际标准制定等情形,适用自动许可等便利措施,基本实现"即报即出"。
出海怎么判:核心看是否涉及限制类技术从中国境内向境外转移。纳入限制类的AI技术,开展海外本地化部署属于技术出口管理范围。但利用限制类大模型对外提供API调用、APP/网页交互、SaaS应用、本地端侧轻量化部署等情形,不属于大模型技术出口管理范围。官方同时表态:措施正式实施后,绝大部分AI技术仍可以自由出口。第一财经第一财经
门槛怎么划?多家分析转述的征求意见稿口径是:大模型触发"限制"的条件为训练算力超10^26、参数达2万亿、公开评估排进全球前十,满足任意一条。有个细节值得自己翻公告原文核对:这里的"参数"大概率按总参数算——知乎专栏"张大侠"就指出,若按MoE的激活参数算,几乎没有国产模型够得到2万亿这条线。另外注意生效节奏:目录本身还在征求意见(10月16日—11月15日),但出口前登记的临时管理措施已经同步启动,连"已经在进行中但没完成"的出口也要登记。哔哩哔哩知乎
社区分析把这套条款翻译得很直白:Kimi K3、Qwen3.8-Max这类权重已经公开的模型,虽然超过参数门槛,但已公开的权重原则上仍可流通;实际受影响更大的是手里捏着独家训练手段、私有训练数据的闭源厂商——API照常出海没问题,但要把完整权重交出去、做海外私有化部署,就得走许可了。另一篇高赞回答的概括只有一句话:收紧AI模型的同时,给开源和学术交流开绿灯。知乎知乎
二、再看大洋对面那本规则:7月的信,为什么10月还在被拆
黄仁勋在7月24日注册X账号,首条推文不发新品、不讲故事,转的是一封英伟达参与联署的公开信,标题就叫《开放权重与美国AI领导力》。他在帖文里说:开源模型能加强安全与网络安全,加速创新与技术扩散,并赋予各国技术主权。知乎
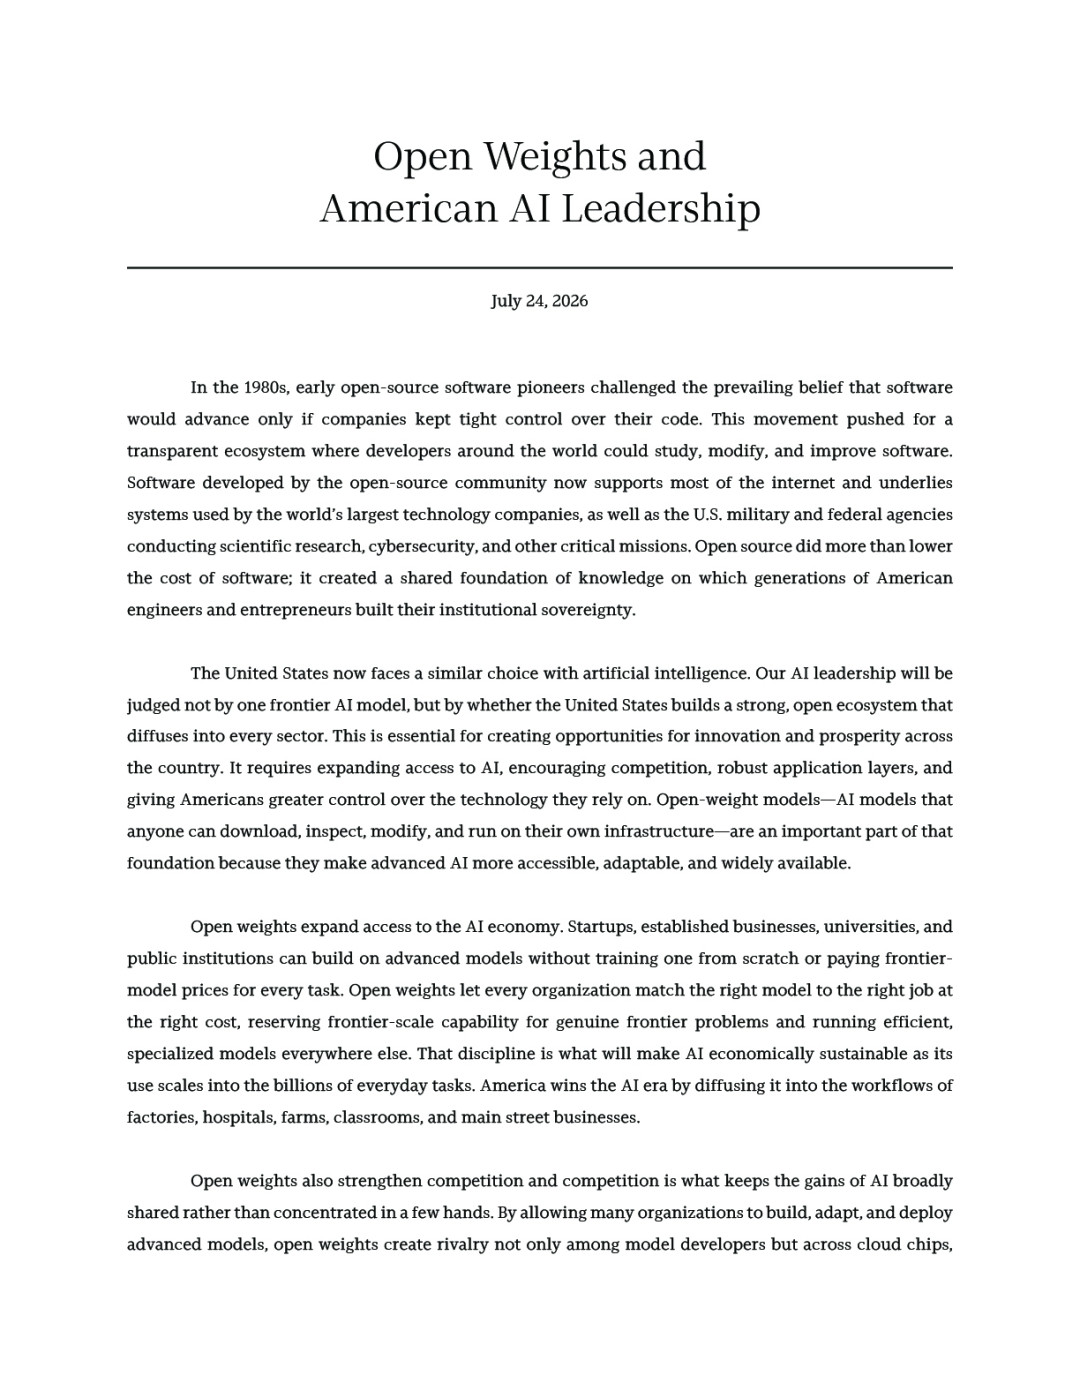
联署名单本身就是信号:第一财经当天报道首批25家,名单里有英伟达、微软、IBM、Meta、戴尔等老牌巨头,也包含a16z、YC、HuggingFace、Mistral、Perplexity和Linux基金会。微博·第一财经日报
几天内名单继续膨胀,7月底中国日报的报道口径已是70多家;纳德拉9分钟后跟进转发,马斯克也表态支持,OpenAI和Google随后补了签名——目前没签字的是Anthropic。微博微博·中国日报
信的核心论点可以压成三条:一个国家的AI竞争力不看谁家模型最强,看生态能不能扩散到千行百业;开放权重降低使用门槛、促进竞争、给企业和国家数据控制权;"蒸馏"是合法的通用技术,违规提取可以针对性执法,但不能把整个开源生态当威胁。
背景是"Kimi恐慌":K3于7月16日上线,7月27日正式开源,2.8万亿参数,权重、技术报告、三项训练基础设施全放,实测表现接近美国前沿模型且价格更低。随后白宫科技政策负责人克拉齐奥斯称,美方掌握的信息显示月之暗面利用Anthropic的Fable模型进行了大规模蒸馏,财长贝森特不排除动用制裁或实体清单。微博知乎
但必须把两件事分开:这些具体指控目前仍缺乏独立或司法认定,而"封禁派"和"开源派"的分裂是真实的——7月底"#英伟达微软反对禁止中国开源AI#"都上了热搜。知乎
英伟达为什么冲在第一线?拆信的分析说得清楚:模型价格下降不等于算力需求下降,更便宜、更广泛的采用反而带来更大的总体计算需求——它卖的不是某一个模型,而是跑所有模型的计算平台。这是杰文斯悖论的AI版本。知乎
三、两本规则对照着读,有三个不太直觉的点
第一,"开源"在两边的角色刚好互换了。美方那封信里,开放权重是扩散工具、是领导力叙事;中方这份目录里,开源是管制豁免、是"公共领域"的认定方式。同一个词,一个在向外输出标准,一个在给合规画边界。
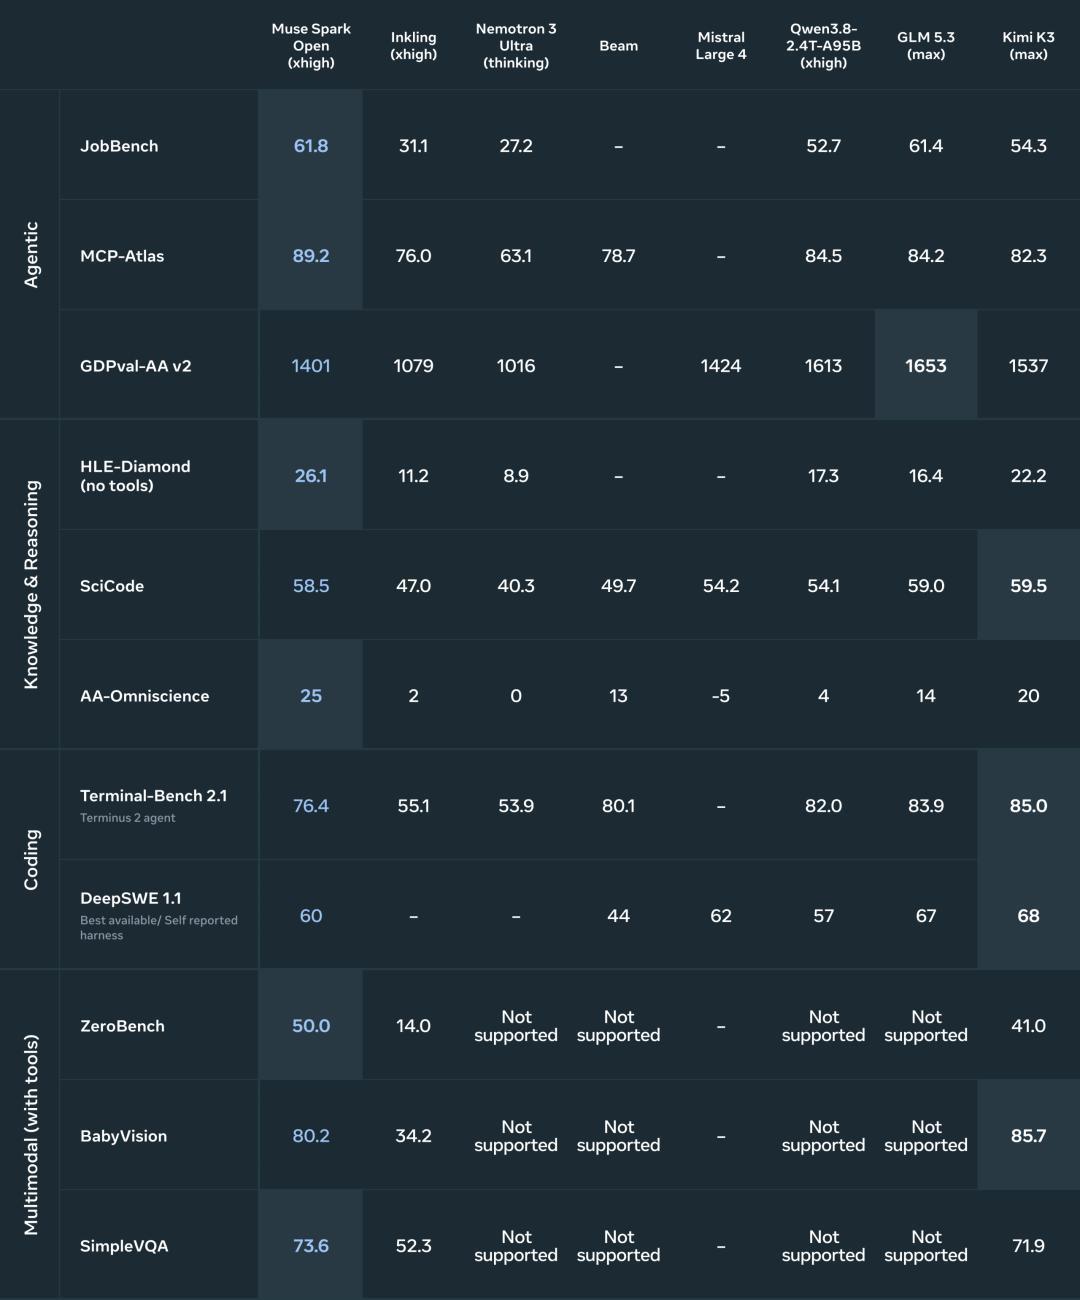
第二,“开放权重"不等于"开源”,Meta这周现场教学。10月12日Meta发布闭源的Muse Wonder,把"Meta出大模型最终会开源"的行业默认打断了一次。 10月15日它又放出Muse Spark Open——上一代1.2加额外安全后训练的权重,816B总参数、单token激活42B、100万上下文,号称"两台Mac Studio能跑",靠的是苹果统一内存(NVFP4版至少700GB显存门槛)。知乎知乎
按知乎专栏"totty"算的那本账,它自评的综合智能指数39分,低于GLM 5.3的45分和Kimi K3的44分——开放的那一档,本来就低一阶。知乎
许可证还有三个附加条件:界面显著标注"Built with Muse Spark Open"、MaaS业务任意连续12个月营收超2000万美元需先通知Meta并另签协议、禁止军事与关键基础设施用途。开放信签字者自己放权重时,边界照样写死在许可里:先读许可,再读模型卡,顺序不能反。知乎
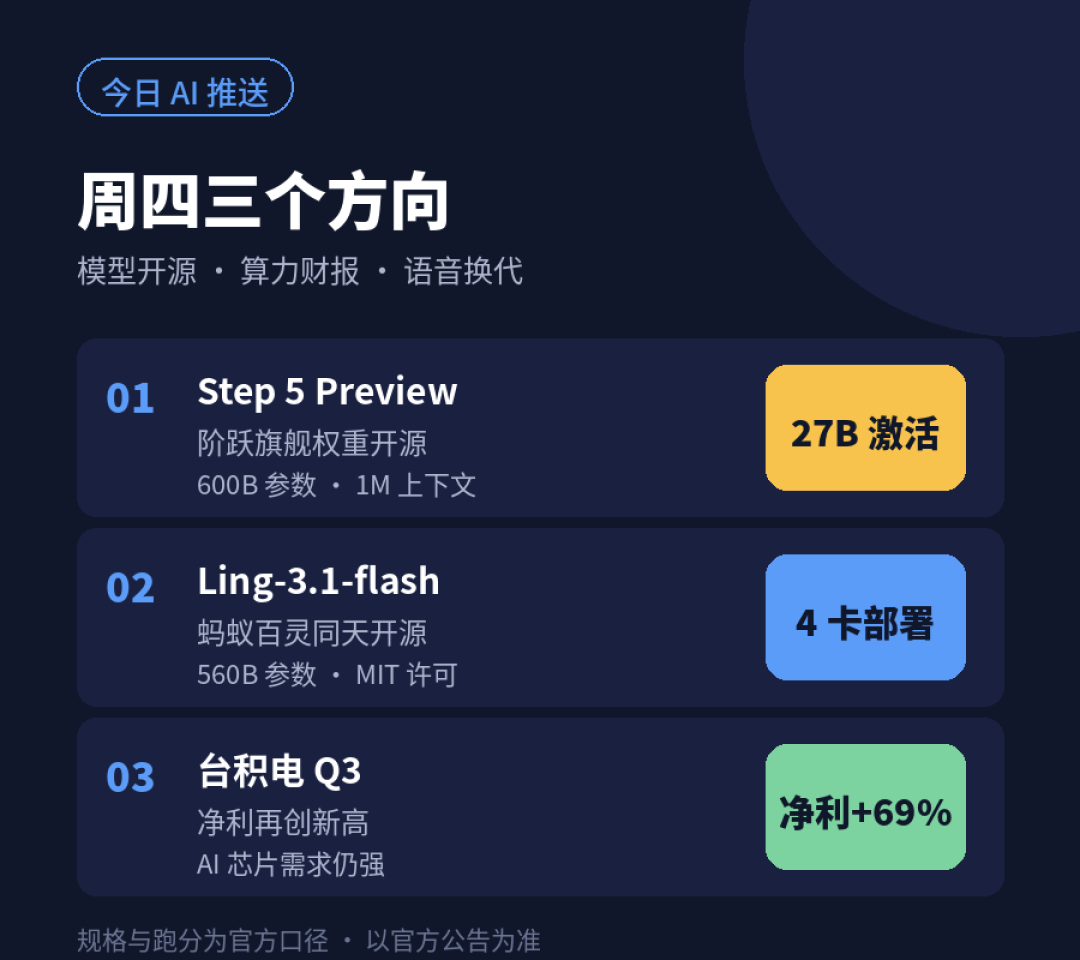
第三,发布潮和目录征求意见撞在同一周,不是巧合。10月15日,阶跃Step5 Preview放出BF16/FP8权重,总参数600B、单token激活27B、100万上下文,技术博客和配套开发工具一起开源。同一天,蚂蚁把560B大模型开源,MXFP4一刀切掉一半显存、4卡就能跑。 Meta的Muse Spark Open也挤进了这一天。知乎36氪
10月16日,英伟达投资的Reflection把首个开放权重模型Beam的检查点挂上开源社区,总参数501B、激活23B。消费侧的数据也同向:OpenRouter截至10月11日那周烧掉172.0万亿token,环比再创新高,DeepSeek一个模型单周41万亿的消耗量。知乎知乎
厂商抢在规则落定前把权重"公共领域化",观察者也别把这一周只当发布周看。
四、不同人这周到11月15日该盯什么
个人自部署玩家:基本无感。装权重、微调、本地跑,都在"公共领域技术"和"端侧轻量化部署不属于管理范围"的口径之内。真正有变化的是供给侧:会有越来越多公司抢在窗口期把权重放出来"先公开",可白嫖的免费权重变多了——记得用第二节的顺序评估:许可、账本、跑分。
做开源项目或公司出海的人:这是你们该读原文的一份文件。到11月15日征求意见截止前,盯三个执行细节:①"发表技术报告/训练代码"算不算进入公共领域,还是只有权重公开才算?②出口前登记的具体流程和口径;③"全球前十"这个门槛挂钩哪个评测榜单——同一个底模在不同harness里排名能差出十几位,知乎讨论已经把"不存在一个天然的全球综合前十"这层不确定性挑明了。有直接利害关系的,走公告的征求意见渠道提意见,这条通道是留着的。知乎
生态观察者:看两边的下一步。美方盯蒸馏指控会不会从"表态"变成"规则"(目前没有任何司法认定);中方盯目录何时从征求意见稿落地、"开源便利措施"会不会原样写进正式文本。
写在最后
30年前,"开源"是社区对抗封闭的姿态;这一周,它出现在商务部的答记者问里,也出现在硅谷巨头的联署信里。当规则开始引用一个词,这个词就不再只谈理想——它变成边界、成本和一个有时效的窗口。窗口到11月15日。先读公告原文,再判断哪一条和你有关。