

点击上方蓝字关注我,加个🌟标不迷路。
大家好,我是 cxuan。
刚刚,Qwen 在社交媒体上公布了一个令人激动的消息。
Qwen3.8-Max 来了!我之前就测试过 Qwen3.8-Max Preview 的性能,超过了我的期待,今天 Max 正式版也来了!
 image-20260803110411226
我一直就在**和平常**跟大家透露这个事情,Qwen3.8-Max 毕竟是阿里出品,阿里的工程质量没得说,所以 Qwen3.8-Max 的最大优势就是它的工程能力。
我之前也写过测评,并且用 Qoder CLI + Qwen3.8-Max Preview 也测试过,所以我觉得我还是有点说服力。。。
Qwen-3.8 Max 实测,确实有点东西。
用国产 Claude Code + Qwen 3.8 肝了两天项目,才花了 6 块钱
这是目前 Qwen 家族中最强大的模型。这也标志着 Qwen-Max 级别的模型将首次开源权重,下周就开源权重。
Qwen3.8-Max 的参数规模是 2.4 T,在编程、办公、科研以及长周期任务等方面实现了全面提升。
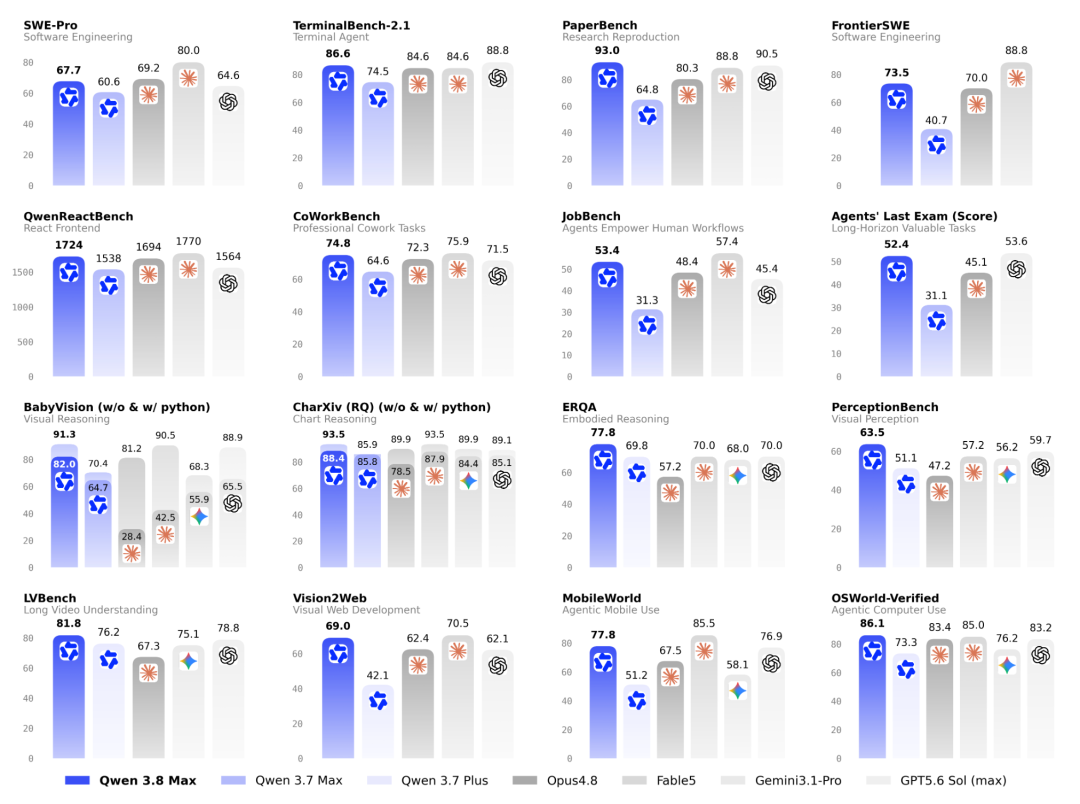
看一下测评分数。
图源:Qwen 官方博客
Qwen3.8-Max 没有在每一项上拿第一,但它的工程能力很均衡。
它在 PaperBench 上拿到 93.0,超过 Fable 5 的 88.8 和 GPT-5.6 Sol 的 90.5;OSWorld-Verified 是 86.1,也高于图里的其他模型。ERQA、PerceptionBench、LVBench 这些视觉理解和长视频任务同样领先。
编程榜单里能够体现 Qwen3.8-Max 的优势。
SWE-Pro 上 Qwen3.8-Max 是 67.7,低于 Fable 5 的 80.0;FrontierSWE 是 73.5,也低于 Fable 5 的 88.8。到了 PaperBench、QwenReactBench、终端任务和 CoWorkBench,它又回到了第一梯队。
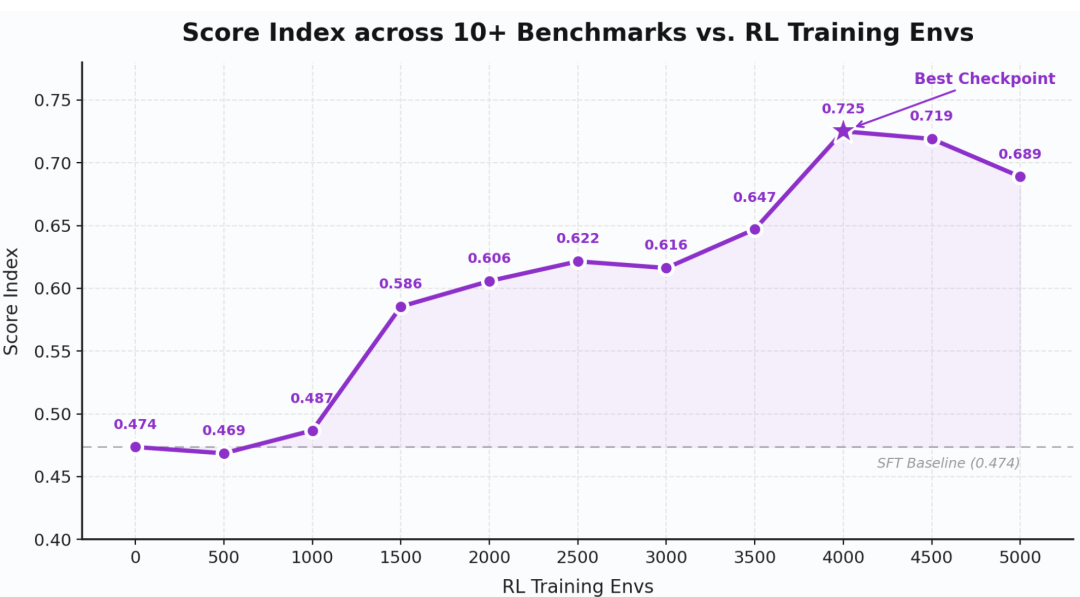
Qwen 还公开了 RL 训练环境扩展后的分数变化。
环境从 SFT baseline 一路扩到 4,000 个左右时,综合分数从 0.474 涨到 0.725。后面继续扩到 5,000 个,分数反而回落到 0.689。
图源:Qwen 官方博客
从图上看,4,000 个环境附近达到了最高分,继续增加反而回落。关键还在任务分布和训练数据的平衡,官方最后选择了分数最好的 checkpoint。
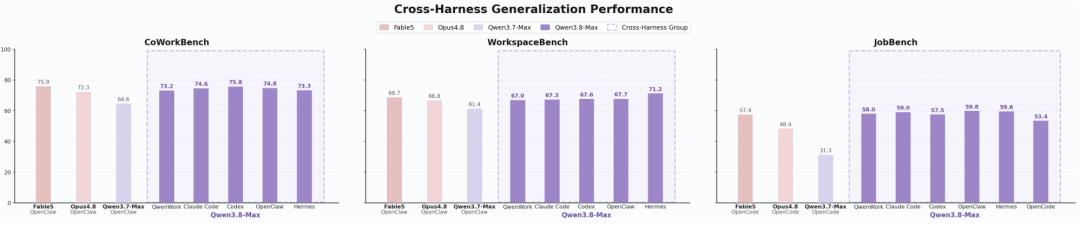
另外一张图更符合我说的工程能力。
同一个 Qwen3.8-Max 放进 QwenWork、Claude Code、Codex、OpenClaw、Hermes 等不同 Harness,CoWorkBench 基本稳定在 73.2 到 75.8,WorkspaceBench 也稳定在 67 左右。
图源:Qwen 官方博客
模型接到不同工具上,性能没有大幅衰减。这个细节意味着它更适配现有的开发流程,没有只依赖 Qwen 自己的 Harness。
官方给了几个测试案例
自主编程:超过 10 天的自我演化开发,从空文件夹到生产部署无需人工干预,完整项目追踪见 GitHub:https://github.com/qwen-code-dev-bot/oh-my-cli
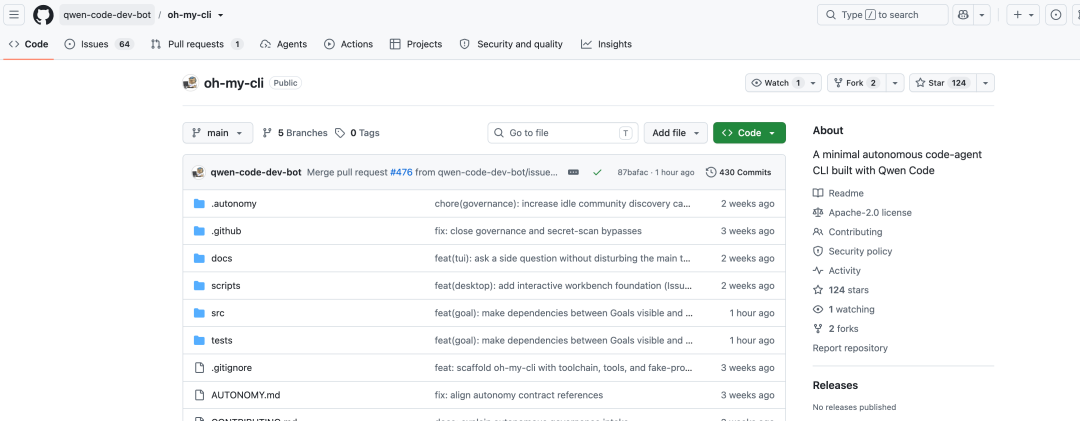 image-20260803133814766
另一个科研案例。Qwen3.8-Max 从论文和一组 GPU 开始,连续工作约 125 小时,写了约 7,600 行代码,执行 1,100 多个动作,完成 33 轮 GPU 训练。它先复现论文,再自己提出 18 个改进想法,最后把 AIME24 的结果又提高了 2.71 个点。
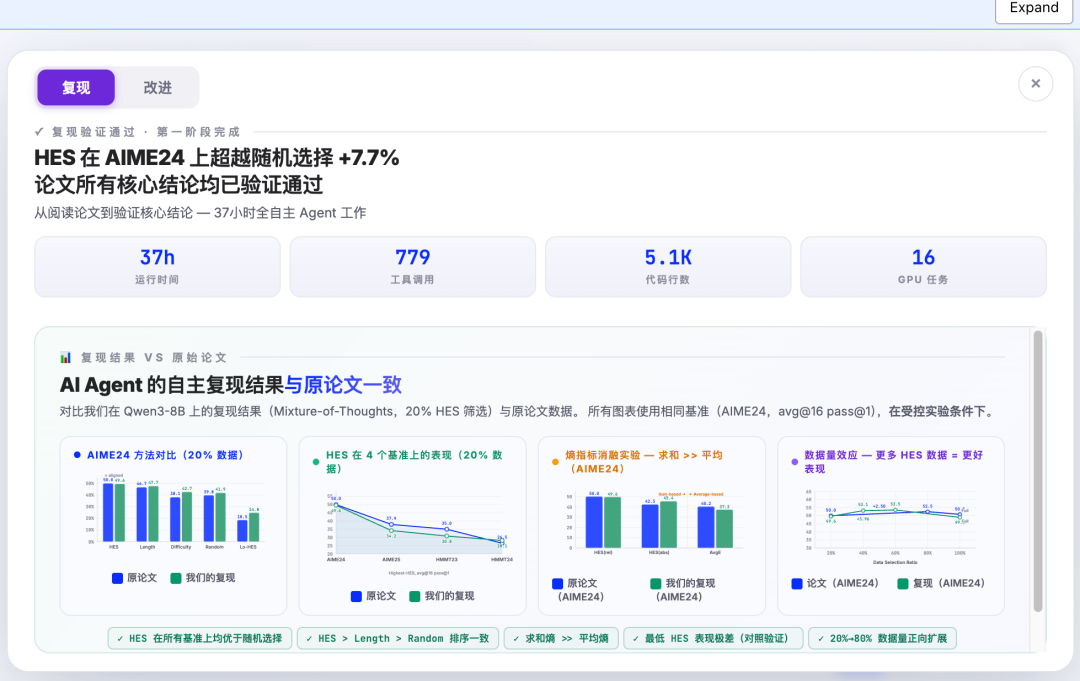 image-20260803134128071
真实工作,真实成果:跨越数百种职业的生产级交付成果。这里的案例也很具体:一次**数百份文档,找出 1,284 条合规条款,一小时内完成;从一套图纸重建 30 层办公楼的抗震结构模型;把 2D 康复评估表变成可旋转的 3D 交互演示;把约 8,400 个攻防回合整理成球员战术报告。
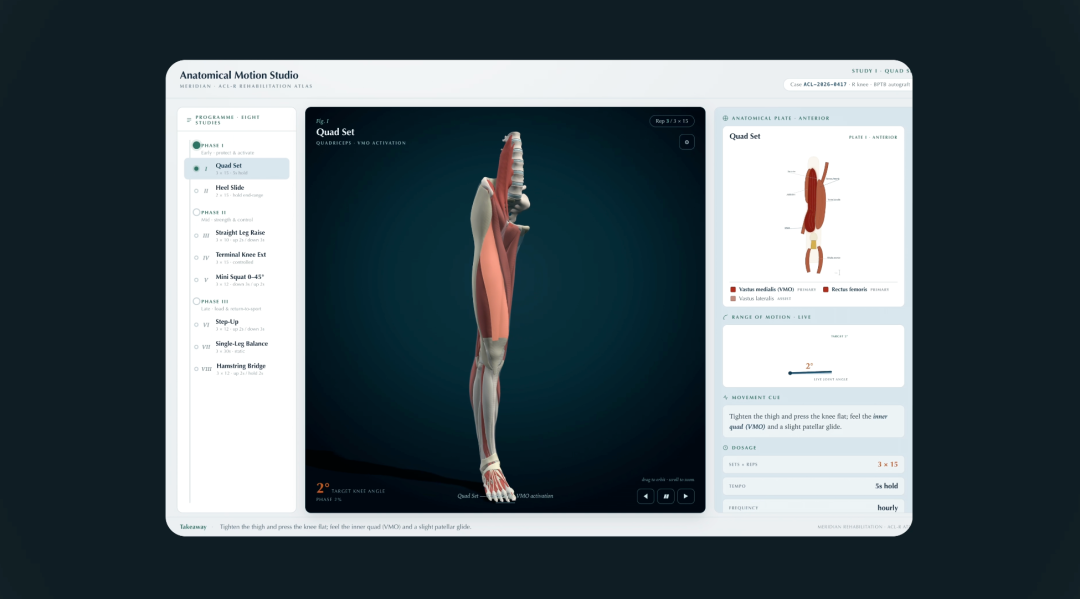 image-20260803134423273
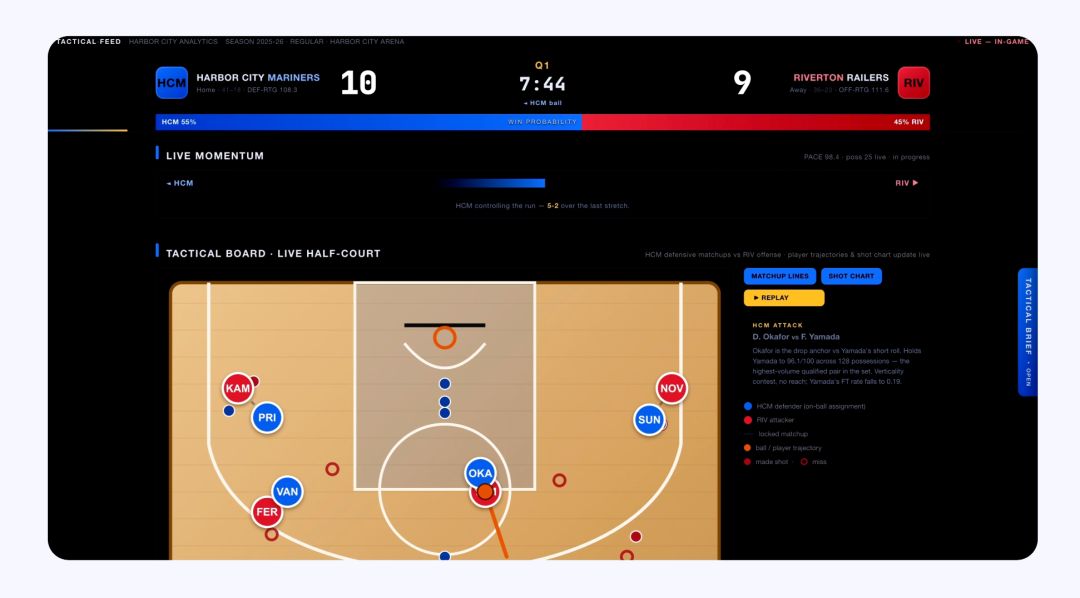 image-20260803134503969
长时程掌握:系统级自主规划,结合闭环自适应学习,推动 500+ 轮芯片设计优化和 365 天电商策略制定。
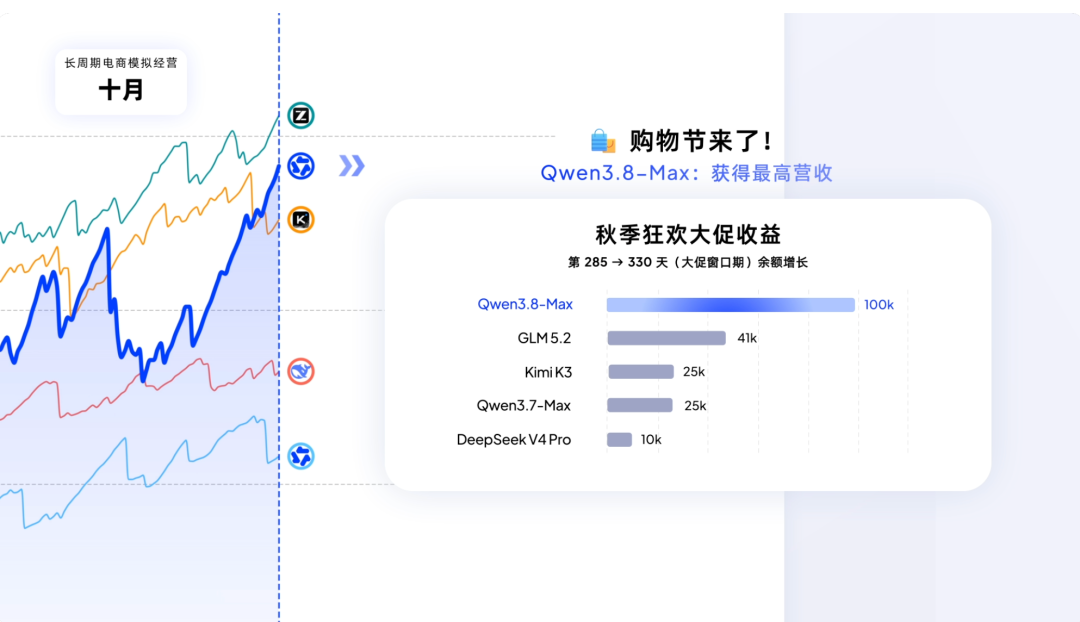 image-20260803134605893
芯片案例里,模型从 8,298 个门一路优化到 678 个门,最终版图面积缩小 81%,并在 500MHz 下完成时序收敛。电商模拟则持续跑过 2,000 多轮交互,全年最终余额做到 416,252 元,回报达到 4.16 倍。
原生多模态智能:视觉不仅是输入,它是规划、执行和自我修正的持续反馈循环。 官方给的场景已经扩到 200 多页的复杂 PDF 和 100 小时以上的视频。
定价需要和其他大模型对比下。
QwenCloud 的标准 API 价格是:输入 2 美元/百万 Token,输出 6 美元/百万 Token。
我把同一批旗舰模型放到一起算了一遍:
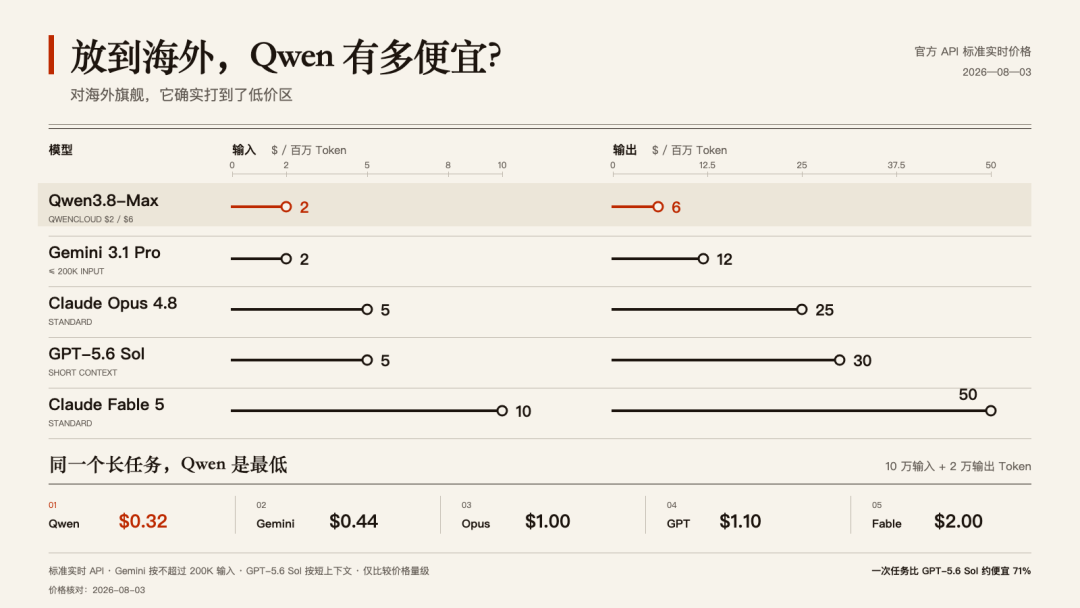 Qwen3.8-Max 与主流旗舰模型 API 定价对比
Qwen3.8-Max 的输入价和 Gemini 3.1 Pro 在 200K 以内的价格相同,但输出只有 Gemini 的一半。和 Claude Opus 4.8 相比,输入便宜 60%,输出便宜 76%;和 GPT-5.6 Sol 的短上下文标准价相比,输入便宜 60%,输出便宜 80%。
不过,只和海外模型比还不够。把 Kimi、GLM 和 DeepSeek 拉进来以后,会得出来更明显的结论:Qwen3.8-Max 对海外旗舰确实便宜,但在国内旗舰里并不是价格最低的。
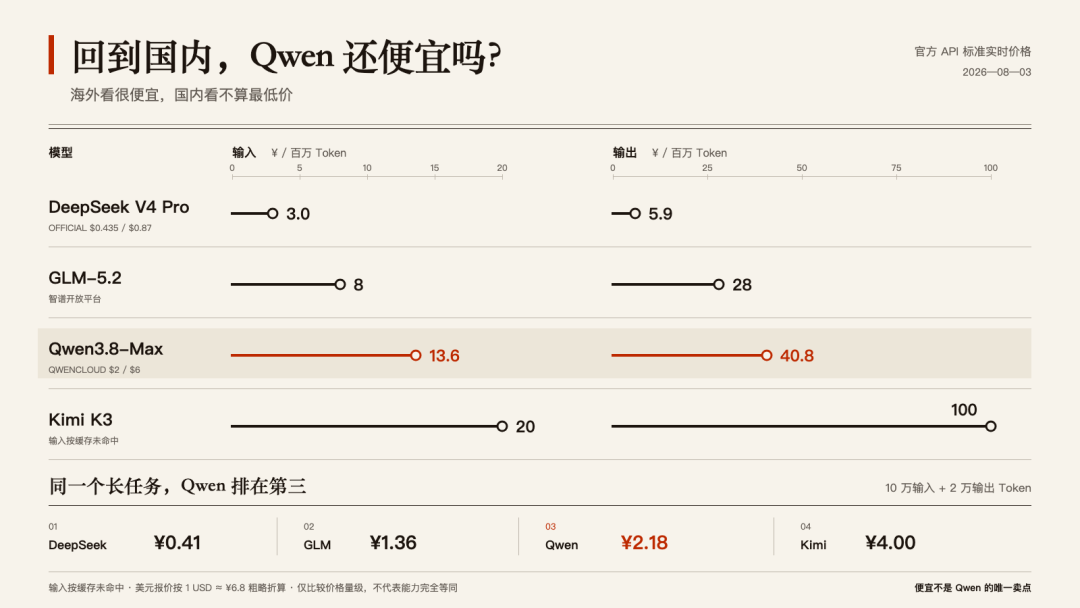 Qwen3.8-Max 与 Kimi、GLM、DeepSeek 国产旗舰模型 API 定价对比
还是按一次 10 万输入、2 万输出的长任务算,DeepSeek V4 Pro 约 0.41 元,GLM-5.2 约 1.36 元,Qwen3.8-Max 约 2.18 元,Kimi K3 约 4 元。也就是说,Qwen 在这组国产旗舰里排在中间:比 Kimi 便宜,但高于 DeepSeek 和 GLM。
这反而让它的定位更清楚了。Qwen3.8-Max 卖的不是国内最低价,而是第一梯队能力、1M 上下文、原生多模态和现成工具兼容性,价格又明显低于海外同档旗舰。
Qwen3.8-Max 这次没有靠一个榜单分数来讲故事。而是融入到了实际的场景中,这符合大家对实际场景的需求。
官方把 16 天编程、125 小时科研、数千轮策略模拟和跨 Harness 结果都摆了出来,想证明它能在长任务里也能持续工作。
然后再配上 2 美元输入、6 美元输出的价格。
这次 Qwen3.8-Max 就像说明白一个事情:
能把任务做完,并且把每次价格压到团队敢于使用,才是工程模型真正的竞争力。
这就是我看好 Qwen3.8-Max 的原因。
资料来源Qwen 官方 X 帖Qwen3.8-Max 官方博客QwenCloud 模型与定价页DeepSeek API 模型与定价智谱开放平台产品价格Kimi K3 模型定价
当前文章无评论,是时候发表评论了