




3
5
端侧AI的真相:不是取代云端,而是算力、功耗、精度的不可能三角
2026-09-15 10:53:27
0点赞
0收藏
0评论
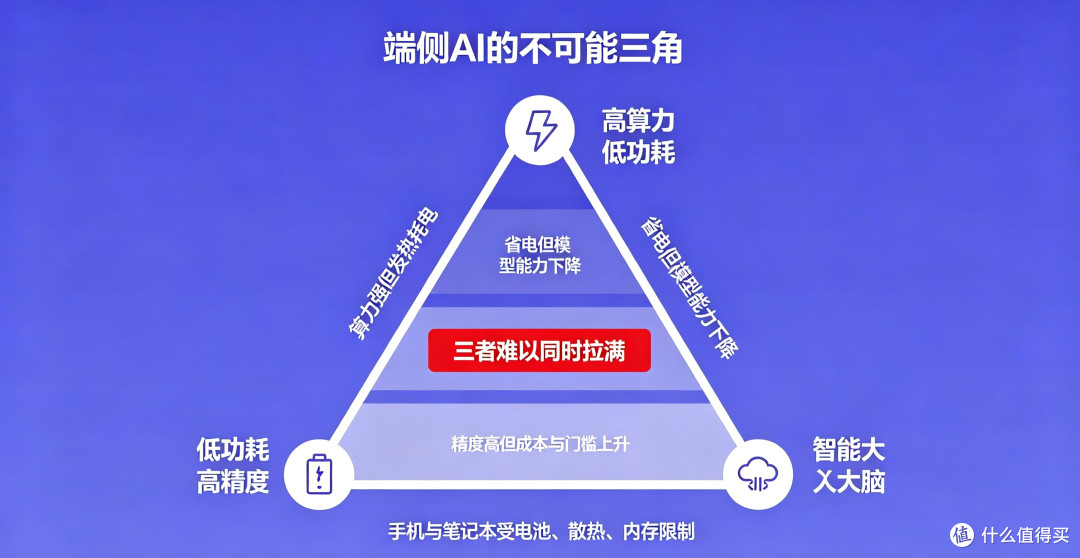
几乎所有2026年的新款手机、AI PC,都把端侧AI当做核心卖点。宣传里描绘出一幅美好的图景:大模型完全跑在本地设备,不用联网、保护隐私、响应飞快,摆脱对云端服务器的依赖 。但回到真实使用场景,很多用户会发现,发布会演示很惊艳,日常使用却遭遇发热、耗电、智能程度不足的种种问题。端侧AI不是骗局,但它被大量营销放大,它的本质是一场持续在算力、功耗、精度三者之间做取舍的技术博弈,三者很难同时做到最优 。
端侧AI拥有云端无法替代的先天优势。第一是低延迟,数据不用远距离上传服务器,图片处理、文本摘要、录音转写可以毫秒级完成;第二是隐私保护,个人照片、聊天记录、录音原始数据留在本机,不必上传公网;第三是离线可用,地铁、隧道、没有信号的环境依旧可以工作;同时还能大幅降低厂商云端token调用成本,这也是各大终端厂商大力押注端侧的核心动因。
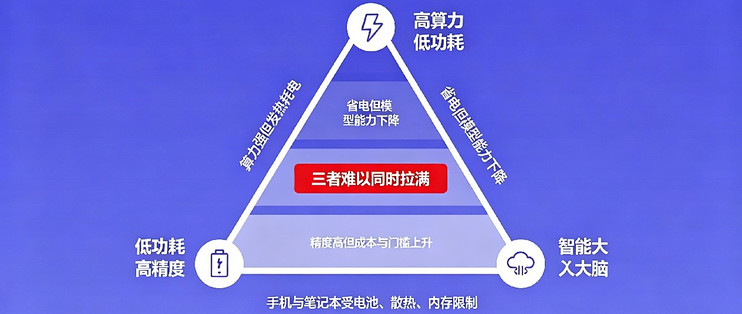
然而理想很丰满,硬件的物理枷锁很难突破。手机、笔记本都是电池供电,散热空间极其有限,这是绕不开的硬约束。想要本地运行更大参数的模型,就要消耗更多算力,算力直接转化为功耗与发热。实测情况下,7B参数大模型在手机持续高频推理,功耗甚至高于大型手游,长时间运行机身明显发烫,系统为了保护硬件就会触发温控降频,推理速度直接断崖式下跌 。
这就形成行业公认的“不可能三角”:想要模型足够聪明,就要放大模型参数,代价是耗电发热、占用大量内存;想要省电低温,就必须压缩、量化模型,模型的逻辑推理能力、多模态理解能力随之下降;想要兼顾性能与功耗,硬件成本就会飙升,无法下放到中端、入门机型 。
很多人分不清“真端侧”和“伪端侧”。市面上大量所谓端侧AI,属于混合模式:简单摘要、图片处理在本地完成,一旦遇到复杂提问、深度逻辑推理,后台悄悄切换调用云端大模型。断网之后功能直接大幅缩水甚至失效,用户很难感知这个切换过程。真正纯粹的端侧大模型,受限于设备内存,只能运行经过深度压缩的轻量化版本,和云端千亿级基座模型,能力存在量级差距。复杂数学推演、长文档深度分析、严谨的逻辑任务,现阶段本地小模型依旧很容易出现幻觉与逻辑错误。
内存也成为端侧AI另一道高墙。7B量化之后的模型本身就要占用数GB存储空间,运行推理还需要额外预留大量运行内存。想要流畅跑本地大模型,手机内存最好16GB起步,AI PC普遍建议32GB。大量存量8GB‑12GB设备,硬件层面就很难完整承载端侧大模型,这也意味着,绝大多数老机型无法享受完整端侧AI体验,间接推动硬件迭代换新。
于是“端云协同”成为当下行业主流方案,也是一种现实妥协。简单、高频、隐私敏感的任务交给本地端侧处理;复杂推理、深度创作交给能力更强的云端。二者互相配合,而不是端侧完全取代云端 。但这套模式同样存在痛点,什么时候切本地、什么时候上云端,调度逻辑复杂;网络波动时,会出现响应卡顿、输出质量不稳定;同时开发者要同时适配两套体系,开发成本成倍抬高。
从落地现状看,真正好用、高频刚需的端侧功能,集中在明确的轻量化场景:照片路人消除、截图识别提取文字、录音实时纪要、离线翻译、消息摘要。而复杂自主Agent、深度长文本推理,目前更多停留在演示与尝鲜阶段,普通用户日常使用率并不高。
对于普通消费者,要学会理性看待端侧AI卖点。不要迷信NPU的TOPS纸面算力,峰值算力不等于持续可用性能。不要单纯为了端侧AI盲目更换手机,如果你手上设备内存低于16GB,即便系统更新开启端侧,体验也会大打折扣。分辨产品是真正本地运行,还是“端侧外壳+云端内核”,最简单的测试办法就是直接关闭网络,观察AI功能是否还能完整工作。
站在产业长期视角,端侧AI不是一场概念炒作,是确定的技术大方向。未来随着模型压缩技术、芯片NPU能效持续进步,终端本地的智能能力会稳步提升。但短期之内,它不会实现“单机拥有超级大模型”的幻想。
端侧AI的正确定位,不是打败云端,而是做互补。本地负责快速、隐私、离线的轻量任务,云端承担高难度的复杂思考。端云协同,才是未来数年AI终端的真实模样。