你大概见过这种 AI:一道并不难的题,它写了大半屏“让我再检查一下”,绕来绕去,token 用完,答案没出来。你以为是模型能力不行。MIT 的一项新实验说,有时候它只是卡住了。
11月2日,MIT CSAIL 的四位研究者公布了一组实验:让 GPT-6 Astra 直接读 Qwen3.5-0.8B 的权重,找出它数学差的原因。这个0.8B小模型有个官方模型卡里就写着的毛病——思考时容易陷入循环。实验里,它前96条练习回答有85条写满了32768个token。 MATH-500 有93%的回答撞到长度上限。 它的7.9%不是“一道题都不会”,是大部分答案根本没机会写完。量子位知乎
Astra 干的事很具体:它在第15层和第19层的 MLP 里找到一个反复把模型推回循环的方向,从每层64个输出列里把这个方向减掉,一共改了131,072个权重,占整个模型的0.016%。 没有梯度,没有训练。改完,MATH-500 撞上限的比例从93%降到33.1%。MIT CSAIL知乎
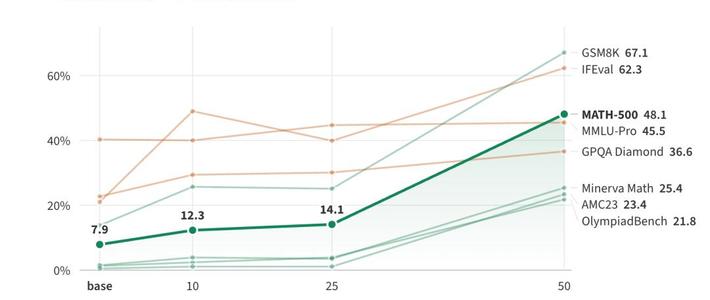
分数从7.9%升到48.1%,GSM8K 从13.8%到67.1%,连没让它优化的指令遵循 IFEval 也从21.0%升到62.3%。MIT CSAIL
这就是“6倍”的来源。它更像拆掉了一堵挡在模型前面的墙,而不是给模型装了六倍大的脑子。
研究团队自己留了个对照:Gemma 3 270M,很少循环,只有8.5%的回答撞上限。Astra 对着它改,MATH-500 从6.8%最高只到7.7%。 作者写得很克制:编辑权重能移除遮挡能力的障碍,但不能增加模型原来没有的能力。MIT CSAIL
那普通用户能得到什么?
今天,几乎什么也得不到。这不是 ChatGPT 里能点开的功能,也不是一次产品更新。被改的是 Qwen,不是 Astra;Astra 在这里是拿手术刀的那一个。你能接触到的,是一篇博客、公开的实验日志,以及作者放在 Hugging Face 上的修改版0.8B模型和 demo。 想去试试它做数学题还会不会绕圈,这大概是今天唯一能亲手验证的部分。MIT CSAIL
而且这把刀很贵。公开日志显示,效果最好的那次运行花了20.3小时,中间还等了4.7小时服务恢复。 只给10次和25次前向预算的两次运行,分数只到12.3%和14.1%。三次运行各自找到的修改都不一样,作者没有证明48.1%能稳定复现。知乎上一位用户照着重跑,说烧掉了200美元订阅额度和半周用量,效果不如预期。知乎
以后呢?如果“找那一刀”能变便宜,最先受益的可能不是聊天框里的旗舰模型,而是你手机里、电脑上跑的小模型。它们的毛病通常很具体:爱复读、爱绕圈、一句指令怎么都听不懂。传统做法是重新训练或换模型;权重空间编程给的画面是,定位到那一小段,打个补丁。模型不用重训,也不用先攒一批标注数据。再往后,同样的能力还能用来检查一个开源模型有没有被植入奇怪的行为——当然,也能用来植入更难发现的行为。
但这些都是“如果”。现在,定位一次故障要一个前沿模型跑十几二十个小时,还得靠搜索和试错。这个成本,暂时不像是一门面向普通开发者的生意。
所以,这次实验对普通用户最有用的一句话,不是“AI 能给自己升级了”,而是:你遇到的那些“这 AI 怎么这么笨”,有一部分不是能力上限,是故障。故障可以修,能力不能凭空长。下次再看到“某模型暴涨6倍”,先问一句:它是变聪明了,还是终于把话说完了。