北京时间11月4日早上6点,S16英雄联盟全球总决赛首场八强BO5在TES与IG之间开打,对阵与开球时间在11月1日抽签当天就已公布。同一场比赛,AI们先吵了起来:B站11月2日的八强AI预测视频里,仅豆包给出的预测就让UP主直呼"豆包的预测我很怕"。该视频评论区有用户晒出对两个模型的提问结果,DeepSeek给TES3-1IG,豆包给TES3-2IG,胜负方向一致、比分对不齐。把时间拉回今年9月17日冒泡赛,豆包对TES对IG给出的"最可能"赛果还是IG3-2TES。真实比分却是TES3-1拿下。预测差这么多,不是哪个模型坏了:大模型"算"比分,本质是在写一篇议论文——知识截止时间不同、能否联网不同、采信的证据不同,而TES对IG这场对决的证据,本身就是撕裂的。微博哔哩哔哩微博
两队今年各赢一个BO5,证据先天在打架
9月5日的LPL季后赛,iG鏖战五局淘汰TES。12天后的赛区资格赛,TES还了一个3-1。一年之内两个BO5互有胜负,一边是稳健运营、一边是激进上限,喂给任何模型,采信哪头都能自圆其说。世界赛上两队走的又是两套叙事:iG击败HLE成为本届首支战胜LCK的LPL队伍,战胜LYON后时隔2565天重返S赛淘汰赛。TES则在瑞士轮内战中淘汰BLG晋级。同一场对决,"该看IG的状态"和"该看TES的稳定性"各自成立——AI的分歧,只是把这种撕裂放大成了不同的比分。知乎知乎知乎
比分分歧不是孤例,跨项目、跨时间都在发生
9月11日主播宝蓝在直播里同时让ChatGPT与豆包预测iG季后赛:对AL两家都押iG3:2,对BLG却是ChatGPT给1:3、豆包给2:3。做"12个AI预测S16"系列的UP主张大喵,自己也承认这12个模型上一轮"平均只猜对一半"。他11月2日的八强期视频下,高赞评论总结了一个冷知识:从瑞士轮开始至今,这一系列AI没一次看好过TES。本届世界赛还有博主汇总过各家AI的八强名单预测,kimi押四支LPL队伍全部晋级,最终AL三战全败提前告别。微博哔哩哔哩哔哩哔哩
今年7月的美加墨世界杯,三款国产大模型预测冠军就已分叉:DeepSeek选法国、豆包选西班牙、kimi选法国。八强全部产生后的复盘差距更直接——DeepSeek8猜中8,天禧AI与ChatGPT7猜中8,Grok、千问、Gemini、豆包、Manus只有6猜中8。同一时间段的美国网球公开赛,IBM提供的官方AI模型看好高芙、佩古拉会师决赛,半决赛两场全部猜错。它给郑钦文的赛前胜率最低只有12%,她照样完成翻盘。微博微博微博
同一个问题长出不同答案,四个原因缺一不可
第一,生成机制使然。大语言模型内部没有赔率模型,也没有ELO评级,它是把训练语料里的"叙事"组装成一个看起来像预测的答案:采样温度让同一个模型两次提问就能给出不同比分,提问方式本身也是变量,7月就有用户吐槽豆包"比赛还没打,就给出了结果"。12-AI视频下的高赞评论也直言——只要把庄家盘口作为条件喂进去,结果基本就被提前锁死。第二,材料可达不均。9月17日冒泡赛开打前,流传的AI赔率押IG胜1.78对2.00、预测比分IG3比2TES,而当天TES刚换了BP教练,最终笑到最后的正是3-1的TES。这类临场变量,只有能实时联网检索的模型才"看得见",各家检索能力和信源质量又完全不同。微博微博
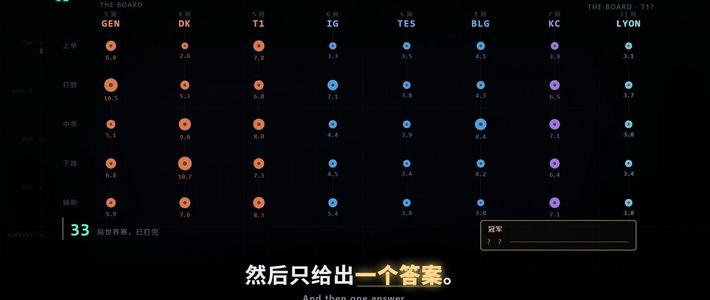
第三,幻觉会直接烂掉论证地基:有主播拿豆包解说世界赛,堂堂英雄联盟比赛被它聊着聊着拐进了篮球。队伍和选手名单答错也是家常便饭。第四,口径错读放大分歧:10月24日流传的AI夺冠概率模型榜里,GEN概率高达50%,TES与IG只有0.73%和0.86%。这是"11月15日捧杯"的概率,不是八强单场胜率,把它错当成赢下本场的概率,分歧感会被再放大一个量级。哔哩哔哩微博
与其等答案,不如看它列了什么证据
人类的判断同样没有共识:八强抽签后的二路直播里,教练朱开毫不犹豫地站队IG。AI预测视频下的热评却说"AI从瑞士轮开始没一次看好过TES",同样一批观众里拍脑袋押滔搏的也不在少数。比分没有权威,论证才有价值:对准备早起看BO5的观众,各AI列出的依据清单是现成的赛前速览——它有没有计入今年两个BO5互有胜负、看不看得到IG从资格赛一路打上来的状态、认不认为IG的激进节奏会被TES的运营化解。连做预测的UP主们都把话先说在前头:“仅供娱乐,切勿当真”。这些AI榜单和"金牌预言家"话题本来就是赛前信息整理,不是结果。11月4日早上6点开赛后,BP准备、临场调整这些模型看不到的东西都会在直播里揭晓;届时无论"豆包"还是"DeepSeek"更靠近答案,各家AI的S16战绩都会迎来新一轮结算。哔哩哔哩哔哩哔哩