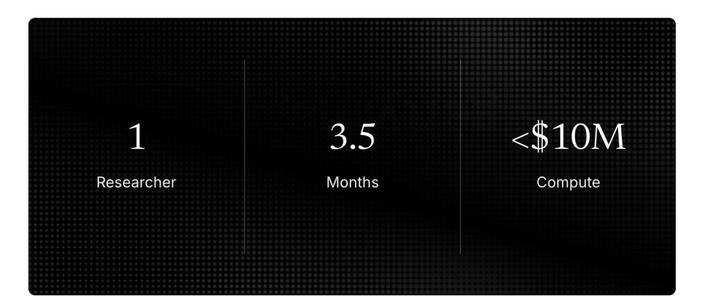
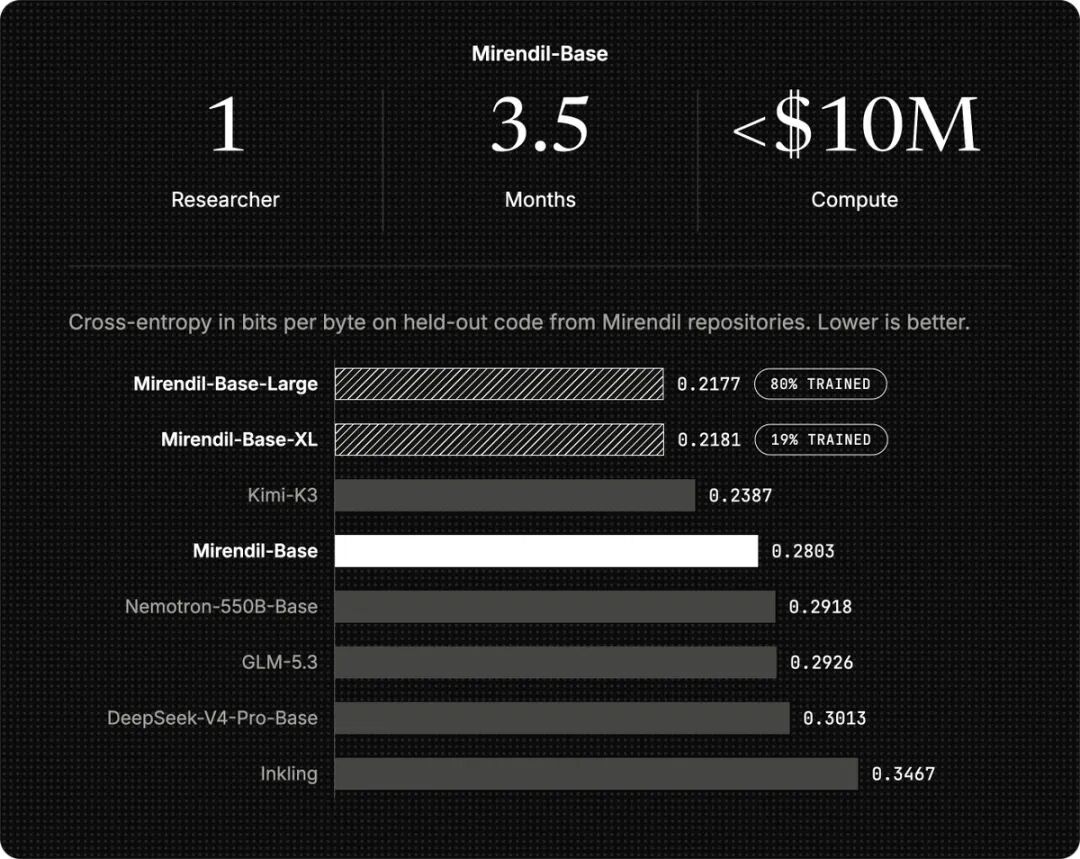
10 月 21 日,Mirendil 官网挂出一篇文章,标题译过来很直白:《无需预训练团队的大规模预训练》。标题下面只列了三个数字:1 名研究员、3.5 个月、不到 1000 万美元。字母AI新智元Mirendil
这在过去几乎不可想象。预训练一个能打的基座模型,开源团队要几十名专家,前沿实验室动辄几百人:有人研究架构和 scaling,有人清洗数万亿 token,有人守着几千张卡防止集群崩掉。
Mirendil 把这件事压到了一个人身上。他们做出来的是 Mirendil-Base,一个 1000 亿到 5000 亿参数的编码专用基座模型。
项目从空仓库开始,不用现成预训练框架,不继承代码,训练数据全部来自 GitHub 和公开网页,没有买数据、没有蒸馏、没有合成数据。
真正干活的是 Agent。官方说,超过 99% 的代码由 Agent 编写,实验由 Agent 跑,训练故障也由 Agent 诊断。那名研究员只做两件事:决定试什么,判断什么结果值得信。Mirendil
这听起来像“一个人加一群 Agent”的爽文。先看跑分。
在 7 个模型训练完成后才发布的外部代码仓库上,Mirendil 用 bits per byte 交叉熵做了对比。
对手是 Kimi-K3、GLM-5.3、DeepSeek-V4-Pro-Base、Nemotron-550B-Base。
分数越低越好。Kimi-K3 平均 0.193,Mirendil-Base 0.222,GLM-5.3 0.242,DeepSeek-V4-Pro-Base 0.243,Nemotron 0.247。字母AI
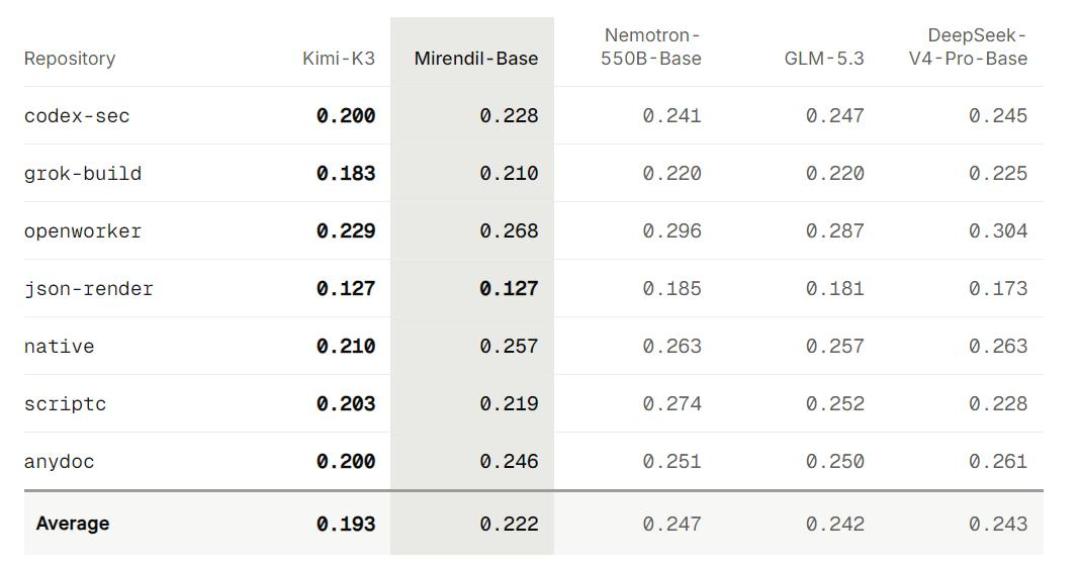
也就是说,在编码这个窄领域,它排到第二,落后 Kimi-K3,压过另外三个更大的 MoE 模型。
Mirendil 还放出了更激进的数字:Mirendil-Base-Large 只训了 80%,交叉熵 0.2177;XL 才训 19%,0.2181,都低于 Kimi-K3 的 0.2387。Mirendil
不过这是另一组“自家仓库留出代码”的测试,和外部仓库不是同一套题。
这里要泼一盆冷水。“硬刚 K3”的说法得打折。Kimi-K3、GLM-5.3 是后训练模型,而 bits per byte 这类指标通常对基座模型更友好;官方自己的图注也写了这一点。
再加上两组测试集不同、指标只看交叉熵,这些数字能说明它挤进了第一梯队,不能说明它全面超过谁。
但即便打折扣,这件事仍然值得警惕:一个基座模型,用一个人的判断力加一群 Agent,在 3.5 个月里从零搭完训练基础设施、架构、算法和数据管道。
最后还能和一线模型放在同一张表里比。过去这需要一支多年磨合的团队。
为什么现在能做到?因为“怎么训”这件事已经被趟平了。
常规预训练的配方已经彻底成熟且公开,架构、数据配比、训练流程,大量细节写在公开论文和技术报告里。Agent 又刚好补上了执行力——写代码、跑实验、看报错、改下一版。新智元
Anthropic 披露过,今年 5 月其代码库里超过 80% 的合并代码由 Claude 写。字母AI
OpenAI 也说过,研究部门记录的 Agent 工作量已达到每个“人类工作日”对应 3.1 个“Agent 工作日”。新智元
执行变便宜之后,瓶颈就换了位置:算力、数据,以及那个指挥 Agent 的人。Mirendil
这也是为什么“一个人”三个字容易被误读。Mirendil 的账并不便宜:不到 1000 万美元是全部算力开销,含 Agent 的 token 消耗和数据处理。Mirendil
背后是 2 亿美元种子轮和 10 亿美元估值。铅笔道
团队约 20 人,来自 Anthropic、xAI、Google DeepMind、OpenAI。机器之心
一个人是实验结果,不是普通团队的创业模板。
真正对开发者有参考价值的,是它把“能力”拆开的方式。写训练代码、调参、复现实验,这些执行层的活正在快速贬值;决定做什么实验、信哪个结果、什么时候停,这些判断层的活反而更贵。
Agent 能很快告诉你“这个指标涨了 3 个点”,但它不会主动告诉你,这 3 个点可能来自数据泄漏、加载器 bug、随机种子或者 tokenizer 不匹配。新智元
所以基本功不是不重要了,而是更重要了。你没法监督一个自己看不懂的系统。看不懂 loss 曲线为什么长那样,就分不清 Agent 交上来的是突破还是事故。
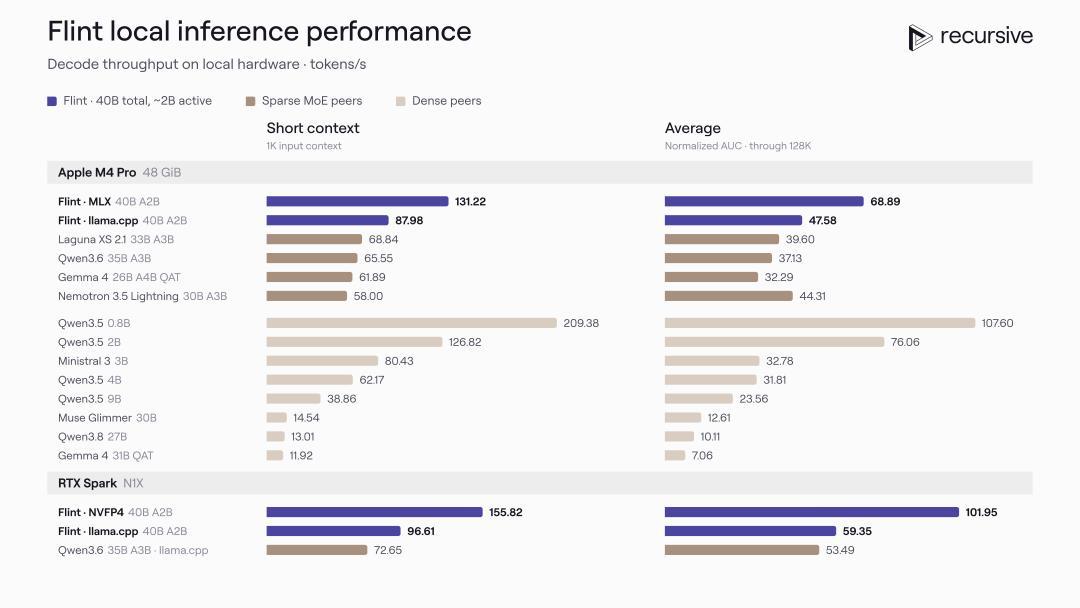
同一周还有另一条线。田渊栋的 Recursive 发布 40B 编程模型 Flint,短上下文下在 M4 Pro 上能跑到 125 token/s 以上。新智元
Flint 背后的 Eureka Machine 想自动完成“提想法—实现—测试—决定下一步”的研究循环。
Mirendil 把训练大模型这件事压进一个人的判断力,Recursive 把研究循环本身自动化。两条路指向同一件事:模型开发的执行层,正在被模型自己接管。
Mirendil 没有解决所有问题。它只是把一道原来模糊的题摆到了台面上:当写代码和跑实验都不再稀缺,一个模型开发者还剩下什么?
它的答案很直接——剩下判断。这个答案对刚入行的人不算友好,但至少比“等模型变强再说”诚实。