9 个主流大模型被拉进同一场 2D 物理造桥比赛,在 90 分钟里各自设计 7 关桥梁,最终 GPT-6.2 Sol 以 102.67 分夺冠。 Claude Opus 5.5(79.02 分)和 GPT-6 Astra(73.48 分)紧随其后,而从第 4 名开始总分断崖式跌到 45 分以下。真正拉开差距的不是"桥会不会塌",而是第 4 关之后:前 3 名之外没有任何模型能通过"船过时航道里不能有桥"这类需要动态机关的关卡,其余 6 家全部卡死在同一条分界线上。GitHubGitHub
这场比赛来自 B 站 UP 主"喵了个猫了个咪了个猫"11 月 8 日发布的《AI 算法对抗大赛》第 9 集《造桥》,发布不到一天播放量已超过 73 万。 和系列前几集"写 bot 对战"不同,这一集考的是纯工程:题目、裁判、模型交卷的原样代码和逐关成绩全部在开源仓库里。哔哩哔哩GitHub
比赛怎么判分:过关只是及格线,便宜才算本事
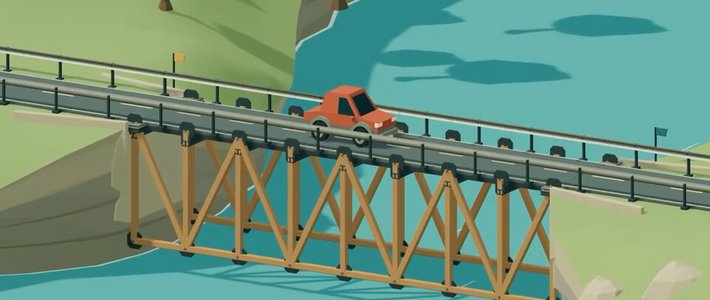
每位选手(模型跑在各自的官方编程工具里,比如 Codex、Claude Code、OpenCode)在一个独立工作目录里作战,拿到的是完全相同的选手包。 90 分钟,开局一次性拿到全部 7 关,时间怎么分配自己决定。 桥本身是一份 JSON 设计文件:自己定节点坐标,选用木杆、钢杆、钢索、弹簧、液压杆,还能加装压力板、光电门、红绿灯这类机关;小车只能开在路面杆件上,杆件受力超过上限就断。GitHubGitHub
判定用确定性的物理引擎,选手手上的本地模拟器和正式裁判是同一份程序,可以无限次试车,也没有隐藏题目。 但"能过"不值钱:关卡分 = 全部场景通过时按 100 × 参考造价 ÷ 自己的造价折算,没过或超预算直接 0 分,桥造得越省,分越高。 第 7 关再加一场攻防:每人交一座决赛桥和一辆专门撞别人桥的"捣蛋车",9 家两两对打 72 局。GitHubGitHub
分水岭在第4关:从搭桥到搭"会动的桥"
前 3 关(15 米水沟、30 米大峡谷、双向早高峰)考的是静态桁架功底,9 家模型几乎都能把车送过河,只是造价高下立判。真正的筛选从第 4 关"过船"开始:24 米宽的河中间留航道,船通过的时候航道里不能有桥,船过完了 4 辆车再按时开过去——桥必须是一座能被传感器、延时和液压机构控制、会开合收起的系统,而不是一堆杆件。 结果一目了然:只有 Sol、Opus、Astra 三家的设计在第 4~6 关全部通过验收,其余模型不是没过场景就是直接没交卷。 以总排名第 4 的 Gemini 4 Argon 为例,它前三关成绩不错,但第 4、5、6 关交出的桥一个场景都没过去;Grok 4.7 更极端,后两关干脆没交卷;Kimi、混元、豆包、DeepSeek 则集体在第 4 关折戟。GitHubGitHub
第 5 关"钱不够"把第一梯队内部也切开了:1 万预算、禁用木杆、左岸还有个旧码头坑,6 家里只有 Sol 一家过关。Opus 交出的桥造价 13472,被判超预算直接吃了 0 分。 Astra 也没好到哪去,造价 10199,同样压线失败。GitHub
同样过关,造价差出真章
闯关分维度上,Sol 六关全部通过且几乎关关比参考答案还便宜——第 2 关造价 7701.80,拿下单关 137.85 的超满分,六关平均 106.24 分。 Opus 和 Astra 早期关卡稳定,但第 4 关的造价比参考答案贵出四成以上,单关分数掉到 65~70。GitHub
垫底几家的问题更朴素:桥能过,但太贵。Kimi 第 1 关造价 6065(参考 3510),得分 57.87;Grok 第 3 关造价 12382(参考 7967),得分 64.35;混元在第 6 关地狱题交出 34497 的造价,超预算 70% 以上直接判 0。 这说明中后段模型的瓶颈不是"不会造桥",而是不会在材料、跨度和预算约束之间找最优解——这恰好常被用来区分"会写代码"和"会做工程"。GitHub
第7关攻防:最会搞破坏的不是冠军
72 局两两对打里被攻破 18 局,其中 15 局来自前三名派出的捣蛋车:Astra 的捣蛋车攻破 6 座桥,是全场最强"爆破手",Sol 攻破 5 座、Opus 攻破 4 座、Gemini 攻破 3 座,Grok、Kimi、混元、豆包、DeepSeek 五家的捣蛋车一辆桥都没攻破过。 Astra 的攻防分 87.50 因此高于冠军 Sol 的 81.25。防守端同样是第一梯队内卷:前三名全部 8/8 守住自己的决赛桥,第 4 名 Gemini 守了 7 局,而后段模型的桥普遍被头部捣蛋车撞穿。想造出一辆能精准打击别人结构弱点的车,对空间推理和物理直觉的要求比"造一座能过的桥"更高,中后段模型在这个方向上是集体空白。GitHub
这份榜单不能当能力表,但它可复现、可下场
必须先说清边界:每个模型只跑了一次,单次结果有偶然性,各家使用的工具、接入渠道和思考档设置都不同。 主办方在开源文档里写得很直白——不能把本场结果当作模型能力排名;关卡分以主办方参考答案为 100,它不是理论最优,超过 100 只代表比参考答案便宜。 Gemini、Grok 在别的任务上未必输给前三,这场比赛验证的是"纯靠设计文件 + 物理约束的工程交付能力"这一个切面。GitHubGitHub
但这个切面恰恰是用户最关心的那类问题:模型能不能在没人盯着、禁止联网、不能派子代理、看不到别人答卷、全部 7 关一次性发下来的条件下,自己规划时间、读懂规则、调试仿真、交出可验收的结果。而且成绩不是黑箱:全部关卡、9 位选手的原样交卷代码和逐局攻防数据都在仓库里,跑一条 `tournament/score.py` 就能逐项重算上面每个分数。 官网还开了可玩的网页版模拟器,普通人也能搭一座桥传上排行榜,和这些模型比造价。GitHub
如果只记一件事:第 4 关就是当前大模型工程能力的一道分水岭——能搭"会动的桥"的,目前场上只有 3 个。