AI写的代码一次跑通?别急着合:「能跑」和「可信」是两回事

源自18位全网作者

10:48

AI 编程里最容易闯祸的一句话,是「能跑就行」。

下午跟 Agent 聊得飞起,demo 顺滑,直接合主分支。两周后线上出故障,你打开代码,一行都不眼熟——这时候才明白,「能跑」只是可信的起点,不是终点。Cognition 刚发布的 FrontierCode 2.0 测评也在报警:换成 132 个真实开源仓库任务后,得分最高的模型也只通过了 45.5%。钛媒体知乎

为什么「能跑」不能单独信

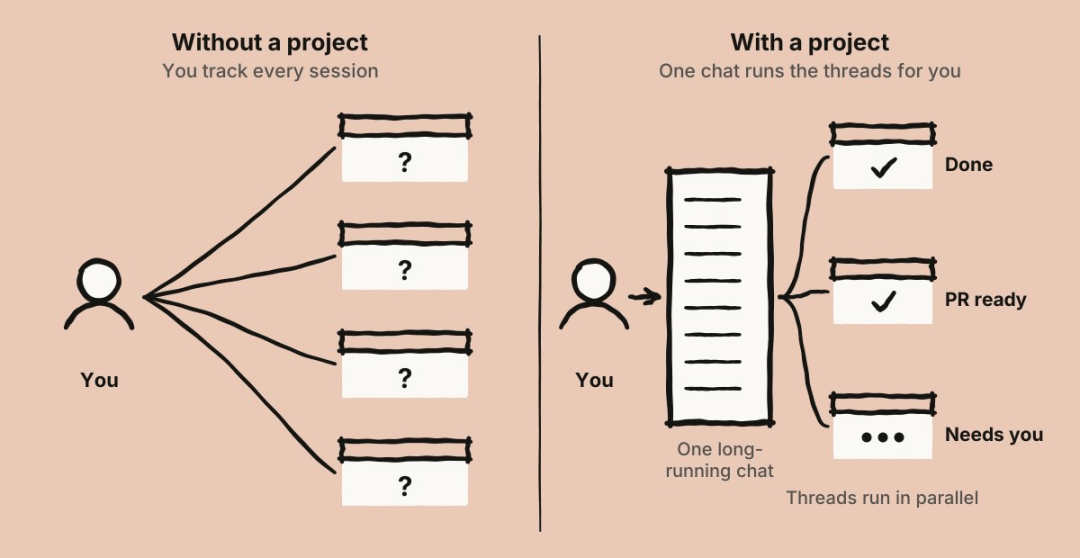
博主宝玉 xp 有个扎心的观察:当年人手写代码,一天平均几百行,质量差距有限;现在 AI 一泻几千上万行,数量加乘把方差撑大,人和人的产出差距比以往更大。拉开差距的不是手速,是判断力和责任心。微博

事故现场其实高度雷同。Grill Me Skill 作者 Matt Pocock 发现,Agent 爱「按层写」——数据库层全写完,再写应用层,最后写前端。每层单看都行,拼一起才出问题,因为 schema 设计早就决定了前端能展示什么。爱可可分享的《Vibe Coding》课件里也列了一串翻车案例:AI 生成的统计图完全正确、科研结论却错了。AI 说「测试通过了」,你还真不能全信。微博微博

维护的烂摊子更扎心。知乎上有人把这事说透了:AI 写的代码就像一堆「已离职老员工」留下的屎山,没人懂。细节你不掌握,系统出问题 AI 自己调试搞不定,兜底的还是你。知乎
AI写的代码一次跑通?别急着合:「能跑」和「可信」是两回事

给自己搭一套验证闭环,分五步

课件里那套工作协议值得直接抄:先定义规格再制定计划,先建立测试再修改代码,修改之后独立验证,确认可信之后再提交。
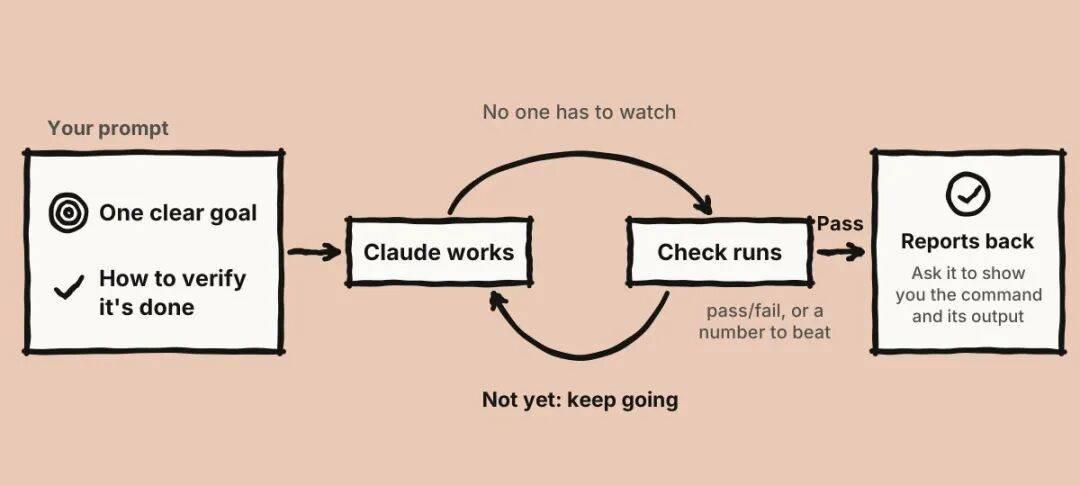
AI写的代码一次跑通?别急着合:「能跑」和「可信」是两回事

拆到日常,就五步:

  1. 动手前先写 Spec。别急着让 AI 开写,先把「做成什么样算成」用几行字钉死,再让它干活。

  2. 纵向切,别按层堆。借 Matt Pocock 的招:把 tracer bullet(追踪子弹)写进 prompt,让 AI 先把一条从数据库到前端、窄窄的路径跑通,确认可行再往两边扩。

  3. 测试先行。没有测试,AI 说「做完了」就只是一句聊天。

  4. 合并前只看四样:diff 意图、测试、敏感权限、秘密信息。B 站 UP 主零壹工坊的审查清单说得直白:需求有没有被误解,比语法对不对更重要。哔哩哔哩

  5. 给 Agent 上闸门。prompt 里写十遍「不要删文件」,真出事照样被 `rm -rf` 带走。用权限和 Hooks 挡高危操作,Git 回滚留作后悔药。知乎
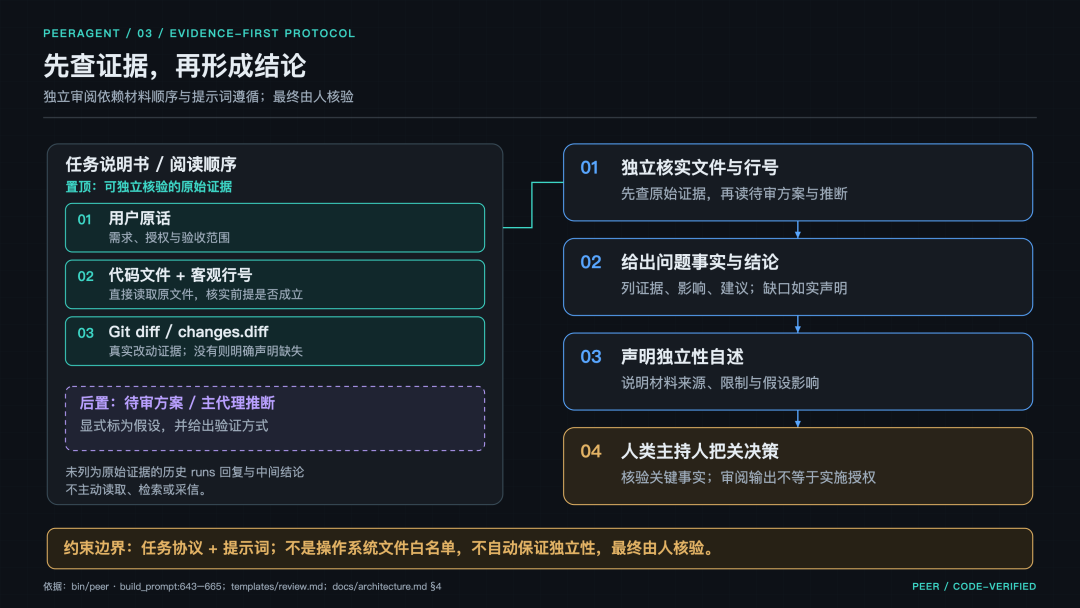
AI写的代码一次跑通?别急着合:「能跑」和「可信」是两回事

把判断留给自己

评论区被反复顶上来的是那句话。微博

代码可以不亲自写,结果必须自己负责。把执行交给 AI,把判断留给人。

AI 永远没法承担责任,出了事背锅的还是你。当代码生产越来越便宜,真正变贵的,是会定义问题、能验证结果、敢为结果负责的人。
内容由AI生成

精选参考来源

1. 跑代码易,做任务难:AI编程迎来交付能力大考

2. 132 个真实任务,AI 编程最高分 45.5%

3. “虽然大家都在用 AI 编程,但是代码产出水平方差反而比以往更大”,这确实是真实存在的现象。手写代码的年代,人写代码的产出速度是有限的,一天平均也就是几百行代码,但现在都是几千几万行甚至更多,质量更是差别很大,有了数量加乘,方差自然被撑大了。AI 把生成代码这一步的成本压到很低,执行不再是瓶颈之后,拉开差距的就是技术判断力和责任心了。技术判断力指的是:知道该做什么、知道做到什么程度算好、知道怎么验证。责任心则是作者说的“尽责”。如果你自己理解需求、自己做设计判断、用 AI 生成、自己审查、自己测试,确认没问题再交给同事,这和手写代码的年代没有任何区别,同事 review 的是一份你已经负过责的产出。技术判断力差一点还能补,至少可以借助 AI 反复分析、检查能把问题降到最低。最差的就是只做了中间生成代码那一步,把前面的需求分析、设计和后面的验收都跳过了,AI 生成的代码直接提交,审查的成本、踩坑的成本、日后维护的成本,全部转嫁给团队其他人。这样的人从代码量看确实产出惊人,但实际上是在用 AI 批量生产别人的负债。AI 终究没办法承担责任,代码出了问题,背锅的还是人。

4. 分享昨天给研究生上课用的一套关于AI编程的完整Slides:《Vibe Coding:从“代码能跑”到“结果可信”》它不是一套“教你几个 Prompt 技巧”的课件,而是试图回答一个更重要的问题:当 AI 已经越来越会写代码,人还应该掌握什么?我用一系列非常具体的“翻车案例”来展开:• AI 生成的统计图完全正确,科研结论却错了 • Prompt 写得很长,为什么 AI 还是越做越偏 • 缺失值被悄悄处理,结果为什么会失真 • 修一个 Bug,为什么最后变成重写整个项目 • Agent 到底比普通聊天多了什么 • Context、Tools、Memory、Tests 分别解决什么问题 • 为什么“不要删文件”远远不如真正限制权限 • AI 说“测试通过了”,为什么还不能相信 • 怎样用 Spec、Test、Diff、Git、Rollback 建立可信开发闭环 • 科研代码怎样做到可复现、可审查、可交付Slides 里还系统整理了:Prompt Engineering → Context Engineering → Agent Architecture → Verification → Permission → Reproducibility以及一套我比较推荐的 AI 编程工作协议:先定义规格,再制定计划; 先建立测试,再修改代码; 修改之后独立验证; 确认可信之后再提交。越来越觉得,AI编程真正重要的并不是“以后还要不要学编程”。真正的问题是:当代码生产越来越便宜,什么能力会变得更贵?我的答案是:问题定义、系统判断、验证能力,以及为结果负责的能力。最后把 Slides 里的两句话也送给大家:代码可以不亲自写,结果必须自己负责。把执行交给 AI,把判断留给人。Slides 适合研究生课程、AI 编程入门、教师培训以及自己系统学习。欢迎转发给正在用 Cursor、Claude Code、Copilot 或各种 Coding Agent 的同学。在线浏览:aicoco.net/s/vc90

5. Grill Me Skill 的作者 Matt Pocock 在访谈时也是这么认为的,软件工程很重要。他说在折腾 AI 编程的过程中,碰到一个很烦人的问题。Agent 写代码的时候,它会先把整个数据库层写完,再写整个应用层,最后写整个前端。每一层单独看还行,但拼到一起就出问题。因为数据库里的设计会影响前端展示,你得让这些层早一点对上才知道合不合理。可 Agent 总是最后才开始组装。他觉得这样不行。然后他翻出了书架上一本一直没拆封的《程序员修炼之道》。他说这本书他买了之后一直没看,还包着塑料膜。翻开以后,几乎每一页都觉得像是写给今天的。里面有一个概念叫 tracer bullet,追踪子弹。意思是做一个功能的时候,不要按层来,要纵向切一刀,从数据库到应用逻辑到前端,先把一条窄窄的路径跑通,确认可行之后再往两边扩展。他把这个词写进了给 Agent 的提示词里。然后他发现了一件有意思的事:Agent 开始在自己的推理过程中主动使用这个词了。它会说「好的,我把这个做成一个 tracer bullet」。他管这个叫 leading word,引导词。因为这些经典编程书籍几乎肯定在模型的训练数据里,当你在 prompt 里用了这些专业术语,就相当于激活了模型脑子里对应的那片知识。他又从《软件设计哲学》里捞出了 deep modules 这个概念,从《领域驱动设计》里拿到了 ubiquitous language 的思路。他发现这些二三十年前的老概念,到了 AI 时代反而更好用了。#科技先锋官# #How I AI#

6. AI 编程工具生成的代码,为什么常能运行却难以维护?

7. AI 写的代码该不该直接合主分支?审查清单给你

8. Claude 又翻车:把 / 传给 rm -rf,汇报时只说了一句话

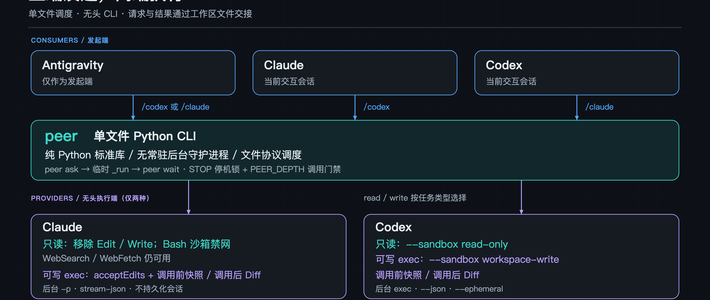
9. 别让写代码的 AI 自己给自己打分:PeerAgent 跨模型交叉审阅的设计与开源实践

0
扫一下,分享更方便,购买更轻松
0评论

当前文章无评论,是时候发表评论了
提示信息

取消
确认
评论举报

最新文章 热门文章