11月的AI圈挤满了新模型:Anthropic的Fable 5.5在官网源代码里露了脸,OpenAI的GPT-6.2 Astra被用户从Codex后台翻了出来。国产阵营里被蹲得最凶的,是智谱的GLM-5.5——B站上一条“快来吧glm5.5,希望文本能力也能有所提升”的留言,顶了17个赞。爱范儿哔哩哔哩
蹲它的人,先被一张截图坑了一把。
一张截图骗了8万人
9月25日,X上有博主发帖称OpenCode的数据页“提前曝光”了glm-5.5-flash模型页,一口气拿了8.1万浏览。10月27日页面还在线,博主再度发帖“证实”,中文社区跟着刷屏,“实锤了”的说法到处飞。知乎
截图是真的,页面也是真的,但什么都证明不了。
把数据摊开看:这个“新品”的token消耗为0,总花费0美元,唯一一次会话发生在9月19日。作为对照,GLM-5.3-Flash同期在同一平台烧掉了32万亿token、跑了1550多万次会话。一个连一次真实调用都没有的页面,谈不上预热。
一锤定音的是OpenCode官方10月28日提交的PR:9月19日有个配错脚本的请求被系统拒绝(HTTP 400,0次实际调用),统计程序把这个被拒请求也计了数,凭空造出一张模型页。这条幻影数据要等统计窗口滑出才会消失,时间大约在11月14日。知乎
智谱自己漏的口风,才是硬信号
乌龙归乌龙,模型确实在路上。这次的“实锤”不是网友扒的,是智谱官方公告里写的。
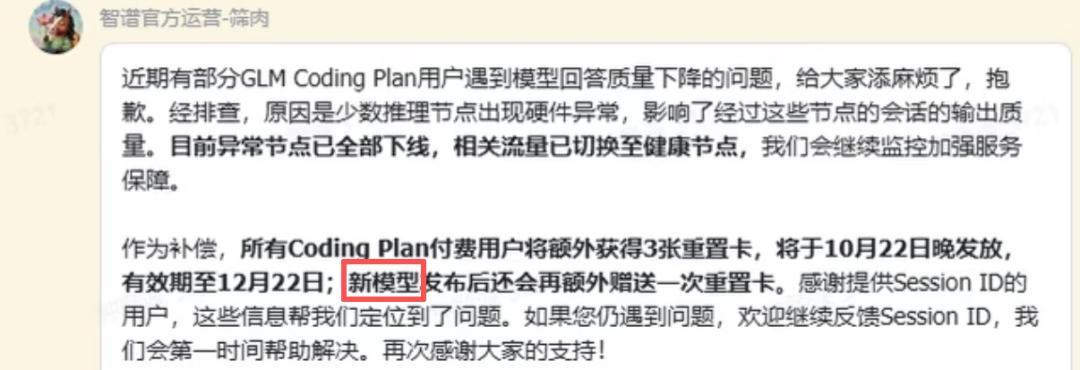
10月21日晚,智谱运营给GLM Coding Plan用户发补偿通知,为部分用户遇到的“降智”问题致歉。通知最后加了一句:“新模型发布后,还会再额外赠送一次重置卡。”36氪
补偿公告顺手预告下一代模型的赠品,这在智谱自己的口径里,等于承认发布在即。
网传的参数规格更夸张:新一代基座规模落在2.5万亿到3.5万亿之间。目前国产最大的是Kimi K3的2.8万亿,GLM-5.3只有7430亿——真做到3万亿以上,国产旗舰的头名就要换人。不过这来自流传的专家交流纪要,报道方也声明“不能完全确认”,看看就好,别当官宣。今日头条
11月1日又有一波爆料:GLM-5.5已进入后训练,32B、122B、256B三个内部模型正合并进下一代基座。爆料者补充,这些只是中间检查点,不是最终发布尺寸。哔哩哔哩知乎
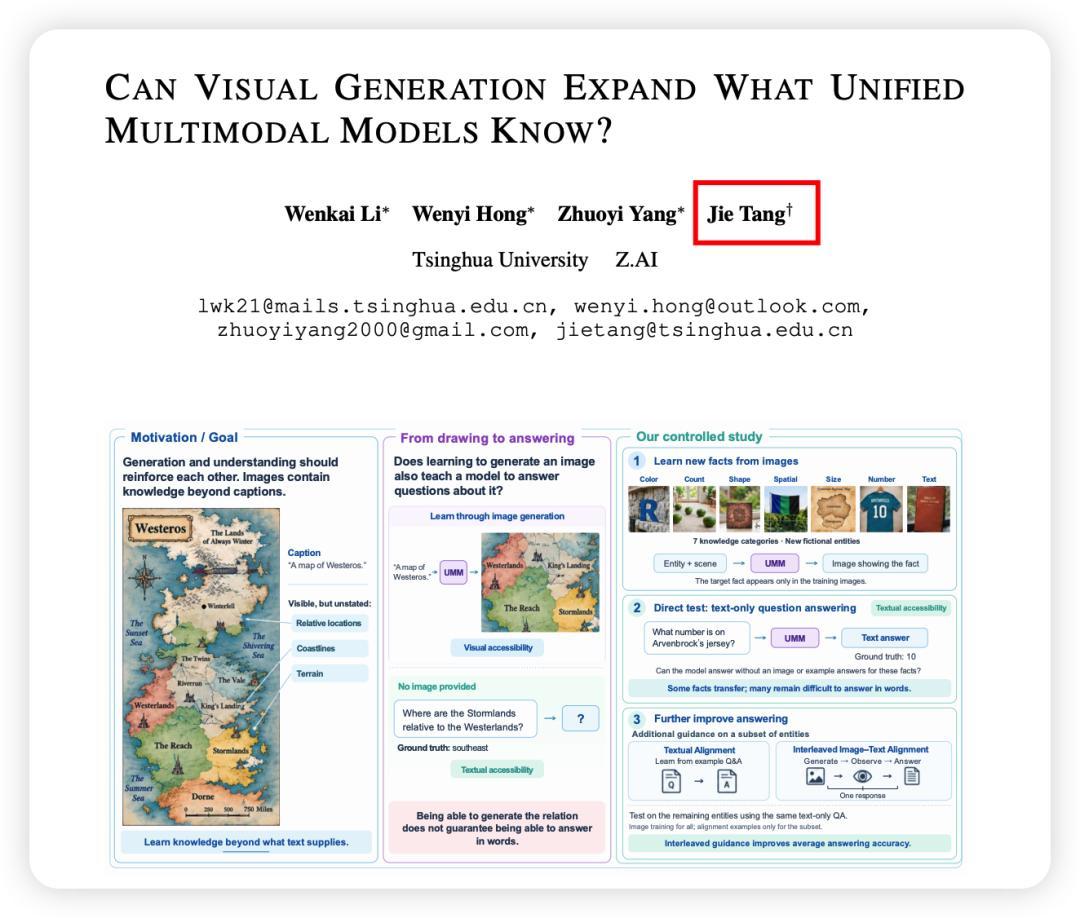
还有一条技术线索:唐杰署名的最新论文曝光了智谱内部多模态模型GLM-Omni。它让模型“先生成图像、再观察图像”来答题,文字准确率从12.57%提到了41.14%。这只是个9B的实验模型,不能直接和下一代GLM画等号,但方向摆在那:下一代GLM大概率会在多模态上继续下注。36氪
按智谱的节奏,11月正好
回头看2026年的发版表:GLM-5在2月,5.1在3月底,5.2在6月中,5.3在8月中,5.3-Flash在8月底,大约每2到2.5个月一发。知乎
8月26日到现在,智谱已经空了两个多月。按节奏推,下一发正好落在11月,和“已进入后训练”的爆料也对得上。
现在该等,还是该用?
评论区最常见的问题是:要不要停下手头的活,专门等它?
写代码为主的,值得等。 GLM-5.3的编程专项本来就在国产第一梯队,5.5大概率继承这个优势。发布当天,拿你手头的真实项目(不是玩具demo)跑一遍,十分钟就能测出差距,强就切。
不写代码的,别干等。 模型更新一步接一步,为一个没定档的版本停一周,省不下钱,耽误的是活。手头的事照常用GLM-5.3跑,新模型上线后做一次同任务对比,切换成本本来就低。
另外提醒一句:补偿通知里的重置卡,是“新模型发布后”才送。发布前别急着把额度清空——这张重置卡,才是智谱这波最实在的补偿。
至于到底哪天发,智谱还没说。但官方都开始预告赠品了,倒计时应该真的开始了。