

今天的多模态圈相当热闹:Qwen4-Max带着原生视觉和0.5元缓存价登场,混元Hy4 Flash把多模态成本再往下砍,Meta新论文又把视觉编码器该不该留重新吵了起来。
Qwen4-Max上线:2.4T参数、原生视觉进基座
11月16日晚间阿里正式开放Qwen4-Max:总参数2.4万亿、每token激活约710亿、原生视觉而非后挂插件、上下文百万级,千问App和各API渠道同步上线,缓存命中输入低至每百万Token 0.5元。经常读带图表长报告、盯带画面长流程的团队可以借此校准多模态长任务的成本区间,但官方降本口径与第三方实测数字不一致,个人自测的“off档得分最高”样本量也小,别拿单次结论当定论。
官方口径
首批与民间实测
腾讯Hy4 Flash:把多模态价格打成“办公价”
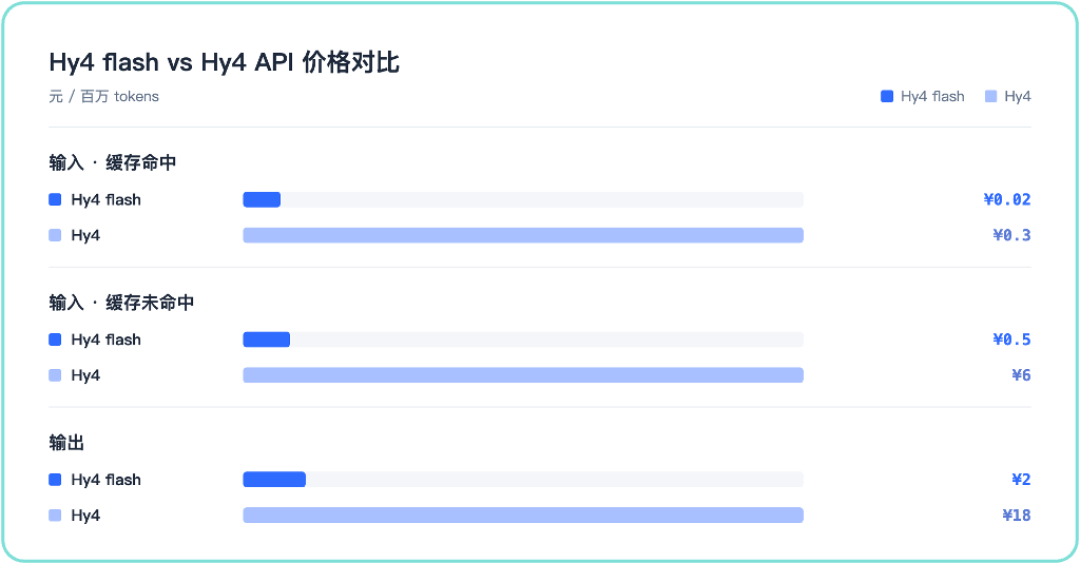
11月16日腾讯发布轻量模型Hy4 Flash:总参数2240亿(含640亿Engram)、激活120亿、原生多模态、百万上下文,官方定价每百万Token输入0.5元、输出2元、缓存命中0.02元,11月30日前限免。天天处理办公文档和图表问答的用户值得盯住KV缓存压到前代1/24、解码超150tps这两个数,成本敏感的话可以先试再换;有海外盲测称办公任务满意度接近旗舰轻量款,口径属外部转述。
书生-S2.1 Flash开源:科学数据直接喂,国产GPU当天适配
11月16日上海人工智能实验室发布并开源科学多模态大模型书生-S2.1 Flash,分子图、晶体、蛋白序列、光谱质谱、心电脑电等科学数据可直接输入,推理成本约为智能体模型书生·星河的1/10,官方称15项基准对比中4项第一、7项第二;同日沐曦曦云C系列GPU完成Day 0适配。做科研和关注国产算力的用户可以留意这个带生态位的新开源选项,基准成绩为官方通稿口径,第三方复测结果待观察。
Kimi K3.1 Pro开源 × 摩尔线程:万亿参数多模态训练跑进国产卡
摩尔线程11月16日官宣在国产GPU上完成刚开源的Kimi K3.1 Pro(开放权重、原生多模态、总参数约2.8万亿、最高100万Token上下文)训练适配:双机16卡跑裁剪13层/16专家、保留完整27层视觉塔的配置400步稳定,验证loss从6.53降到4.69。想看万亿级多模态训练在国产显卡上可行性的人,这是一份带具体数字的工程实录;开源说法已有多个来源交叉印证,但权重仓库链接仍建议以发布方页面为准。
视觉编码器该不该留:Meta新论文和路线之争一起升温
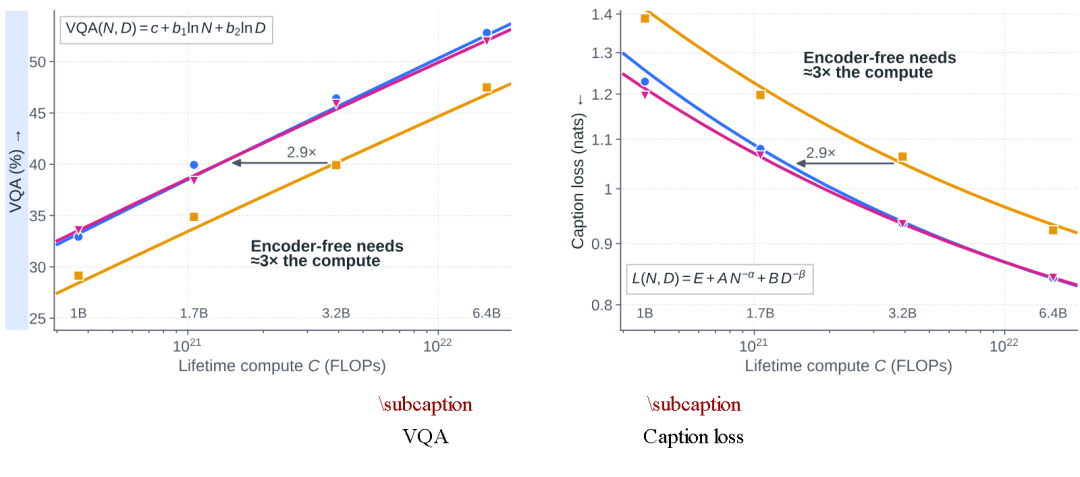
Meta FAIR与NYU的论文Unbundling(arXiv:2611.17334)这两天在社区刷屏:200多个从零训练的对照模型显示encoder-free在每个尺度都落后、追平要多花约3倍算力,而把0.4B视觉专属参数塞进主干前8层就能基本追平独立编码器、首token延迟还低约13%。它直接影响你选多模态架构时训练预算能不能砍,作者里还有SigLIP系的研究者;但已有缩放律研究持相反结论,产品端Fable 5.2干脆用代码绘图,把“多模态只是组件”的路线质疑又抬了一档,这事还没有定论。
论文与解读
产品与路线分歧
备考向:有人开源了一套多模态编程习题集
11月16日一位小红书开发者开源了多模态方向的习题集,100道代码补全加20道综合题、自动评分,已同步GitHub,收藏量明显高于点赞。准备秋招或刚进基模圈子的人可以拿去当刷题清单,题目质量深浅还得自己上手判断。


当前文章无评论,是时候发表评论了