

这个项目没有新增任何用户能看见的功能。唯一的改动是:什么问题该想,什么问题不该想。
账单上一年花了 12.8 万。改完之后 7.2 万,准确率从 91.3% 掉到 90.8%。省下 5.6 万,代价是半个点。
这笔钱值不值,下面逐笔拆。
一、先说结论
一年 730,000 次提问,平均每次 2,000 次/日。全量开思考的时候,单次成本 0.176 元,一年 128,137 元。
改成按难度分流之后,单次 0.099 元,一年 72,364 元。省 55,773 元。
准确率 91.3% → 90.8%,掉 0.5 个点。平均响应从 18.0 秒回到 9.2 秒。中途放弃率从 23.8% 回到 5.9%。
换句话说,这笔钱不是花在准确率上,是花在「不该想的问题也在想」上。
二、钱花在哪
把 73 万次提问按难度分三档,每档的成本单独算:
档位占比年次数不开思考全量思考分流后L1 查用法57%416,1000.045 元0.093 元0.049 元L2 找原因31%226,3000.093 元0.222 元0.119 元L3 做权衡12%87,6000.172 元0.448 元0.289 元
看第三列到第四列的变化。L1 每次从 4 分半涨到 9 分 3 厘,翻了整整一倍,而它的准确率只从 94.8% 涨到 95.1%。
L1 这一档一年多花的钱是 19,973 元。换来的是 0.3 个点。
三、三个方案摆在一起
我们试过三个省钱的办法,每个都跑了完整一个月。
方案 A:换小一号的模型。 同一个系列里参数少一档的那个。年成本从 128,137 元降到 96,400 元,省 31,737 元。准确率从 91.3% 掉到 88.1%,掉 3.2 个点。
方案 B:砍上下文,少塞历史。 把多轮历史从十二轮压到四轮。年成本 116,900 元,省 11,237 元。准确率掉到 90.4%,掉 0.9 个点。
方案 C:难度分流,按题给思考预算。 简单的不想,中等的想一会儿,复杂给足。年成本 72,364 元,省 55,773 元。准确率 90.8%,掉 0.5 个点。
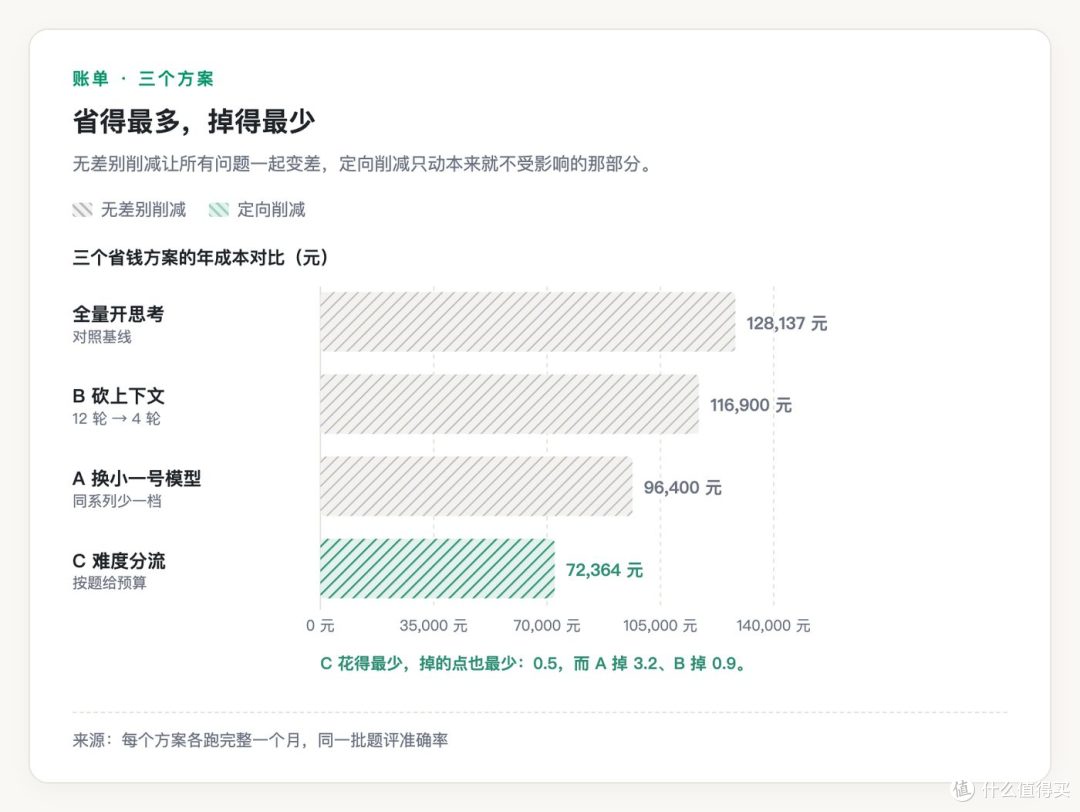 图 1 三个省钱方案的年成本:C 花得最少,掉的点也最少图 1 三个省钱方案的年成本:C 花得最少,掉的点也最少
三个方案每掉一个准确率点能省多少:
A:9,918 元
B:12,486 元
C:111,546 元
C 每掉一个点换来十一万的节省,是 A 的十一倍,而它的绝对损失还最小。
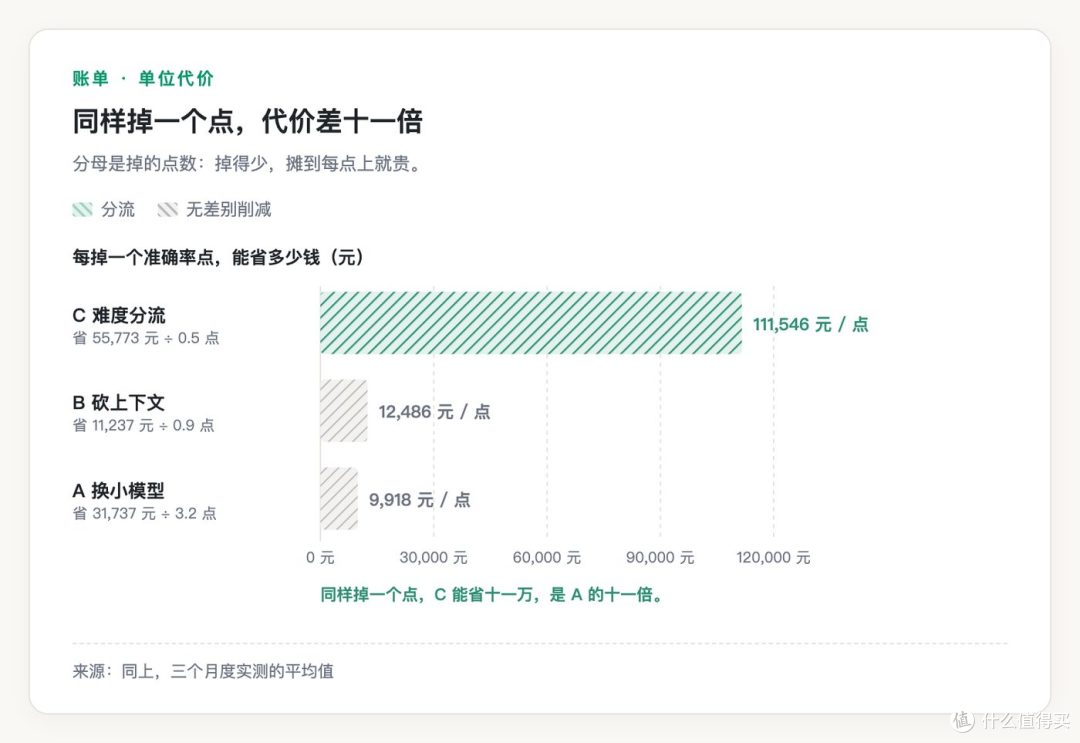 图 2 每掉一个准确率点能省多少:C 是 A 的十一倍图 2 每掉一个准确率点能省多少:C 是 A 的十一倍
这不是巧合。A 和 B 是无差别削减——把所有问题一起变差;C 是定向削减——只削减本来就不受影响的那部分。
四、为什么 L1 一刀切最划算
L1 的特点很明确:答案是唯一的。
「某个配置项默认值是多少」,答案就一个数。模型多想八百字,也还是那个数。它可能把出处讲得更清楚,但用户要的是那个值。
这一档占了一半多的量。所以从 L1 身上省,是性价比最高的一刀——不是因为它不重要,是因为思考对它的边际收益几乎为零。
反过来,L3 那一档,思考的边际收益很高:从 63.7% 涨到 79.8%,涨 16 个点。这一档只有 12% 的量,钱不多,但不该省。
我们最初的想法正好相反——觉得「复杂的多花钱是浪费,简单的多花钱也是浪费,平均省一点」。实际是简单的省得最干净。
五、一个反直觉的发现
分流之后,我们的模型调用总量没降,反而涨了 3.6%——因为每次多了一次判定调用。
直觉上应该更贵。实际单次成本从 0.176 元降到 0.099 元,降了 44%。
原因在思考 token 的分布。全量思考的时候,思考 token 占了总 token 的 72%;分流之后只占 34%。判定调用那 1,200 token 在这个量级面前可以忽略。
思考 token 是这个项目里唯一真正贵的部分。 输入输出都按字算钱,但思考 token 会让你在同一个问题上多算十倍。
六、什么情况下别急着做
三个判断,答不上两个就先别动:
第一,你的问题分布是均匀的吗? 如果七成以上都是复杂问题,分流的收益会很窄,不如去换模型或者做缓存。
第二,你敢接受准确率掉一点吗? 这套做法最多保住 99% 的原准确率,做不到不降。如果业务上不允许降,那就得从别处省。
第三,你能不能稳定判定难度? 判定器做不好,整套就白搭。我们这条线准确率 91.6%,L3 漏判率压到 9.1% 才敢上。
三个都答得上的话,这笔钱值得省。
七、最后
这套改造花了 68 人时,按 280 元一人时算 19,040 元。加上每月校准 6 人时、一年 72 人时 20,160 元。
首年投入 39,200 元,省 55,773 元,首年净省 16,573 元,8.4 个月回本。
不算惊艳,但它是那种越用越划算的东西——省的钱按调用量线性增长,投入是一次性的。
参考:判定和生成这一层我们走的是统一地址,词元云,换模型只改一个名字,分流逻辑不用动;省下的钱也主要来自思考 token 的量,不在模型单价。https://tokenfreeai.com
当前文章无评论,是时候发表评论了