

你随口问AI一句话,十几个字,也许86个单词——它背后可能处理了40多万个token。这不是段子,是美光(Micron)11月16日官方博客晒出来的一笔账。知乎
想让这个数字变得直观,先搞清楚AI智能体在干什么:它不是你问一句、它答一句。你的请求进来,它先分析需求,再调用工具,读完工具结果还得继续推理,上下文一轮轮被反复读取。粗算下来,你输入的每个单词背后,约对应4700个被处理的token。知乎
但这里有个坑必须说清:40万是"累计处理量",里面包含大量被重复读取的缓存输入,并不是AI新写了40万个token。美光白皮书自己给的档位是:普通单轮问答最多几百个token,带记忆的助手几千个,会用工具的小代理几万个,多代理协同能干到几十万甚至上百万——这些是示意区间,不是每个智能体的固定用量。拿累计token去直接算API账单,就上当了。知乎
一个卖内存的厂商,为什么突然热心替AI算账?因为算完的结论指向一个购买判断:AI不必全待在云上,有一部分应该搬进你手机和电脑里。白皮书主张的是"混合部署":最难的推理交给云端,高频、低延迟和隐私敏感的任务留在本地设备。实时语音和机器人要秒回、医疗金融的数据不能出门,都算在这一边;输出token单价通常是输入的5倍或以上,高频用户这笔云账单也肉疼,留在本地更划算。知乎
顺带,美光把"AI快不快"拆成了两种快,这一段对你买东西最有用:启动阶段,模型要从存储设备搬进内存,拼的是硬盘读取速度;生成阶段,数据要持续供给,拼的是内存带宽。翻译成装机语言:年末买"AI电脑",别只盯着GPU——内存容量和带宽、SSD读取速度,才是AI体验的两本隐藏账。知乎
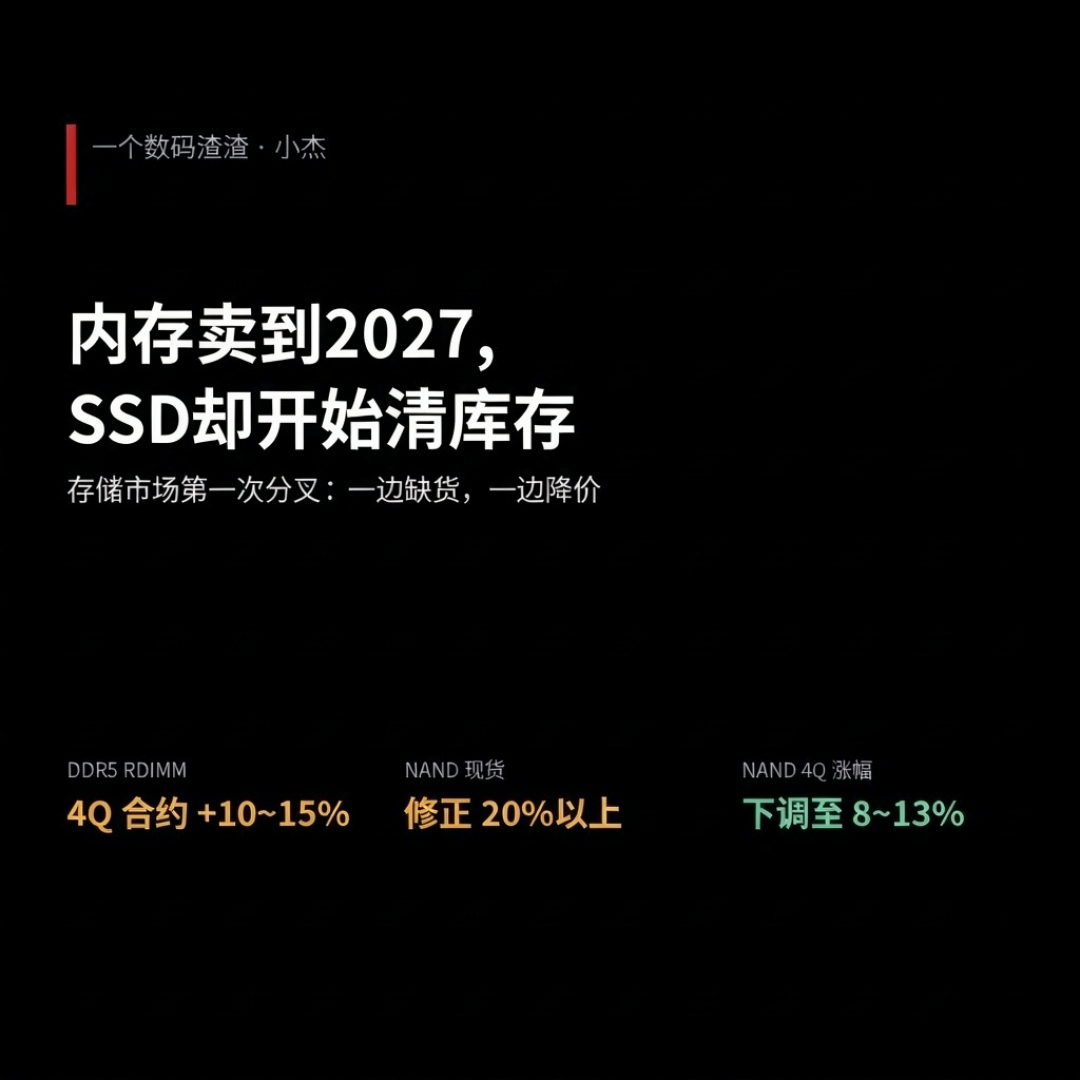
最后接上大家都在挨的涨价:智能体这种用量,是内存需求的无底洞。美光CEO桑杰·梅罗特拉11月18日在投资者大会上披露,公司2027年预期产能约75%已售出,明年供需会比今年更紧。知乎知乎
总裁兼首席技术与产品官Scott DeBoer把话讲得更直白:2027、2028年的紧张程度将超过2026,供需在可预见的未来难以找到平衡点。按10月巴克莱报告引述的行业口径,这场短缺可能一路拖到2029年。知乎微博
结尾泼盆冷水,也是立场问题:美光自己卖的就是内存和存储,"AI很吃内存"这个叙事对它天然有利;白皮书列了模型和配置,但编程任务的结果不能推广到所有用途。这笔账可以当参考,别当购买命令——端侧AI值不值,看你自己的任务和钱包。知乎

当前文章无评论,是时候发表评论了