

这半年,AI圈的风向变了。
小红书一篇《别建AI知识库》拿了2257赞、2984收藏,作者的判断相当激进:2026年Claude和Gemini的上下文窗口已到百万token级,对大多数企业的文档量来说,不需要向量数据库、不需要切块、不需要embedding,直接把文档塞进去,比RAG更准、更快、调试更容易。Anthropic自家给工程师造的Claude Code内部也不用向量数据库,靠markdown索引+grep+按需加载;而知识库这套方案,本是上下文窗口只有8k token的2023年的解法,拿2023年的架构解2026年的题,很多时候是在给自己制造不必要的工程复杂度。小红书
知乎上"为什么Agent重新用回Grep"的话题被反复讨论,更难听的现成说法是:做RAG最难搞定的是,RAG已经基本上凉透了,26年没人提RAG咯。知乎
这轮质疑真吗?真,但只对了一半。
对的那半:更新慢、量不大的文档(制度库、产品手册),塞上下文确实最省心。但更新快、天天变的实时知识和合规条款,RAG的维护费会吃掉你,最好别碰;文档本身乱七八糟时,再高级的检索也白搭——要做的是把层次结构理顺,而不是上来就RAG。小红书知乎
错的那半,全写在评论区里。有人直接问:上万份文档、业务里要频繁查某些条款,怎么办?塞不下。更苦的真实经历是把Obsidian笔记和合同全扫成md建库,最后问AI检索合同内容,经常得不到完整的答案,就放弃了。当事人自认为方案已经贴近生产环境,最后还是死在了检索这一步。小红书
所以问题从来不是RAG该不该建,而是你的RAG会不会建。多数教程停在"调embedding API+相似度排序"的demo层,翻车都发生在没教的部分——RAG的瓶颈不在模型在工程,效果也不是框架一个变量决定的,而是分块、检索、重排、模型四段链路乘出来的。四个坑:知乎知乎
坑一,切块。切块质量的下限,就是检索质量的上限:切在句子中间破坏语义,切太小丢掉上下文。解法是语义边界优先、大小约束兜底、相邻块重叠,嵌入模型把整块压成一个向量,块越大信息被平均得越稀、匹配越钝,512 token上下是经验甜点。每个块还必须绑好元数据(来源、章节、时间),检索后过滤和引用全靠它,这步不埋好,后面全是补丁。知乎
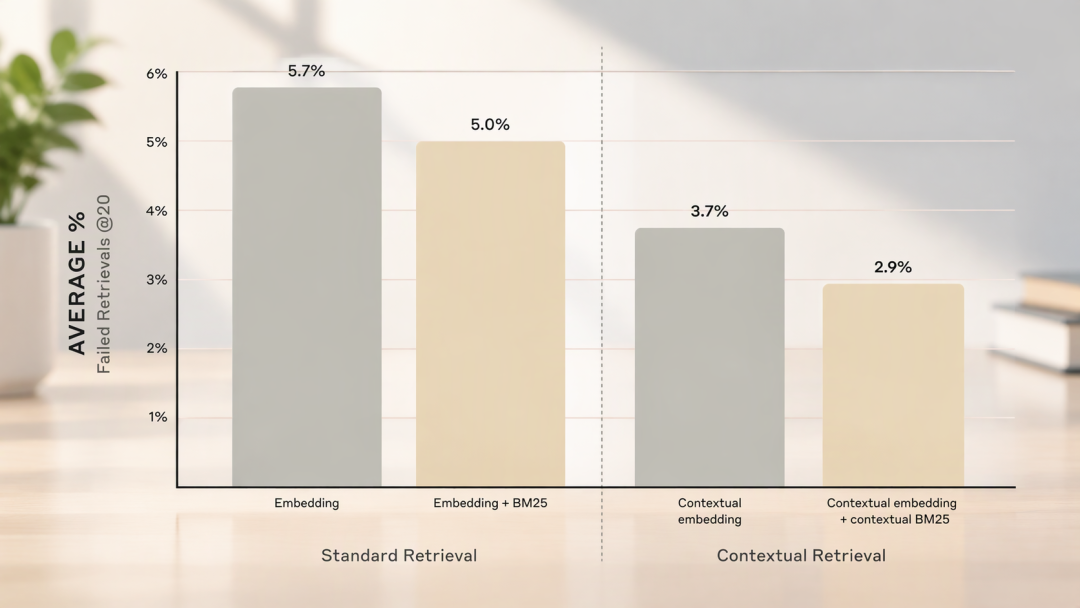
坑二,只靠向量检索。嵌入抓语义但抓不牢精确——"RFC-4823"和"RFC-4824"在向量空间里几乎一样近,所以要做BM25关键词+向量的混合检索,两路结果再用RRF融合,只用排名不用分数,k=60是原论文经验值。知乎
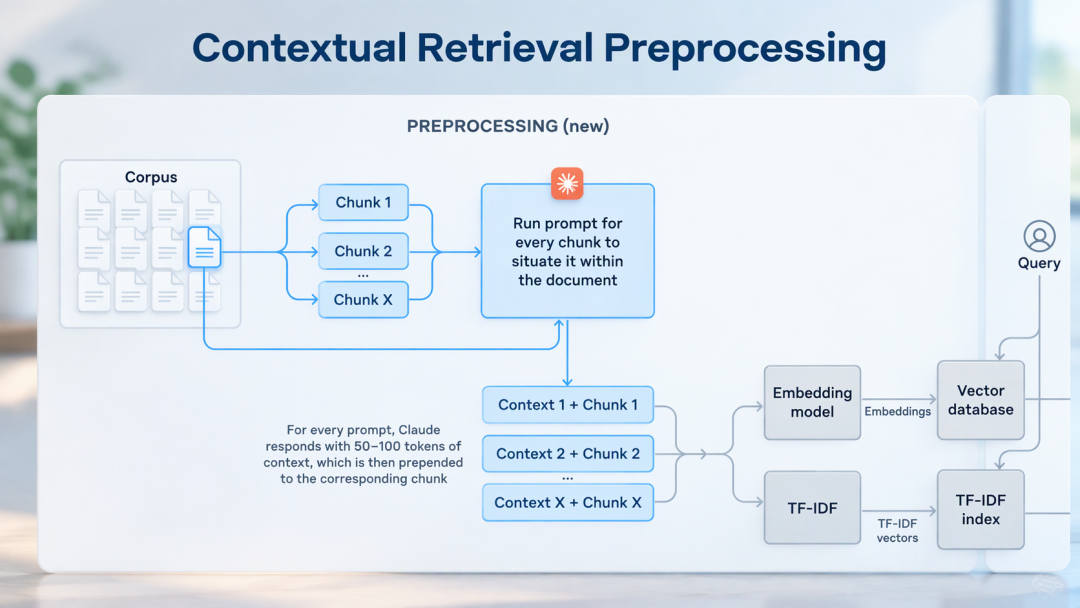
坑三,跳过精排。粗检索负责把十万级候选筛到百级,交叉编码器再把这几十上百个精排到个位——token级交互的精度远高于"压成一个点"的向量比对。它贵,所以站在前两层后面用,而不是替前两层偷懒。
坑四,不评测,靠玄学调参。标50–200个真实问题、盯recall@k和MRR,是系统迭代里唯一不可替代的回归测试。有工程师总结归因顺序:切块→粗检索→精排→提示词,从前往后查,90%的问题死在前两级,而多数团队花的时间恰好反着。一个客服知识库把清洗、分块重构、检索策略、提示词整条链路过了一遍,准确率从58%拉到96%。知乎小红书
最逗的是,还有人执着于"哪个框架效果最好"。知乎有个回答一语道破:同样一套资料,换个分块策略,效果差得比换框架还大。知乎
RAG没死,死的是"调个API就号称智能问答"的demo级RAG。Agent时代它只是从热词退成了管道——而当管道,能不能跑通、查得准,比选什么名字重要多了。
当前文章无评论,是时候发表评论了