10月24日凌晨1点多,月之暗面把官网首页标题悄悄换成了「K3.1 Pro 上线,编程与智能体任务全面升级」。没有倒计时,没有发布会,憋了一个月的「10月国模憋气大赛」就这样先掀了牌:3万亿级参数开源旗舰、终端编程跑分只差 Claude Opus 5.5 0.7个百分点、API 价格比上代 K3 便宜三分之一、模型权重承诺 11月4日前放出。知乎
天亮之前,B站已经堆出几十条连夜实测,最热的一条播放逼近2万、评论500多条;知乎上提前开好的「如何评价 Kimi K3.1」问题页,半夜就涌进了一波实测党。但翻完评论区你会发现,画风和跑分表格完全是两回事:有人说「699 的套餐 30 分钟就烧光额度」,有人转述 X 上有老外「8 分钟烧掉 200 刀」。哔哩哔哩
跑分追上了 Opus,成本争议追上了钱包。这篇把官方规格、第三方指数和知乎、微博、B站的第一手实测反馈拼在一起,按人群说清楚:K3.1 Pro 到底谁该切、谁该等。
一、这次发的是什么:K3 的「后训练补课」,不是新架构
先说清楚三个基本事实,避免被「3T 核弹」的标题带跑:
K3.1 Pro 是今年 7 月发布的 K3 的后训练版本。总参数维持 2.8T(MoE,激活约 104B),上下文仍是 100 万 token,月之暗面的做法是砸大规模 RL 算力,跨数百个下游领域做联合训练,另外把思考档位从三档扩成四档(新增 medium)。知乎36氪
同步推出 Highspeed 高速版:同等智能,输出速度约 2~3 倍,价格 2 倍。
即日全渠道可用:kimi.com、Kimi App、Kimi Work 桌面端、Kimi Code 终端和 API(模型 ID:kimi-k3.1-pro / kimi-k3.1-pro-highspeed)。完整模型权重最迟 11月4日发布。微博
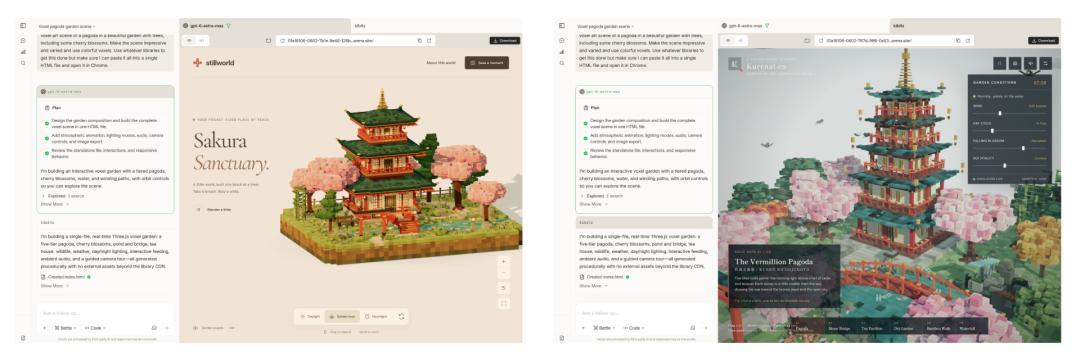
发布前还有一段社区都看破的「谍战戏」:10月22日,Arena 的 CodeArena 上出现匿名模型 Kibitz,被网友通过 tokenizer 特征鉴定为 Kimi 家族——K2.5、K2.6、K3 当年分别叫 Kiwido、Kiwire、Kivine。有人估算它的推理成本只有 GPT-6 Astra 的十四分之一。新模型必考的「骑自行车的鹈鹕」,它直接做成了能调踩踏频率、能切白天黄昏的交互网页。36氪知乎
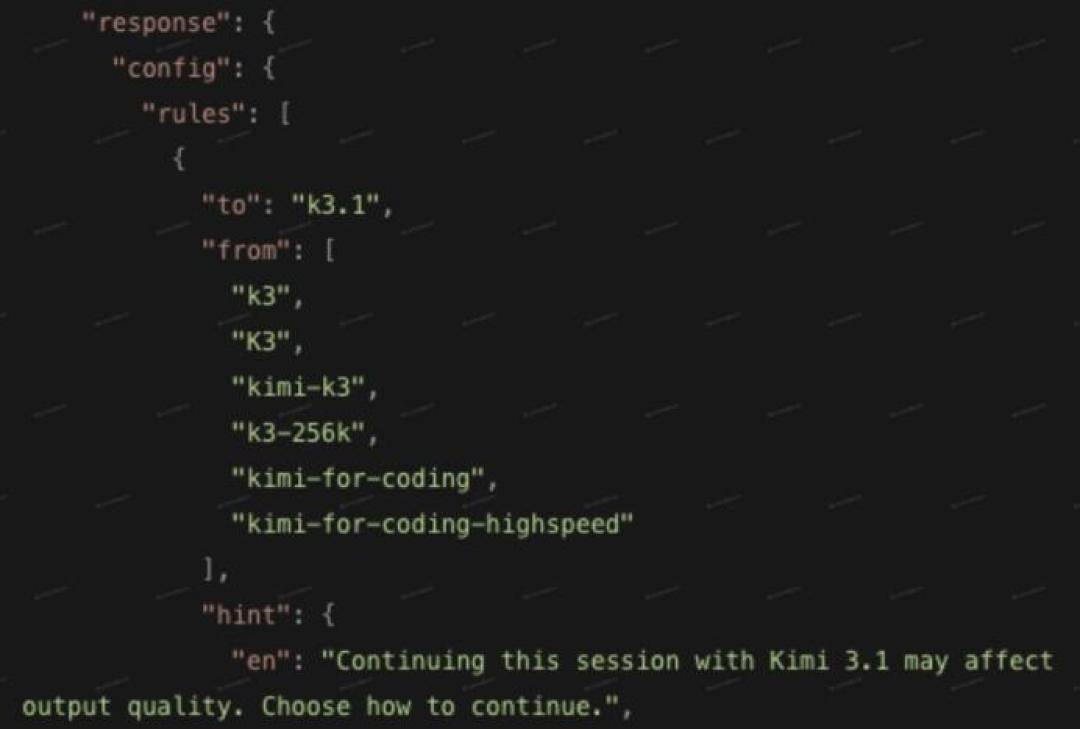
更早一天的 10月21日,Kimi Code 的配置里还短暂出现过指向 k3.1 的路由规则,当晚再查已经返回 404,截图却在社区里传开了。36氪还提到,同一时期现身的另一个匿名模型 Kalmia,疑似是阿里的 Qwen4。两天后,Kimi 官方账号用一段 24 秒预热视频「不小心」露出了 K3.1 的名字。36氪
二、跑分有多硬:第三方数据和内部考卷要分开看
这次的成绩单,按可信度分两堆看。
第三方或可复核的硬指标:
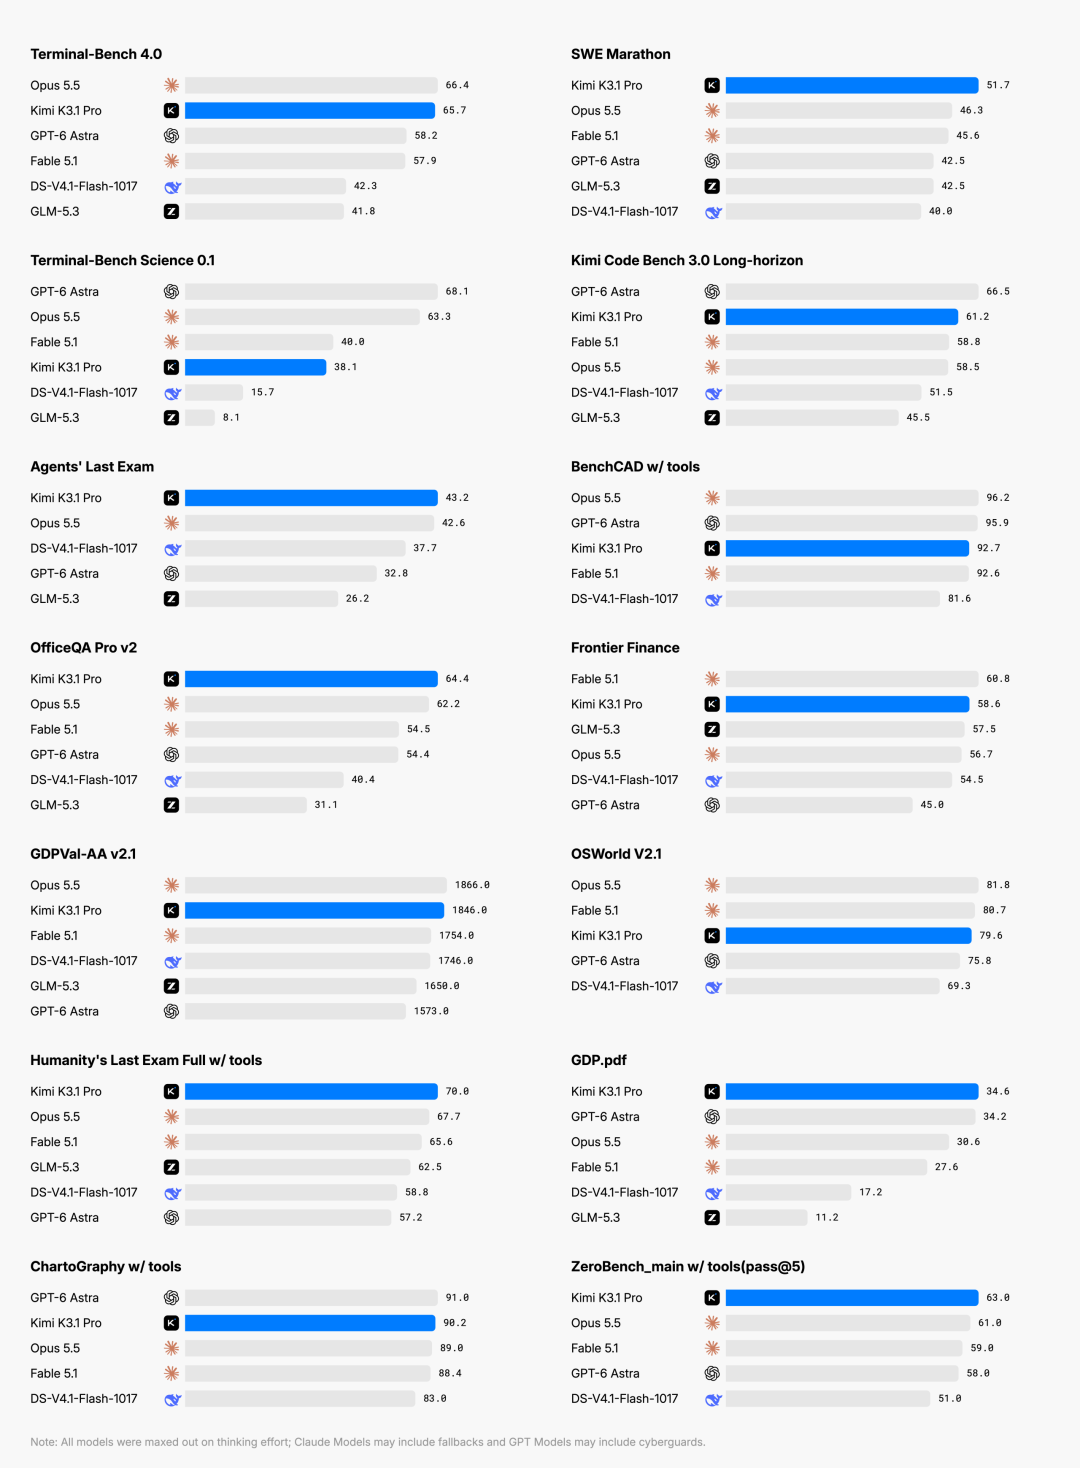
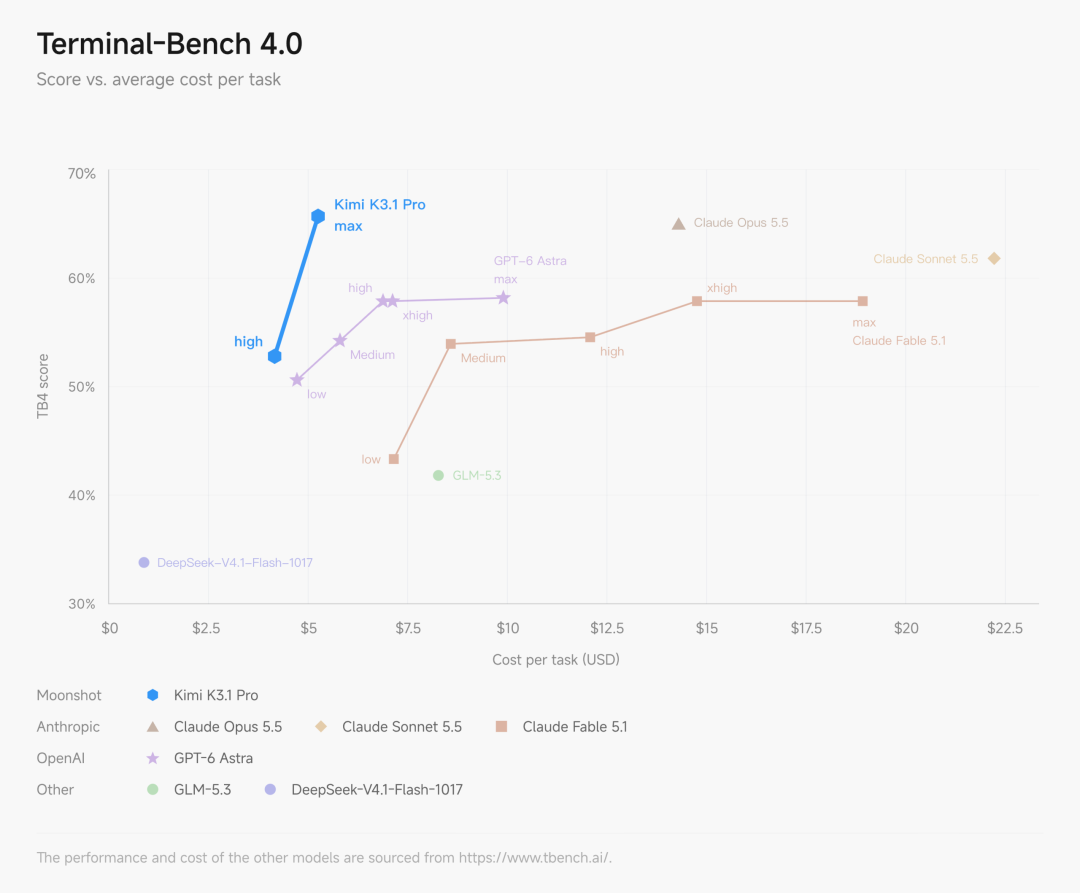
Terminal-Bench 4.0(真实环境、资源受限的终端编程任务):K3.1 Pro 得分 65.7%,同场 Claude Opus 5.5 为 66.4%,GPT-6 Astra 只有 58.2%。传疯了的「只差 Opus 0.7 个百分点」出自这里,而它对 Astra 是领先 7.5 个百分点的碾压。知乎
Artificial Analysis 综合智能指数:55 分,全球第四、开源模型第一,比 K3 暴涨 11 分。开源阵营与闭源天花板的差距,从 12 分缩到了 3 分(Opus 5.5 为 58 分)。哔哩哔哩
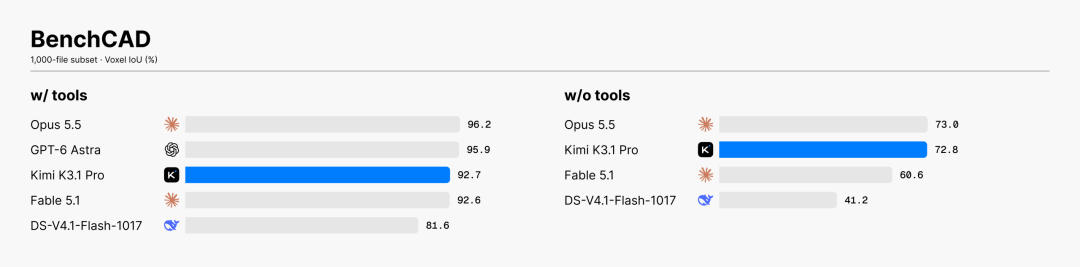
BenchCAD(从多视角渲染图重建 3D 模型):借助工具的合成得分 92.7%,对面 Opus 5.5 是 96.2%、Astra 是 95.9%。知乎上「K3.1 Pro 这是要抓着 CAD 打了吗」的帖子说的就是这项。
官方内部考卷,看个方向就行:
Kimi Code Bench 3.0 Long-horizon:61.2%,高于 K3 的 55.95%——自家出的卷子。
HalluBench Hard 幻觉压力测试:单项事实陈述错误率从 K3 的 23.4% 降到 8.3%。官方自己都标注了:这是刻意聚焦易错情形的压力测试,不代表日常水平。知乎
一句话总结:编程 Agent 的工程硬指标这次真的进了第一梯队,开源模型头一回贴到闭源天花板脸上,这不是营销话术。但值不值这个钱,得看下一节。
三、价格账:API 明着降了三分之一,订阅仍是黑盒
API 按量付费这部分是明白账:
标准版:输入 13 元/百万 token(命中缓存只要 1.3 元),输出 68 元;美元定价 2 刀/10 刀,而 K3 是 3 刀/15 刀——实打实降价三分之一。知乎36氪
Highspeed 版:价格翻倍,换 2~3 倍输出速度。交互式 Agent 场景,这个「花钱买时间」目前看是值的。
真实任务的成本体感更直观(均来自发布夜社区实测,属个例):用 Blender 建一台折叠屏手机再导出可交互网页,1.5 小时、12.5 美元。做一个能在浏览器里玩的 3D 城市交通沙盘,23 分钟,消耗 Allegro 档会员周额度的 2.35%。也有人拿它跑了 10 小时的 GTA 风格视频长任务,400 万 token、51.98 美元。哔哩哔哩哔哩哔哩
但订阅套餐是另一本账。Kimi Code 的套餐从 49 元到 699 元分四档,槽点全在老地方:
额度口径始终不透明。知乎「如何评价 Kimi K3.1」下的高赞回答开门见山:从额度消耗上看不出 K3.1 Pro 和 K3-256K 有什么区别,「Kimi 套餐额度不透明的问题早就有」。知乎
B站评论区实测党反馈,699 档「15 分钟跑完额度」「30 分钟就烧光」——大概率是拉满思考档位加 Highspeed 的跑法。API 单价降了,不等于你的套餐额度变多了,这是两套账。
旧坑还在:有微博用户修了一下午定时任务的 bug,回头发现任务一直默认跑在 K3 上,一个简单任务烧掉小 100 块钱额度。49 元档还限定 Kimi CLI、Claude Code、Roo Code 等指定工具,换个工具权益可能直接停用。微博
老账也被翻了出来:699 档价格是 199 档的 3.5 倍、额度只有 2.5 倍,9月24日改版新套餐时社区就反弹过一轮。
所以「便宜三分之一」是真的,但它说的是 API。对订阅用户来说,自己的额度到底怎么折算 K3.1 Pro,官方到现在没给明白话。
四、第一手实测口碑:3D 是惊喜,后端是短板,Agent 体验确实变了
先说好评侧,来自知乎、微博、B站的早期用户:
Agent 编排明显变聪明:SubAgent 调用更积极、会主动并行任务,对后台任务卡住的感知更快。微博
速度比 K3 快得多(K3 最大的民怨就是慢),单批 token 延迟大概几百毫秒到 1 秒。
3D 和 Blender 是这次提升最大的方向:不依赖 MCP 连接器,直接写 Blender、CAD 脚本做参数化建模,官方演示里它用虚幻引擎 5.8 搭了一座半径 1750 米的东方天宫,社区也有人用它复刻中式山水园林、一句话生成类地铁跑酷的 3D 小游戏。知乎
有深度用户给出「Fable 平替」「六边形战士」的评价,称它做研究类长文时会主动检索论文交叉验证,用词严谨性比 K3 时期明显提升。哔哩哔哩
差评侧也别跳过:
前端提升不大、后端能力「一直很平庸」是高频吐槽。一位连夜测完的 UP 主总结:哪个场景都还不错、但都不拔尖,「跟价格对比来说性价比不高,是跟普通人无缘的模型」。
个别场景手感反而不如 K3:有用户反馈调用 Kimi Webbridge 时,它居然没发现 Edge 浏览器根本没启动。微博
发布当天也出现过「输出和思考跟提示词完全无关」的胡言乱语抱怨,疑似上线初期不稳定。
还有一条情绪账:这卷子「延期近一个月」才交。9月底 API 注册信息里就疑似出现 kimi-k3-1 标识。B站那条催更讨论视频下面 84 条评论,期待值早被拉满了。哔哩哔哩36氪
五、三类人,三种打法
1)API 按量付费的独立开发者和企业用户:可以直接切。 单价降三分之一、缓存命中输入低至 1.3 元/百万 token,配上 65.7% 的 Terminal-Bench 成绩,成本敏感的 Agent 工作流没有理由不迁移;交互式产品可以上 Highspeed,2 倍价格换 2~3 倍速度。唯一建议:切流量之前,先用小比例请求回归测试你现有的提示词和工具链——后训练版本在工具调用的边角场景上,行为可能和 K3 不完全一致。
2)Kimi Code 订阅老用户:别急着加钱升档,先核三件事。 一是定时任务和默认模型现在跑的是谁,别重演「默认 K3 一晚上烧掉小一百」的惨案;二是拿同一个任务对比 K3.1 Pro 和 K3 的额度消耗,Kimi Code 的会话日志在 ~/.kimi-code/sessions/ 下面,token 数自己可查;三是盯官方会不会更新各档位的额度折算口径。模型变强是事实,但如果额度黑盒不变,体感很可能是「更快烧完」。
3)等开源自部署的:标记 11月4日,但先泼盆冷水。 2.8T 总参数的 MoE,个人本地跑基本不现实——激活 104B 不等于显存只需要 104B 的量级,首批受益的是推理服务商和有集群的企业私有化部署。真正值得盯的是权重放出后的 license 条款和实测部署成本。更大的背景是:DeepSeek 率先坚持旗舰 MoE 首发开源之后,MiniMax、Kimi 这些原本偏闭源的团队也开始把旗舰权重常态化放出。而同一天的新闻里,奥特曼正坦言 OpenAI 最强的内部模型不敢开源。开源与闭源的定价权之争,才是这次发布最值得长期跟踪的变量。知乎哔哩哔哩
接下来两周值得盯的信号,列在这:
官方是否公布 K3.1 Pro 在订阅套餐内的额度折算口径;
11月4日权重的实际体积、license 和第三方部署成本实测;
Terminal-Bench 4.0 的 65.7% 能否被第三方复现;
GLM-5.5、Qwen4(匿名模型 Kalmia 已经在 Arena 露过脸)、DeepSeek V4.1 Pro 会不会跟上——Kibitz 那「十四分之一成本」的优势,未必能安稳保到 11 月。
最后给个一句话结论:K3.1 Pro 让开源模型的编程能力第一次贴到闭源天花板 0.7 分以内,API 用户是实打实的降价红利,值得切;但订阅用户的额度黑盒这次依然没解开——模型可以夸,账要算清再掏钱。