10月20日,DeepSeek悄悄又开了一个GitHub仓库。这次放出来的不是模型,而是自家机房里那口"私厨"——推理框架DeepInfer,官方仓库已公开这个推理框架,采用Apache 2.0许可证。官方说法很直白:让智能以更低的价格,触达更广泛的人群。微博微博知乎
三天前,它刚发了新模型V4.1-Flash。版本号后缀长到被网友玩成"史上最差AI模型名称"的梗。很多人纳闷:权重不是早开源了吗?开源个框架算什么大事?微博知乎
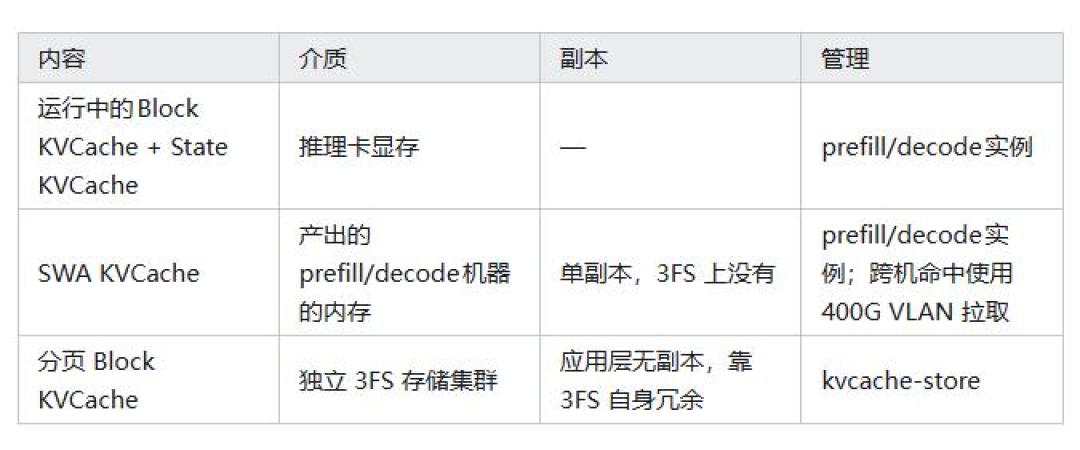
大事就在"怎么跑"上。 权重是菜谱,推理框架才是炉灶、锅和火候。训练是一次性开支,推理才是天天烧的钱——同一个模型,官方API又快又便宜,你部署就又贵又慢,差距全在调度、缓存和压榨硬件的算子细节里。DeepInfer就是DeepSeek线上服务同款内核:FlashMLA、DeepGEMM、DeepEP这些过去一篇论文一篇论文挤出来的"祖传配方",如今被收进同一个框架里统一维护。官方部署问答里还写明,KV缓存要保留超过72小时,命中了就不重算。知乎知乎

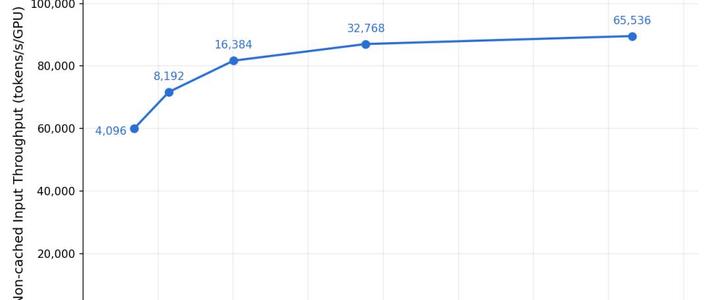
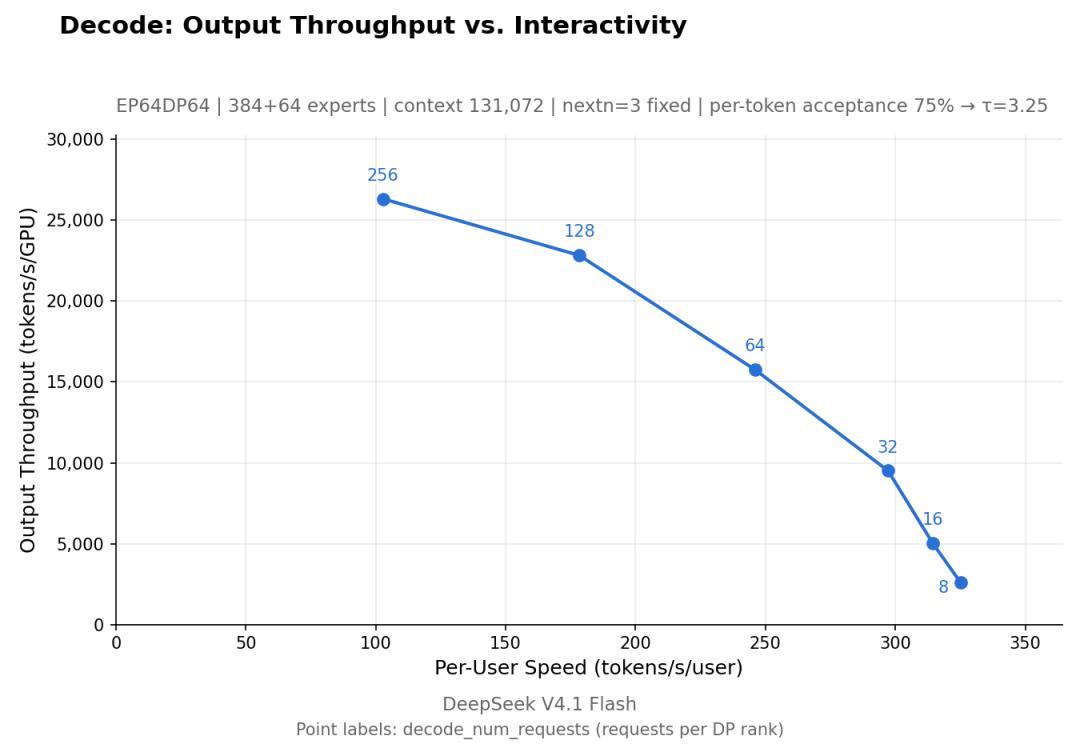
官方这次顺带晒出的两个数字,足够让行业重新估价"推理"这门生意:单集群日均吞吐155万亿Token,单张GPU每小时收入38美金。 那个"AI推理就是烧钱"的老说法,被DeepSeek自己推翻了。知乎微博
对普通用户来说,这更像一封情书。以前云厂商不太愿意接DeepSeek的单:权重是给你的,可你怎么部署都做不到官方API那么便宜的价格,卖了就亏。现在工厂把内参直接交了出来,云厂商的成本能压下来,API价格就有了往下打的余地,最后落到你用AI写文案、生图、跑Agent、剪视频的账单上。微博有条160赞的热评说透了:“梁:帮你们把别家API价格打下来了奥,别打扰我们这炼模型。”微博
不过,先别急着冲,三盆冷水得泼明白:
一、你的显卡大概率跑不动。 官方支持列表只有两类卡:英伟达Blackwell(SM100)和华为昇腾950。要Linux、Python 3.12,从源码编译、没有pip一键装,手里的4090连入场资格都没有——“开源"不等于"家用白嫖”,这两个字别搞混。知乎

二、图纸只给了一半。 本次公开的是离线推理引擎为主,完整在线服务要的KV缓存系统、跨副本负载均衡,目前只有设计说明,没给全量代码。想直接复刻官方服务,还差最后一公里。知乎
三、它现在只支持V4.1-Flash一个模型。 而且刚上线的可用性挺糙,已有用户第一天就撞上429、403、503连环报错。想拿它跑生产的,先等版本稳一稳。知乎知乎
所以普通人该干嘛?不用换显卡,也不用学编译源码。最实际的动作是:接下来一两个月,多盯一眼各家API平台的定价页——价格战真打起来的那天,这次开源才会变成你手上的真金白银。