

点击上方蓝字关注我,加个🌟标不迷路。
各位小伙伴们大家好,我是 cxuan。
我记得两年做 AI 视频的时候,很多人常挂在嘴边的一个事儿就是抽卡,就是说你写了一段 Prompt ,等模型给你生成几秒钟画面,如果人物动作能够保持住,那你这波抽卡就还算是运气不错。
不过,现在做视频,已经不需要这样看运气了。
字节 Seed 团队在 7 月 31 日发布了 Seedance 2.5。单次最多能喂 30 张图片、10 段视频和 10 段音频,直出 30 秒音视频,还能用时间戳指定某一段的剧情、视角、运镜和节奏。
这意味着 AI 视频创作,已经步入到另外一个维度。
我用 LibTV 体验了一下 Seedance2.5 ,毕竟 AI 创作这事儿,LibTV 还是靠谱。
这次 Seedance 2.5 上线之后,LibTV 也是围绕专业创作完成了全流程的升级。
而且我看了,这次 LibTV 上的 Seedance 2.5 现在低至 0.4 元一秒。
以前用这种顶级视频模型,我每点一次生成,脑子里都会先算一下积分。尤其是长视频,改了两三版之后,我都不敢看积分消耗了。。。很多时候明明生成的不满意,也会安慰自己差不多得了。
现在按最低活动价计算,一条 30 秒视频大约 12 元。再加上 720P 限时 58 折、最高赠送 60 条免费生成,我终于敢把同一个镜头多做几遍了,从来没打过这么富裕的仗。
另外,LibTV 是火山引擎官方合作平台,接入的是火山官方 API。每一次生成任务都可以查询和复制 TaskId,我也在项目页面确认了这个入口。团队做商单时,哪条视频由哪次任务生成、失败后该查哪条记录,都可以按 TaskId 追溯。
亮点一:逐帧拉片我上传了一下盗梦空间中的经典桥段,来体验一把这个逐帧拉片的功能,到底如何。
上面这段录屏展示的是完整的拉片过程。参考视频上传后,LibTV 会把画面里的关键帧、景别、运镜、叙事节奏和时间点拆出来,后面可以直接拿这些结果继续生成。
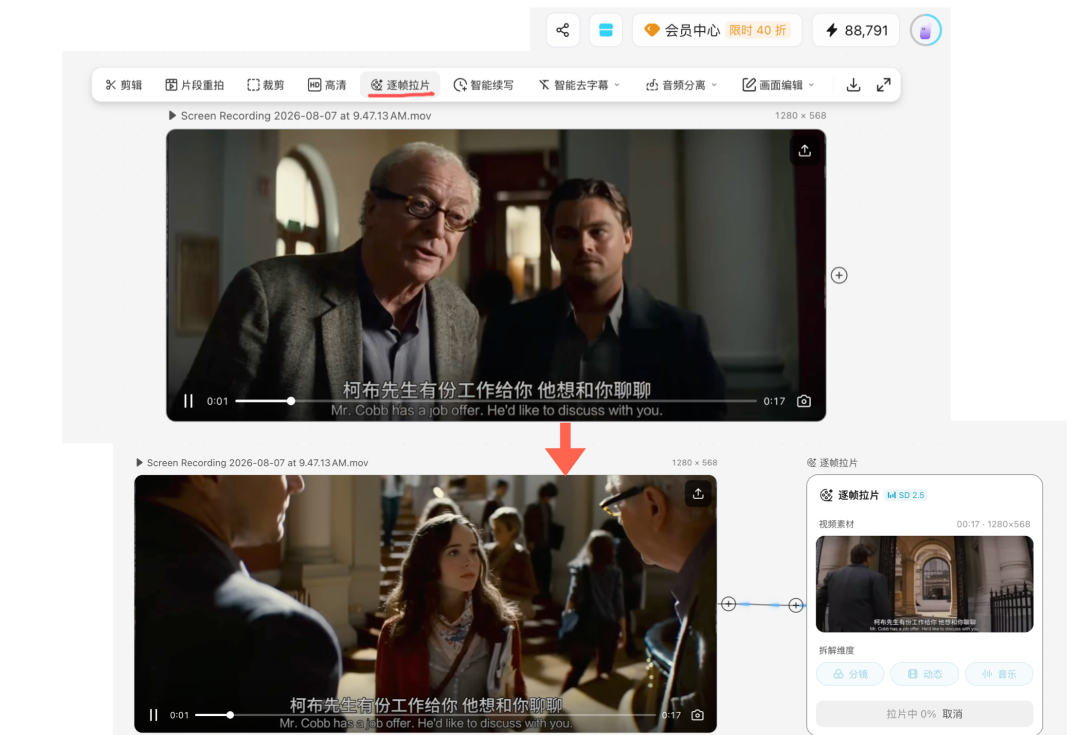 image-20260807112224385
逐帧拉片完成了,让我没想到的是,这个分析过程,是不需要耗费点数的。
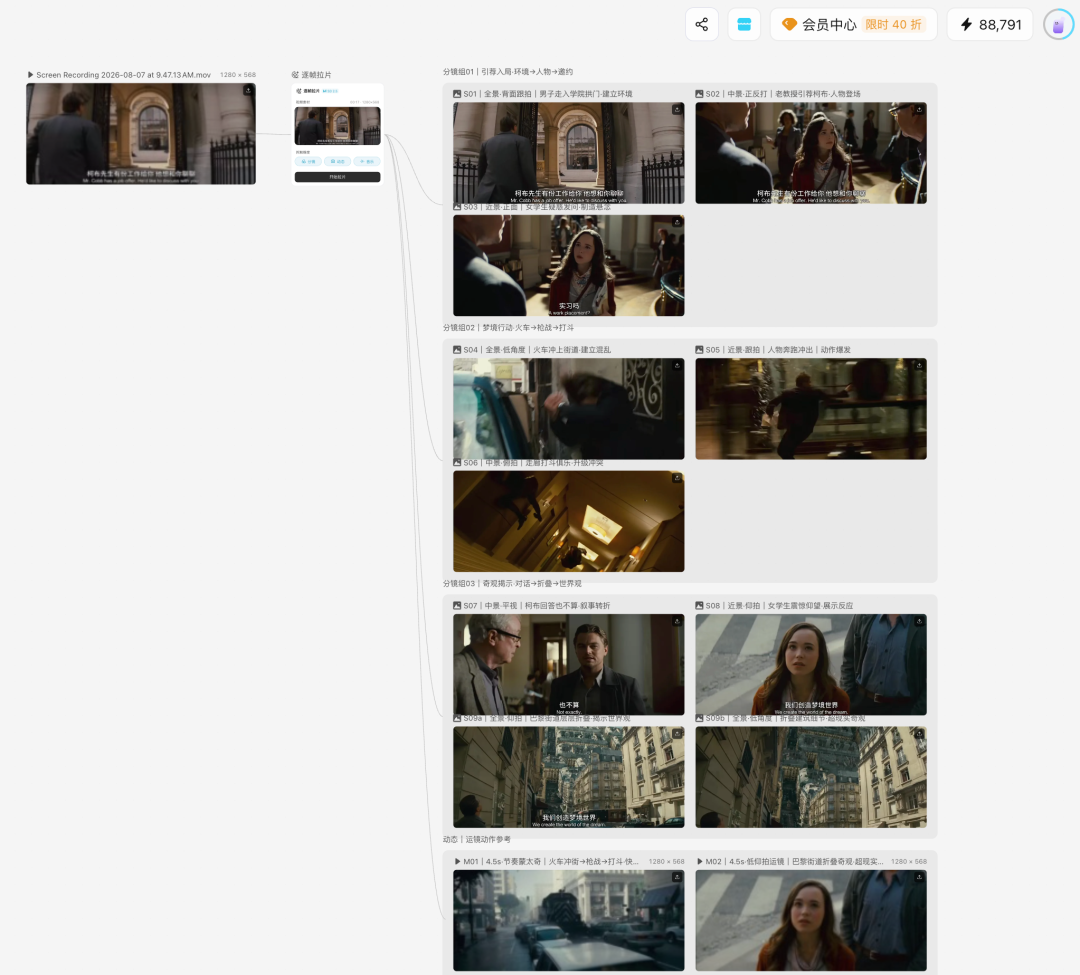 image-20260807112327443
然后我以此视频为母版,重新制作了一个类似风格的视频。
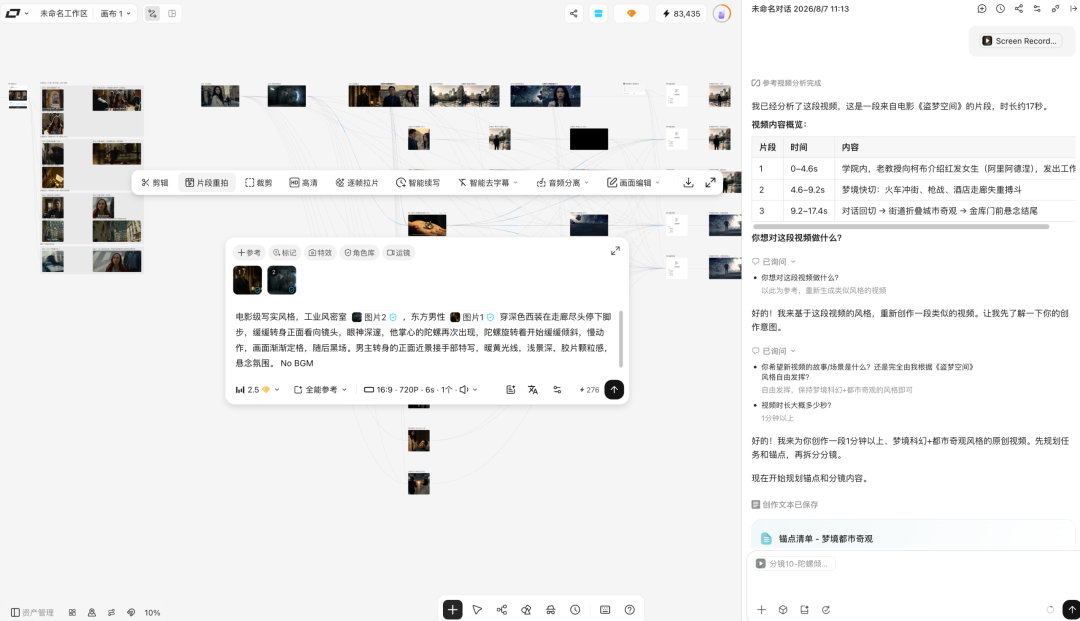 image-20260807132340793
我对其中的几个分镜不太满意,有些跳跃性导致叙事不连贯。于是我让 Agent 重新制作了分镜视频。
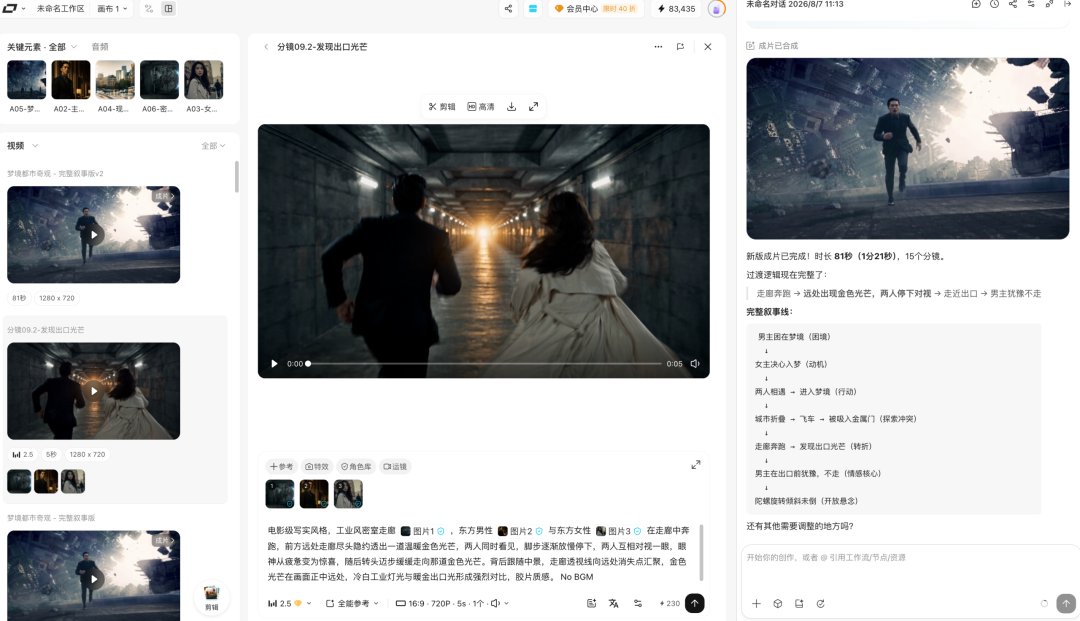 image-20260807123749774
给大家看一下我拉片复刻的这个片子完整的工作流。
整体体验下来,我发现 LibTV 的 Agent 对于我上传影片的理解 -> 复刻能力简直一流。
它几乎做到了把每个细分镜头都切碎,而且对于镜头之间的衔接也做的非常不错,我就加了一段文字描述,就把两个毫无关联的镜头衔接起来了。
完整的成品视频如下。
这条成片一共 73 秒。整个过程里,Seedance 2.5 负责生成具体镜头,LibTV 负责把参考片拆开、组织分镜、重做问题镜头,再把结果接回完整叙事。
亮点二:素材混剪我一直想去冰岛旅游一趟,奈何时间和钞票都不够。虽然我无法亲身体验,但是我可以做一个 AI 短片,俗称看过了就是去过了。
我上传了一些冰岛的素材,来让 LibTV 根据素材出了成片和混剪。
这是冰岛的其中一个画面。
这段冰川湖画面是一个 15 秒分镜。项目里还有环岛公路、荒原、黑沙滩、瀑布、极光和离去等镜头,每一段先单独生成,再由 Agent 按叙事顺序组织起来。
下面是成片
八个分镜节点全部生成成功,视频里的风声、海浪和瀑布声也保留了下来。长版负责讲完整故事,接下来我又拿同一批素材做了一个更适合社媒发布的短版。
下面是素材混剪
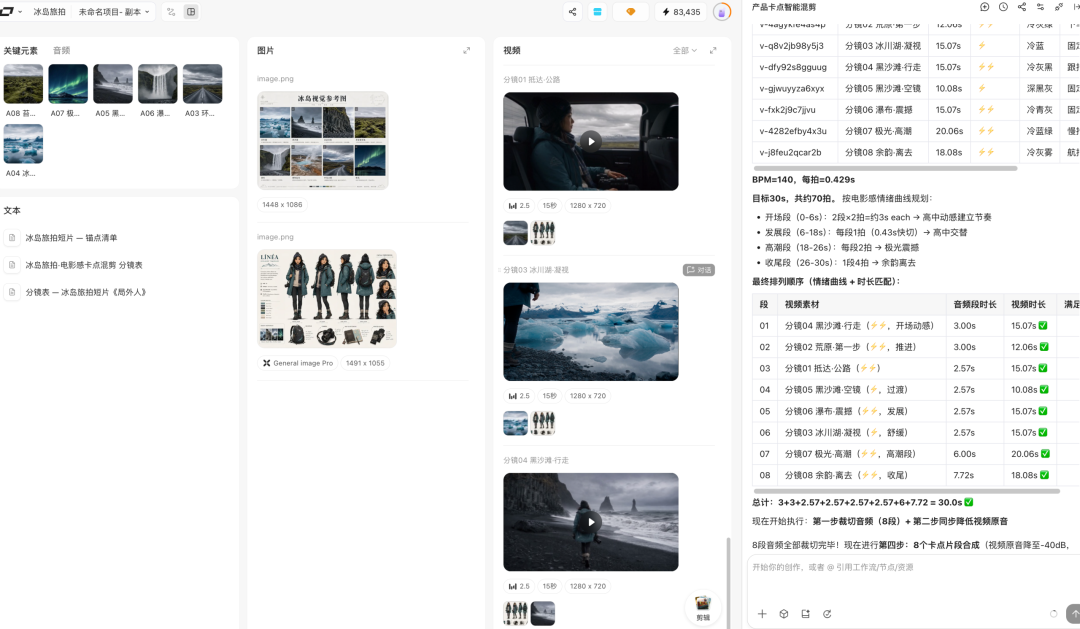 image-20260807135915754
最终素材混剪的成片如下:
素材混剪会理解视频、图片和音频里的内容,再根据要求匹配画面、安排顺序、补音乐和转场。
亮点三:片段重拍我觉得这是解决抽卡问题最关键的一个功能:片段重拍。一个 30s 的视频,只要其中错了两秒,就只要重拍这两秒就行了,这样能够告别整条视频重新抽卡,将抽卡直接变为按秒修改。
我先上传了一段脚本,让 LibTV 根据我的脚本理解,自动生成视频,如果哪里不满意,我可以针对其中的分镜进行秒级修改和替换。
我拿上面盗梦空间的来举例子,不知道大家注意到没,在上面的视频中,有一个片段是有出入的,我估计遗留了一个视觉 bug 来等大家发现一下 :)
这个场景,上一秒还是两个人出现,下一秒就一个人了。
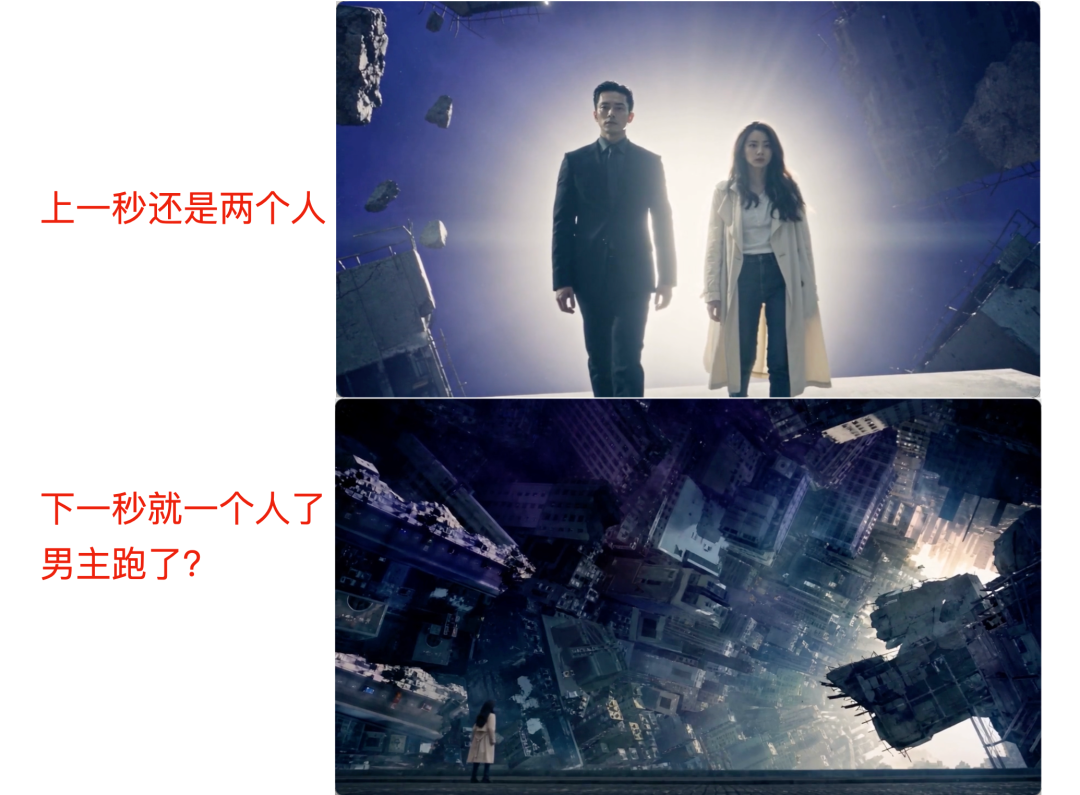 image-20260807150418336
下面我就用片段重拍,来针对这两帧重新拍一下。直接针对不满意的帧数和秒数做片段重拍就可以了。
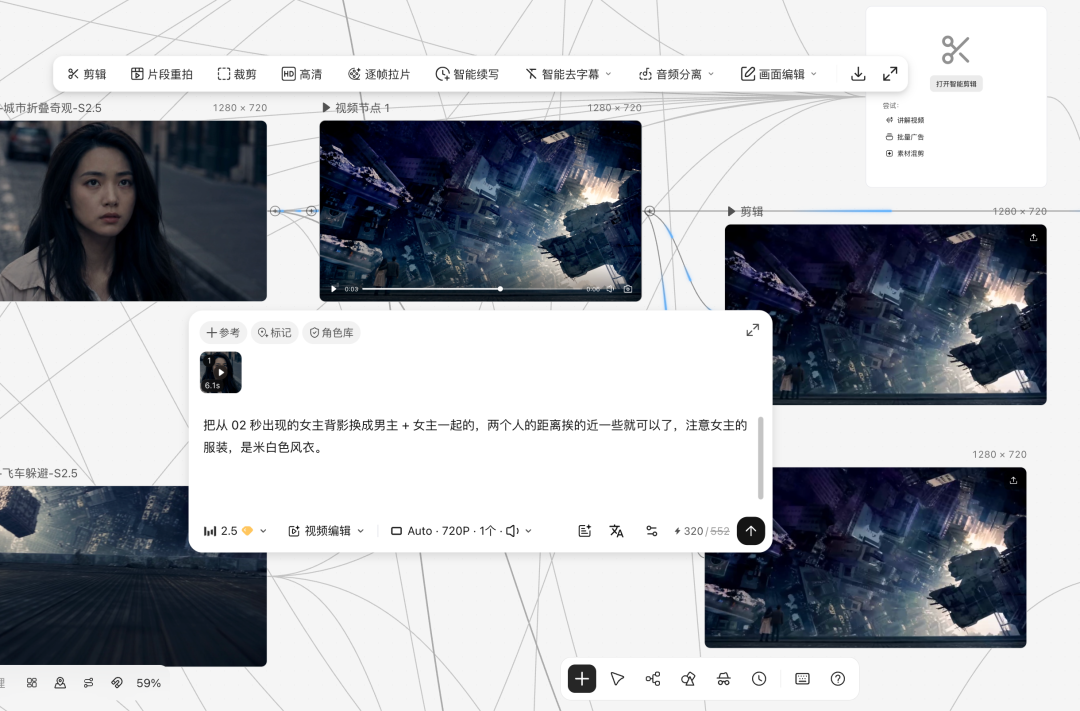
给大家看一下重拍后的效果,很丝滑的满足了我的要求。
这次 LibTV 的体验让我更加确定:AI 视频接下来重点要卷的,是返工成本和项目管理能力。
模型把画面确定之后,由视频创作工具来决定你能不能以低成本拿到最优质的效果。
Seedance 2.5 提供长叙事、多模态参考、音画同步和时间戳编辑,这是模型能力。而 LibTV 把角色、场景、Prompt、分镜、生成节点和剪辑结果放到一张画布里,再用 AutoLink 和 Agent 减少重复操作,这是产品能力。
LibTV 没有参与 Seedance 2.5 的模型研发,它做的是模型上面的创作工具。
而且我看了,LibTV 现在正在做活动:Seedance 2.5 的 720P 目前限时 58 折,低至 0.4 元/秒,最高赠送 60 条免费生成。720P 且包含参考视频时,活动价由 46 积分/秒降到 27 积分/秒。具体期限和赠送规则以页面实时展示为准。
产品入口:https://www.liblib.tv/
如果这篇文章你觉得还不错,谢谢你的三连,也希望可以转发给同样关注 AI / 科技 / 开发效率的朋友。 我是 cxuan,我们下期再见。
当前文章无评论,是时候发表评论了