

11月13日,ggml 和 llama.cpp 在同一天发布了 v1.0.0。没听过这两个名字?你用过或打算用的整个本地推理生态,都盖在它俩上面:Ollama 基于它,LM Studio 基于它,市面上大多数「一键装好」的工具,都是 llama.cpp 的精装房。年末正想给电脑装个不花钱、断网也能跑的模型——别急着动手,先花三分钟把选型看明白。小红书小红书
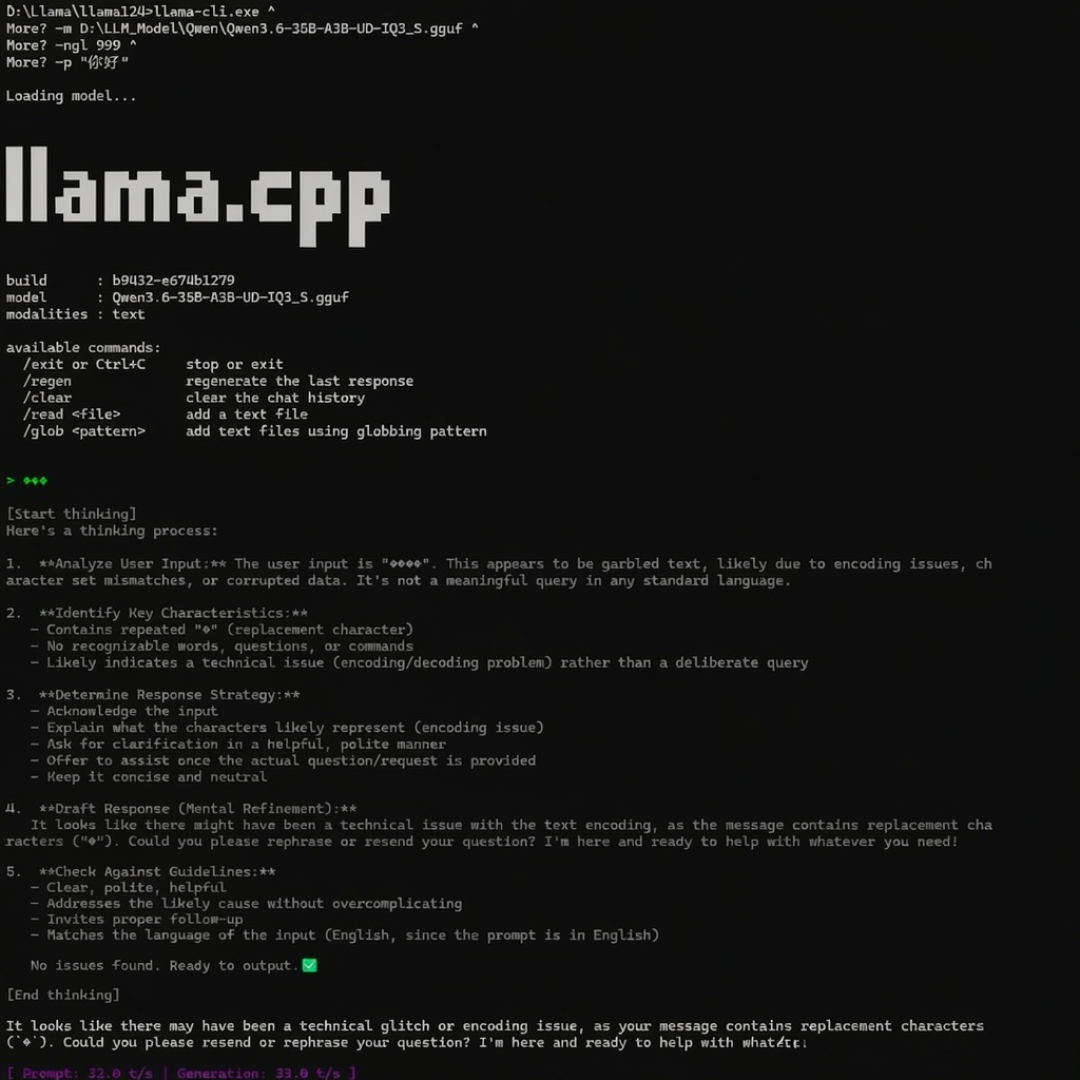
第一课:同一个模型,工具之间能差一倍速。有同学在 Intel Arc 140V 核显上实测:gemma4-e4b,Ollama 跑出 11.5 tok/s,llama.cpp Vulkan 后端 22 tok/s,接近翻倍。更反直觉的是,热门的 MTP(多 token 预测)在核显上是负优化,25.8 tok/s 直接掉到 20.8。这句话说透就一层意思:没有最强的工具,只有你的硬件配没配对引擎。知乎
选型三步,一步都别跳。
第一步,定用途。只想要个聊天界面,Ollama + Open WebUI 一条命令起服,够用。核显、老电脑想榨性能,直接上 llama.cpp 的 Vulkan 后端;要给程序开 API、多人并发,走 vLLM/SGLang(TGI 今年 3 月起已进维护模式,新项目直接绕开)。Mac 用户,MLX 路线优先。小红书知乎
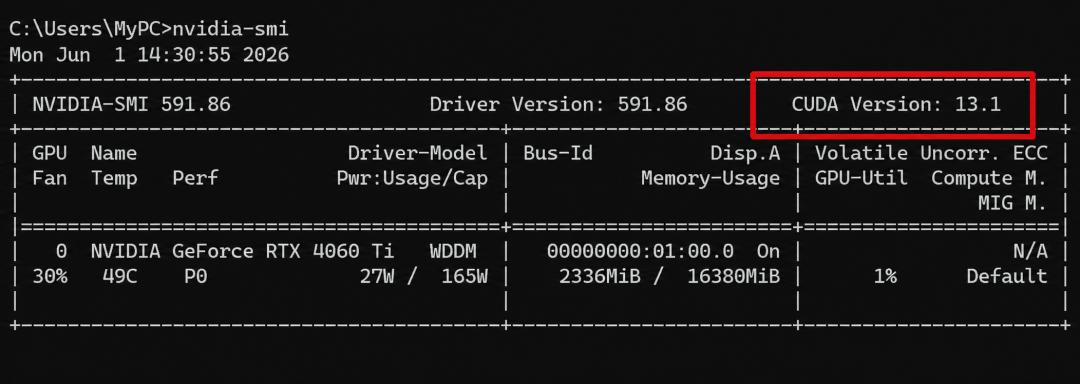
第二步,定硬件。N 卡独显兼容性最宽,基本闭眼装;核显用户记住两件事:找 Vulkan 后端,修 Windows 的 TDR 超时,不然长推理跑到一半直接崩给你看。统一内存的 Mac 跑 MLX,内存利用率高。LM Studio 赢在图形界面和模型切换,但它的应用本体闭源——极端敏感的数据,别拿它处理。知乎小红书
第三步,定边界。小显存想塞大模型,有把权重卸到内存、SSD 的方案。多台 Mac 联机、按芯片定制的专项工具也冒出来了。听着心动?新生态实测样本还太少,热点可以追,别重仓,教程不会告诉你的坑,最后都是你踩。小红书
1.0 之后,还有两条新规矩。版本号第一位变了,意味着有不兼容变更,先查兼容再升级;这次 1.0 顺手清掉了弃用接口,从旧版升上来的,先检查自己有没有在用被删的东西。小红书
另外,把热闻的水分挤干:「Mac 跑模型速度暴涨 6 倍」只对 MoE 模型成立,条件是 M3 Ultra 加 torch.compile,普通稠密模型平均只快 1.23 倍。用 Ollama、LM Studio、MLX 聊天的,这次基本不受影响。小红书
模型、引擎、交互,三层架构记一句话就够:模型决定能力,引擎决定性能,交互决定用法。先想清楚拿它干什么,再决定装什么——这才是年末玩本地推理最省钱的方式。知乎

当前文章无评论,是时候发表评论了