

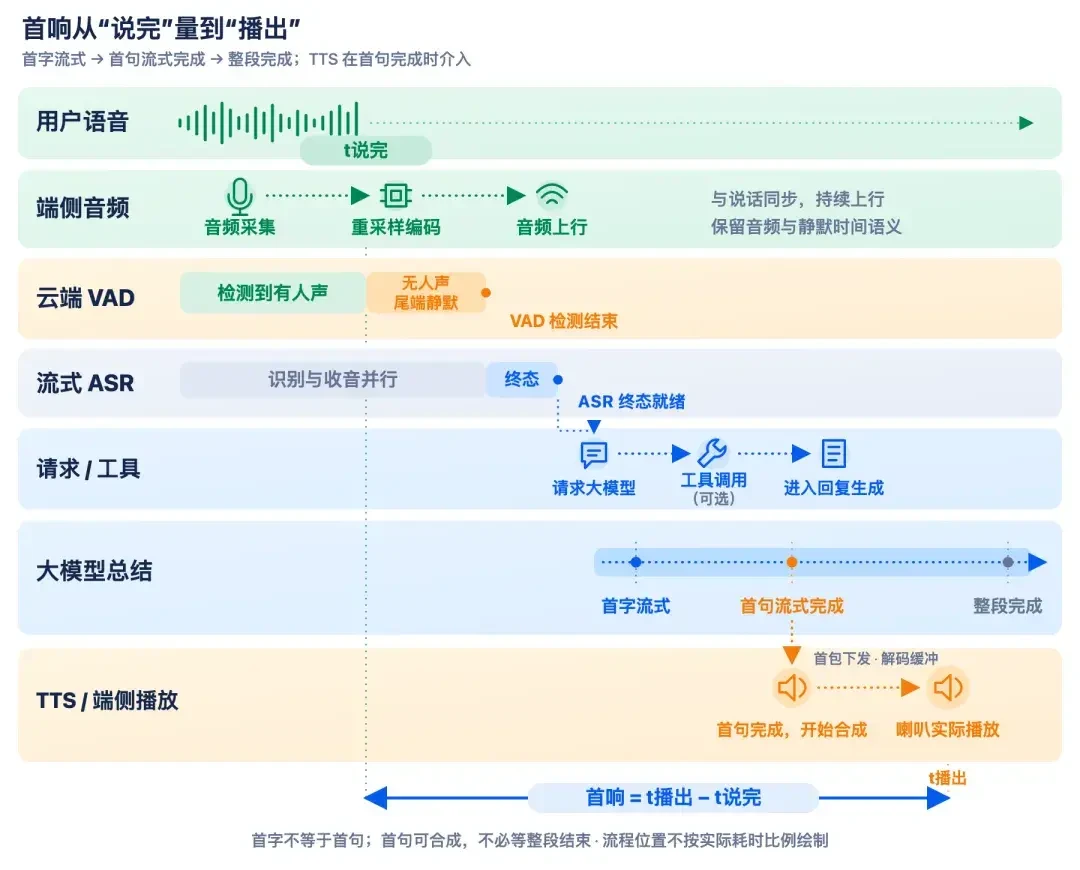
你跟AI说一句话,它先找人把你的话记成文字,递给另一个"脑子"读完想答案,再把答案交给第三个"播音员"念出来。过去几年所有语音交互都是这么干的,业内叫级联——听着像流水线,毛病也确实出在这条流水线:三段接力,延迟累加,你语气里的起伏、停顿、迟疑,在"转文字"那一环基本被削平。知乎
11月19日,火山引擎把豆包实时音视频通话模型 SeedRealtime 1.0 的 API 全量开放了。其实8月初它就在豆包App免费上线,这回轮到所有开发者直接接。它干脆取消分工,把声音、画面、时序、表达全塞进同一个模型。知乎知乎微博
不再是"问一句答一句"
官方给的场景里,最扎眼的是这个:用户把整颗咖啡豆倒进萃取手柄,没人提问,AI自己开口提醒"得先磨",萃取完还根据油脂和出液量主动建议缩短时长。知乎
翻译一下:AI开始看着你干活、忍不住插嘴了。
其他几个硬能力,都是冲着级联的老毛病去的——
分得清人:多人聚餐,它能结合画面和声音记住谁是谁,七嘴八舌里不认错人。知乎
抗噪:机场里过滤旁人闲聊,你问航班,它调出自己刚才"看到"的大屏信息来答。
节奏:火山引擎给的口径,相比级联模型,音视频对话的节奏问题少了一半,一轮对话完整聊下来的概率明显提升。
这不只是豆包一家的热闹
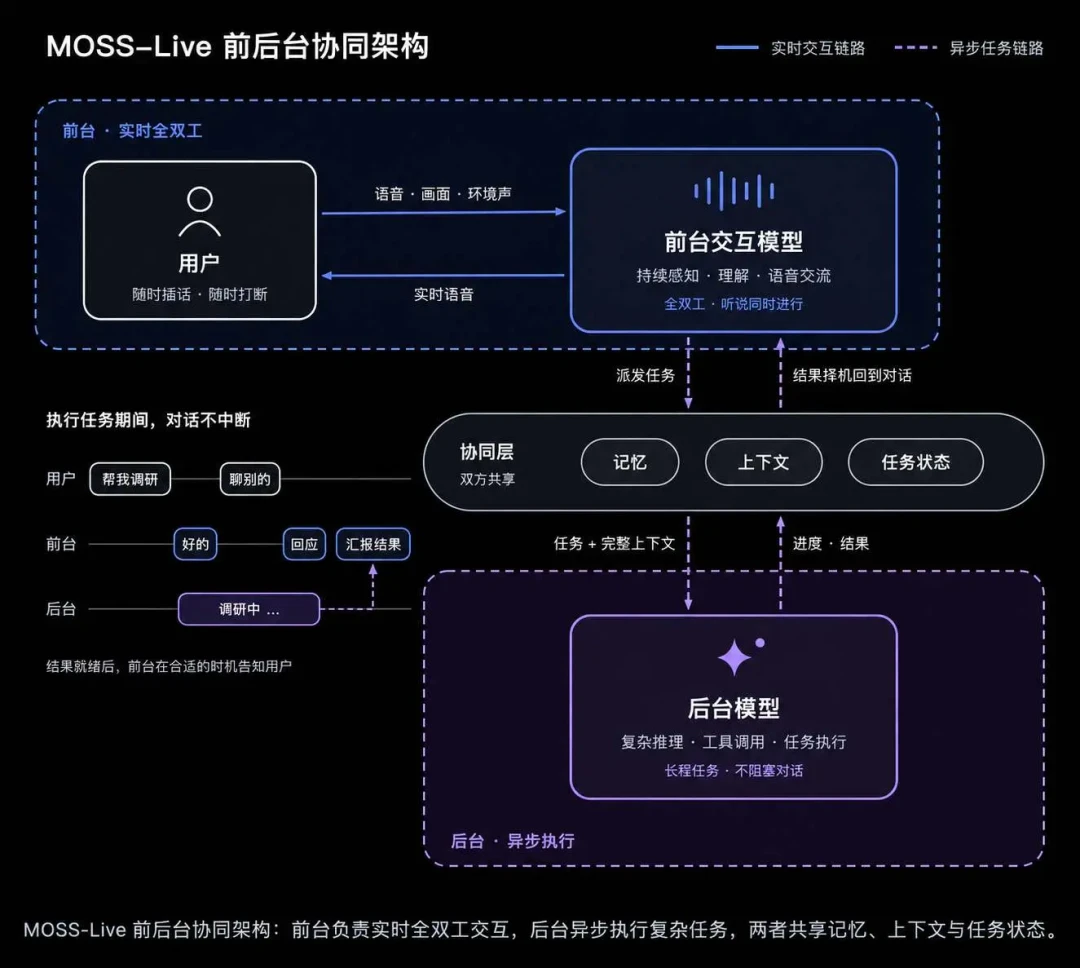
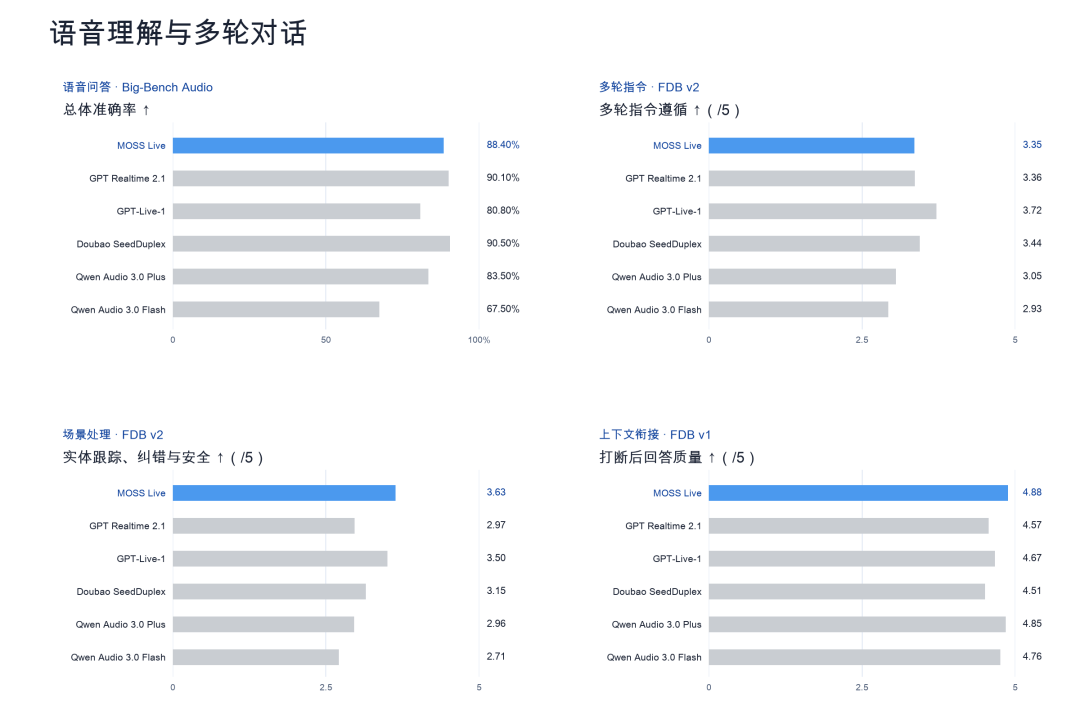
把时间线摊开看,实时语音这个赛道这两月明显在集体换挡。11月初,全双工实时交互系统 MOSS-Live 正式发布。10月下旬,Qwen-Audio-3.1-Realtime 放话背景杂音响应骤降82%。同一周,科大讯飞发布星火语音基座大模型 SparkAudio 1.0。更早的 GPT-Live 已经把"边看边听边说"这条路蹚了出来,SeedRealtime 从发布起就是对标着它干的。知乎知乎知乎微博
方向已经成了共识,差的只是谁先开放API。
冷水也得泼
知乎上有做实时语音落地的开发者给了很克制的反馈:端到端模型是黑盒,专有名词和强业务规则没法逐段校验——客服听错一个工号,整单任务就废。所以任务型场景(客服、工单、参数念读)眼下主流仍是级联,图的就是可拆、可控、可验收。知乎
B站UP主评论区那句热评挺精辟:"声音装上了更像人,也会更慢。"想要像人,就得多等半拍——自然度和确定性,目前还是跷跷板。哔哩哔哩
对玩AI声音的人意味着什么
TTS没有消失,是被大模型"吃掉"了——从单独采购的一环,变成模型直接吐出的输出。纯配音的活儿会持续便宜,"会看、会听、还能接住话"的声音会越来越值钱。
最近在给产品接实时语音的,端到端方案值得实测一轮。别只试听音色,就测一件事:你话说到一半,它接不接得住。
当前文章无评论,是时候发表评论了