

11月13日凌晨,很多人的Outlook开始转圈。
邮件发不出去,收件箱停在几小时前。起初大家以为是自己网络的问题,直到Downdetector上的报告一路往上冲,才确认是微软365塌了。
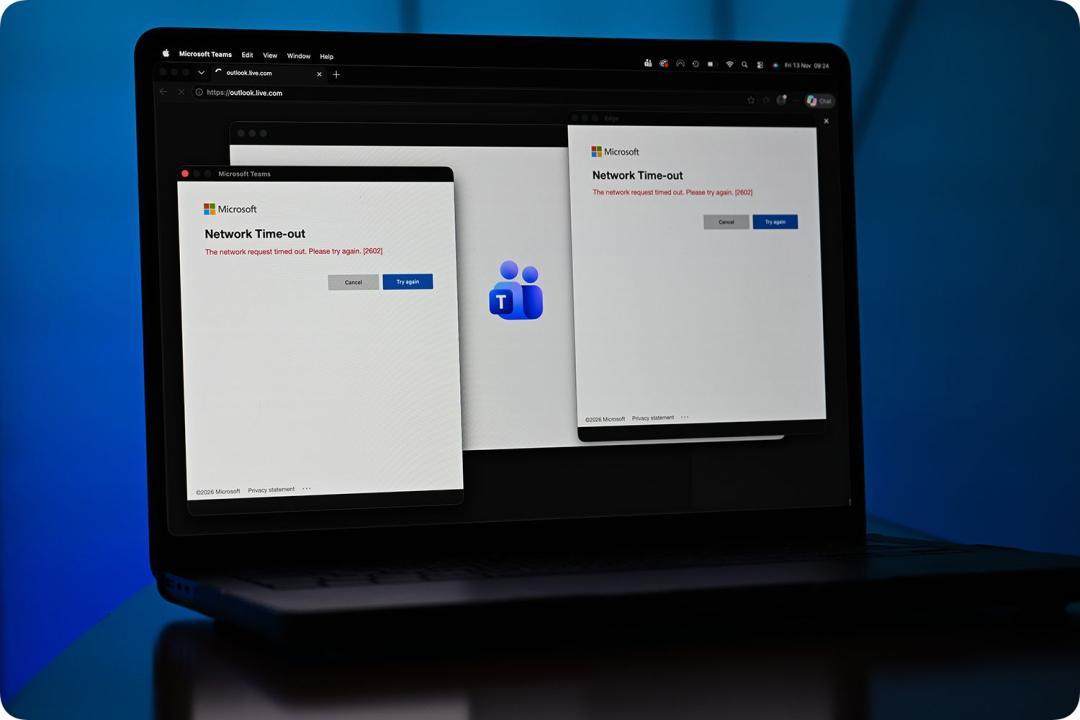
这一停,接近24小时。Outlook、Teams、SharePoint、OneDrive、Copilot接连失守,74个国家和地区被波及,全球故障反馈超过740万条。央视新闻
英国几百家医院用回了纸质病历,部分手术临时取消,NHS一百多万员工的邮件和会议系统也跟着停摆。英国法院的判决只能推到下周一。日本数字厅的政府共通平台GSS收发不了邮件,各部门改打电话、发短信。德国一家酒店的泳池氯气警报邮件没送出去,15人出现呼吸道刺激,4人送医。第三方机构估计,停摆造成的生产力损失在70亿到160亿美元之间。爱范儿
事情过去几天,微软的初步事故报告把链条摊开了。不是黑客,也不是AI,是三个单独看都不该出事的环节,正好凑到了一起。
第一个环节,是7月的一个补丁。
Microsoft 365的流量都要先经过网络网关,像进地铁先过闸机。网关内部有个“锁”的机制,让多个线程排队访问同一份资源。7月的补丁里藏着一个缺陷,会让锁竞争在特定流量下失控,CPU和内存被吃光,服务器失去响应。它跑了三个多月没出事。因为微软压测用的服务器核心少,队列短,问题显不出来;线上机器核多,几十上百个线程同时挤到锁前,等待时间被放大,反而更容易卡死。
第二个环节,是事故发生前15小时的一次切换。
Teams原本跑在备用网关上,被切到了主网关,和Outlook、Exchange挤在一起。微软说这是日常操作,负载上升本身不异常。
第三个环节,是主网关本来就有14%的服务器因为另一个问题下线,正在慢慢恢复。
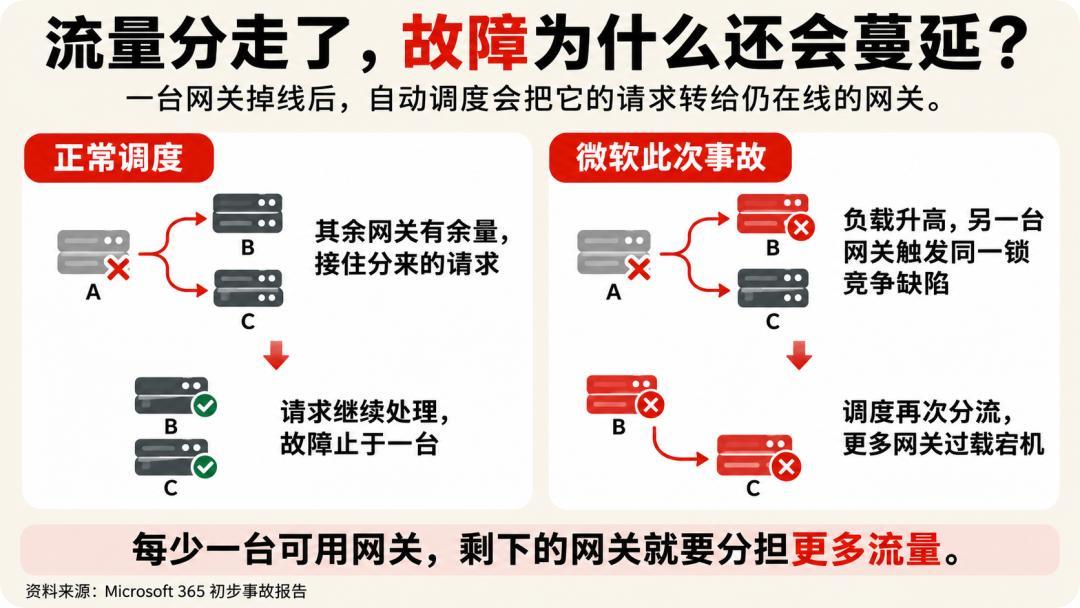
三个条件叠在一起,又撞上美国上班的流量高峰。主网关剩下的服务器一台接一台卡死。自动调度把用户往健康服务器上赶,健康服务器也带着同一个缺陷,于是故障像骨牌一样传开。最惨时,超过80%的网关服务器失去响应。知乎
接下来的24小时,几乎每一种常规手段都失效了。重启,服务器刚回来就被积压的流量灌满。自动恢复,脚本假设的是少数节点故障,80%的节点同时躺下,它没有对应动作。回滚,补丁是三个月前上的,直接退回去会带回当初要修的问题,工程师只能写一个新更新,把那段代码改回已知正常的状态。Teams、OneDrive、SharePoint能切到另一套网关,恢复得快。Exchange体量太大切不出去,只能留在主网关上硬扛。所以邮件瘫了将近一天,而Teams的聊天大部分时间还能用。
后面的事,很多人关心的是赔多少。
按微软的企业服务协议,某项服务一个月可用率低于99.9%,退这项服务当月费用的25%,低于99%退50%,低于95%全额退。这次邮件停了近24小时,按30天算可用率约96.7%,也就是退半个月的邮件服务费。一家100人的公司用商业标准版,一个月1400美元,算下来最多退700美元,还得自己去申请。差评
真正值得琢磨的,不是这次赔了多少钱,而是那句“我们还有充足余量”。
容量规划里的余量,是按正常请求的成本算的。可缺陷会改变单请求成本,负载越高,每个请求越贵,而且是非线性的。账面上的那点余量,在这种时候等于没有。还有测试环境。压测机核心少,生产机核心多,压测只验证了功能,没验证并发。以及那道本该阻断连锁反应的分区隔离,微软的报告只说它被“另一个独立问题”影响了,没说是哪个。
把这些拼起来看,这次不是某一个人按错了按钮。是三个多月的灰度、一次日常的流量切换、一批核数不够的测试机、一个按平均数算的余量,最后被一个普通工作日的流量高峰同时点着。
全球这么多企业把身家押在同一套办公系统上,一家出事,半个地球跟着停摆。换掉它?资料要搬、流程要改、甲乙方的系统还都在对面。大多数公司不是不想换,是换不动。
这一点,可能比24小时的宕机更值得记住。


当前文章无评论,是时候发表评论了