






18
12
ChatGPT的记忆条目96%是自己写的:设置里那份档案,顺手去读一遍
2026-11-02 22:50:35
0点赞
2收藏
0评论
打开ChatGPT设置,点「个性化」,弹出的「记忆摘要」像一份熟人写的档案。你做什么工作、最近盯什么方向、桌上摆着什么机器、连写作习惯都一条条列着。有位媒体人的摘要里甚至写着他设备的型号,精确到内存多大。
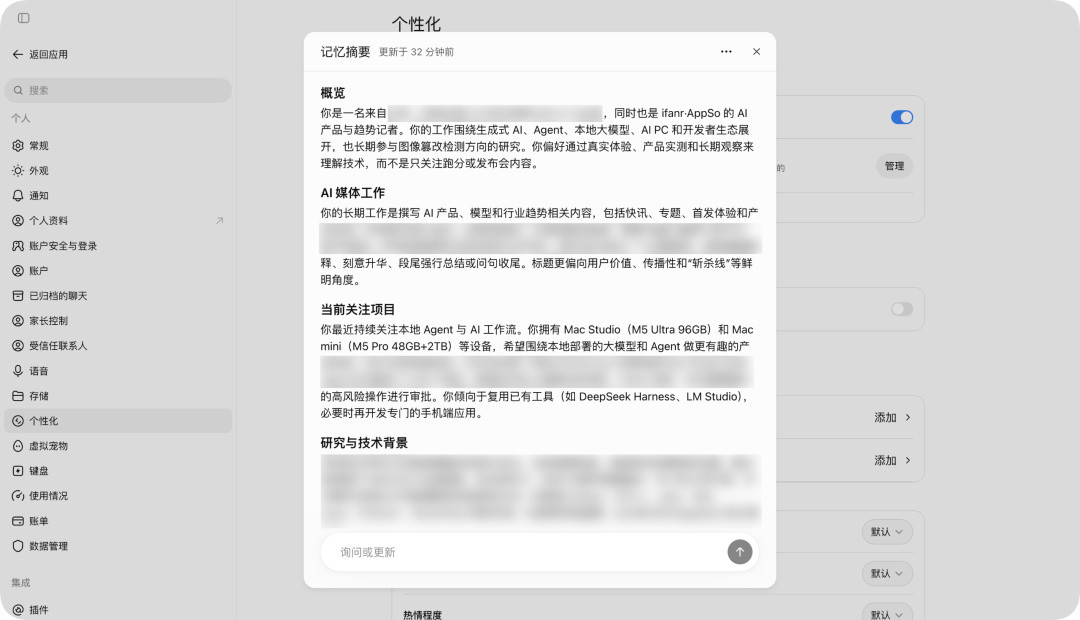
11月2日,这个页面和一篇论文把「ChatGPT偷偷给用户画像」的话题顶上微博热搜。吓人的说法是「偷偷画像」,论文里的内容比这四个字绕一点。它不是在偷听你,是在过度记你。
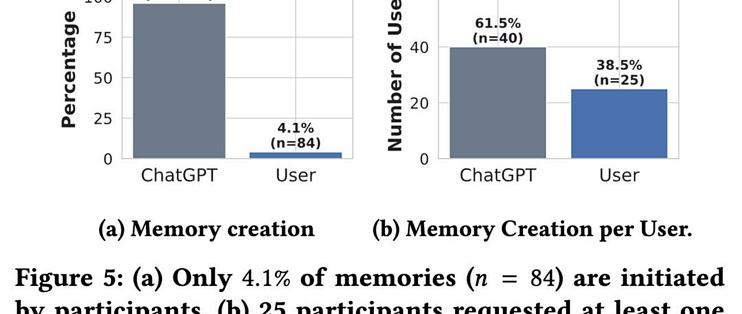
论文名字起得直白,《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》,被ACM Web Conference 2026接收。做法是利用GDPR给的数据访问权,80名用户向OpenAI调出了自己完整的聊天记录和系统为他们存下的全部记忆条目,一共2050条。
这2050条里,96%是ChatGPT自己决定存下的。你没说过「记住这个」,是它判断这条信息值得留。
而且这个机制默认开着,没自己动手关过的人,从第一次对话起它就在记。
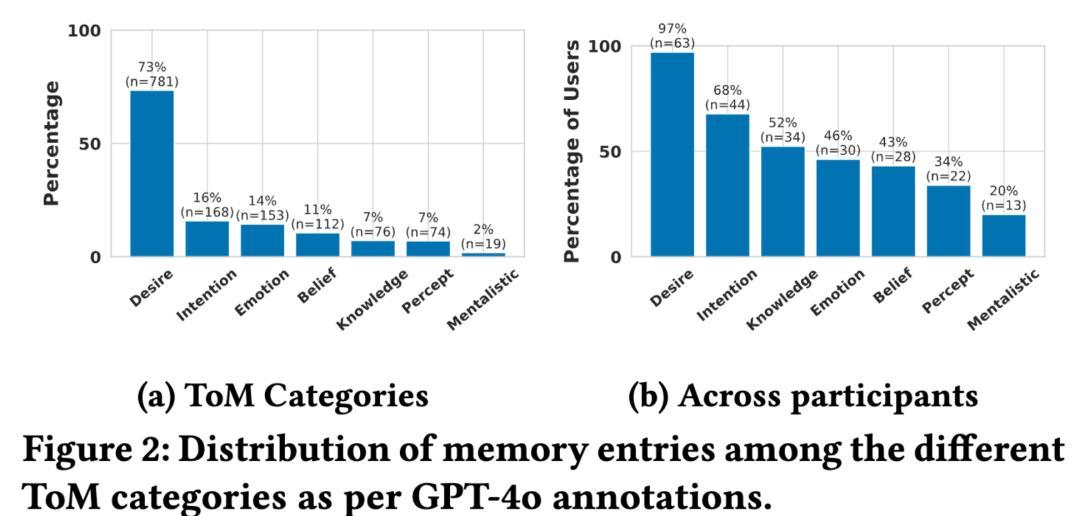
过半,52%,不是事实记录,是对你心理状态的推断。你想要什么、打算干什么、信什么。其中欲望和意图这两项相对稳定的内容合计占近九成。论文举了个例子,一条记忆写着「某某对失败有恐惧,尤其涉及重大职业决策」。当事人可能只是吐槽过一次晋升评审,AI把它写成了性格。
这里得替记忆功能说句公道话。没有它,AI是个失忆者,你每次开新对话都得重新交代一遍自己的行业、孩子的年级、饮食禁忌。ChatGPT、豆包今天好用,一半功劳在这个记忆上。问题不出在记,出在记了什么。
样本只有80个人,这些比例放到更大规模上还没人复核。但结论的方向,AI自己在决定记你的什么,这件事不把样本翻一倍也改变不了。
传统平台的画像画的是你做过什么,买了什么、点了什么。ChatGPT画的是你是个什么人,论文借了人格心理学的词,叫「特征性适应」。行为画像会过时,性格画像不容易过时,而且它会拿着这幅你的画像,去回答你以后问的每一个问题。
真正的代价藏在这儿。一幅不准确的画像,比没有画像更危险。它要是给你写过「害怕失败」,你下次问「这个工作机会要不要接」,它可能不动声色地递一个更保守的答案。你以为在问新问题,其实在拿旧印象过滤后的回答。而这幅印象,你此前从没看过一眼。
28%的记忆条目够得上GDPR意义上的个人数据,有的涉及健康。这个数字不算大,可放在一个你从没打开过的页面里,性质就变了。
那怎么办?不卸载。三步,五分钟。
第一步,看。网页版设置、个性化、记忆摘要,手机端路径差不多。只要你跟它聊过几次天,这个页面里就有你的内容。
第二步,改。每条记忆都能单独删,嫌一条条删麻烦,就在页面的输入框里直接告诉它哪几条写错了,让它重写。想一次看全版,把这句贴给它,「基于你保存的关于我的所有记忆,完整写出你目前对我的描述,包括身份、工作、偏好和性格推断,逐条列出来,不要美化。」
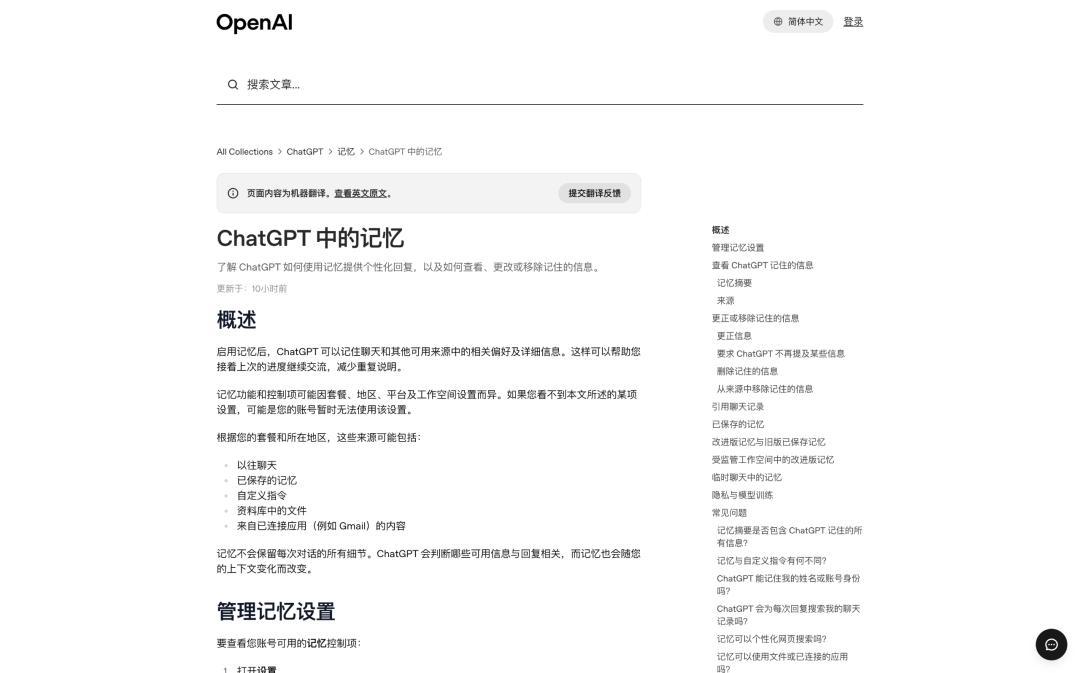
第三步,决定留不留。读完觉得写得八九不离十、确实省事的,留着。觉得膈应的,同一页关掉记忆开关,或者一键清空。关掉代价是便利性,留着代价是被看穿,这笔账只有自己会算。
顺带一句,这不是ChatGPT一家的事情。豆包的设置里也有一张类似的记忆清单,用国产助手更多的人,去把那张也翻一遍。
回到开头那份档案。它里面最吓人的一行,可能不是设备型号,是那些看着很贴心、其实有点偏的性格句子。它反正会记住你,从现在起,让它记住真的你。
内容由AI生成