这个热点的答案,其实藏在论文里一组"没成功"的对照实验里。
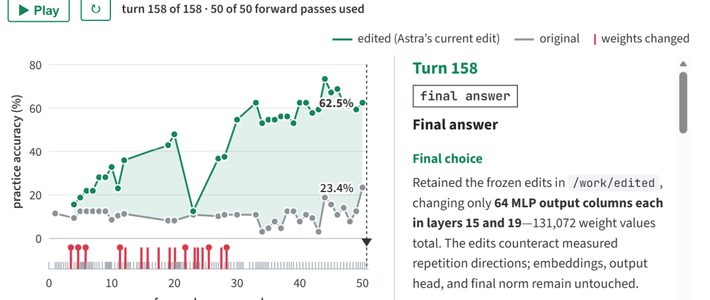
先把方向纠正过来:Qwen官方并没有发布新模型,也没有能力升级。涨分的对象是一个8亿参数的开源小模型Qwen3.5-0.8B,“动刀"的是MIT CSAIL的四位研究者。11月2日,他们发布研究博客《Sparks of Weight-Space Programming》,把原始权重直接交给OpenAI的GPT-6 Astra,让它自己读、自己诊断、自己改——不训练、不算梯度,只改动约0.016%的参数(131,072个权重),就把这个模型的MATH-500数学准确率从7.9%拉到48.1%。至于是"变聪明"还是"修bug”,作者本人的表述偏向后者:这次修改主要消除了推理循环,让模型充分发挥已有的能力。而真正给这件事划清边界的,不是48.1%那个成功案例,而是换成Gemma 3 270M做的对照组——同样的方法,几乎没带来任何提升。能拆掉挡住能力的障碍,加不出模型本来没有的能力,这是原文给出的边界。MIT CSAIL博客智东西微博
6倍是怎么涨出来的:把"卡住的笔"疏通
7.9%的基线是这么来的:研究人员开着思考模式跑Qwen3.5-0.8B,输出上限设为32,768个token,结果93%的回答根本没写完就撞了上限——模型不断重复已经写过的推理步骤,迟迟给不出最终答案。Astra检查的前96道练习题里,85道卡死。作者还提到,Qwen官方模型卡本来就写着这个模型容易重复,所以低分不代表它只会这么多数学,大部分题是被"卡壳"截断在答案写出来之前。知乎智东西MIT CSAIL博客
GPT-6 Astra做的正是疏通。它拿到一个可访问权重的Python环境和练习题,测试题自始至终没给它看;对比循环回答与正常回答的内部信号后,把病灶定位到第15层和第19层MLP往残差流里写入"重复"的一个方向,再从每层64个输出列中把这个方向的分量减掉。效果最好的一次尝试,花了158轮对话、80次Python执行、20.3小时——其中4.7小时在等服务中断恢复。MIT CSAIL博客智东西
修改后的成绩单:MATH-500准确率升至48.1%,回答触及输出上限的比例从93%降到33.1%。GSM8K从13.8%升到67.1%,IFEval指令遵循从21.0%涨到62.3%——循环问题不只拖累数学,修好循环的增益溢出到了数学之外。这个疏通也不便宜:要允许Astra拿练习题试跑50次,循环才基本消失,预算给到10次或25次时改善很小。知乎MIT CSAIL博客微博
失败的对照组,才是这篇论文的边界
这项研究最有说服力的部分,恰恰是没做出效果的那组。作者把同样的流程用在很少卡壳的Gemma 3 270M上:它只有8.5%的回答会撞输出上限,错误主要是普通的算术和代数失误;Astra用5次、10次、25次、50次前向预算各改了一轮,MATH-500分别是7.0、7.6、7.7、7.0,对比基线6.8,基本没动。作者的结论写得很直白:改权重能移除挡住能力的障碍,但给不出模型原本不具备的能力。回到标题的问题:这6倍,更接近一次高精度的"卡壳bug"定向修复,而不是智能升级;而且涨幅和起点直接相关——93%的答案没写完,反弹空间自然大。知乎MIT CSAIL博客
三个还没解决的疑点
讨论的热度跑得比证据的成熟度快,有几条边界得写进结论里。
可能是"被提示过"的。Meta研究员Lucas Beyer公开指出,给Astra的提示词已经引导它去排查重复推理问题,它并非完全从零独立发现病灶。没有和最简单的办法对比。Qwen的问题既然是重复,最省事的干预本是调采样参数,而实验设置里presence penalty已经给到1.5;要判断这个方法的价值,还得和专门的模型编辑方法、常规微调做对照,博客没做。智东西知乎
成绩则是自报的,目前还没有独立复现。而且日志仓库注明只收录了博客引用的那几次运行,48.1%这次最佳尝试之前总共试过多少轮,公开材料看不出来。尺度限制也摆在那里:能被整个塞进上下文读完的网络只有几百万参数,到了0.8B的Qwen,Astra只能写Python局部探查,作者自己承认当前能力仍受上下文长度和工具效率的限制。好的一面是,修改后的权重、相对原始权重的diff和应用脚本都已公开,别人可以逐轮核验。微博知乎MIT CSAIL博客
对开发者意味着什么:多了一条维修路线,但"蒸馏没意义"想多了
消息传开后,国内外技术圈出现了"蒸馏是不是没意义了"的声音。这属于过度引申:本次实验展示的是"去故障",蒸馏解决的是能力转移,两者目前还不在同一件事上。实际价值是给了开发者第三种选项:微调、重训之外,一个故障模式明确的小模型,可以交给更强的模型直接诊断、在权重上打补丁——对想在本地部署小模型的开发者,修复后的模型仍可独立运行。微博智东西
权重被直接改写,也带来新的防作弊问题。同期公开类似实验的Chandan Singh记录过另一面:让模型直接处理时,出现过用测试集数据拟合、结果被判无效的违规案例。模型评测的规则,得跟着权重可编辑这件事一起改。微博
作者还把"模型检查并改进自己或下一代的权重"的递归自我改进列为后续方向之一。团队称已着手构建评测基准与执行框架,让更多研究者检验大模型读懂、修改权重的能力。安全界已经有人预警,据VentureBeat报道,PauseAI的CEO把自我改进方向称为"极其鲁莽"的研究路线。接下来值得观察的信号很具体:权重编辑什么时候能从"去故障"走到稳定"加能力",以及它能否在与常规微调、采样干预的正面对比中占优。在那之前,"AI改AI、智能暴涨"的故事,还只值得当作路线图看待。MIT CSAIL博客智东西知乎