
















16
20
AI进入“多模态理解与执行”阶段
2026-09-22 08:18:45
0点赞
0收藏
0评论
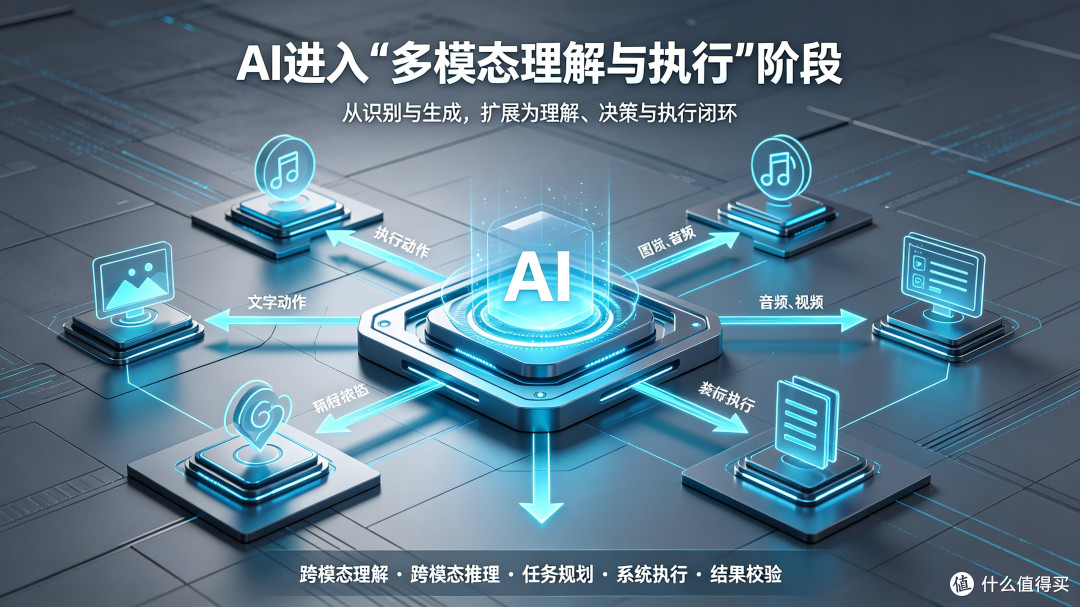
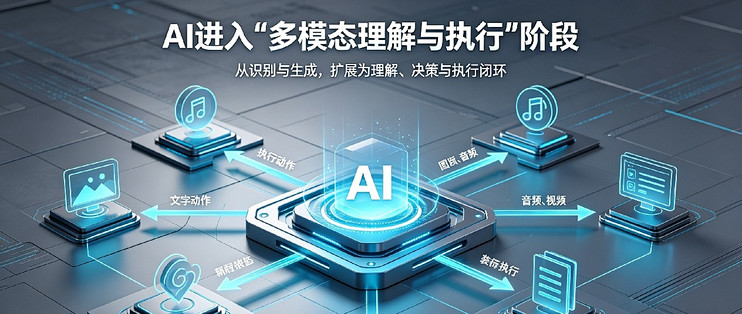
AI正在进入“多模态理解与执行”阶段。过去,AI主要处理单一模态,要么识别图像,要么理解文本,要么生成语音;今天的AI系统开始同时理解文字、图片、音频、视频、表格和界面操作,并把这些理解转化为实际行动。2026年,AI的核心能力边界,正在从“识别与生成”扩展为“跨模态理解、决策与执行闭环”。
一、为什么多模态理解与执行成为主线?
1. 真实业务本身是多模态的
企业单据、客户聊天、产品图片、会议音频、业务报表、系统界面,往往同时存在于不同模态中。AI必须跨模态理解,才能完整还原业务场景。
2. 纯文本AI无法覆盖复杂任务
只靠文字描述,AI难以理解表格结构、图片细节、视频流程和界面状态,很多任务停留在表层。
3. 用户交互正在自然化
用户越来越希望用截图、语音、视频片段直接提问,而不是把所有信息都转成结构化文本。
4. 执行闭环要求跨模态感知
要完成操作,AI必须先“看懂”界面、“听懂”语音、“读懂”文档,再决定点击、录入、汇总或回复。
二、多模态理解与执行包含哪些能力?
1. 跨模态理解
同时识别文本、图片、音频、视频、表格、界面等信息,理解不同模态之间的关联。
2. 跨模态推理
基于多种信息综合判断,例如从表格数据、产品图片和客服对话中推断问题原因。
3. 任务规划
把复杂目标拆成可执行步骤,确定先查什么、再看什么、最后做什么。
4. 界面与系统执行
将理解结果转化为点击、录入、查询、汇总、回复等系统操作。
5. 结果校验
检查执行结果是否符合目标,判断是否需要修正或补充信息。
三、行业正在发生哪些变化?
1. 从“单模态识别”走向“跨模态理解”
AI不再只看一种数据,而是把多种信息合成同一个业务场景。
2. 从“内容生成”走向“任务执行”
多模态AI不仅输出描述,还推动系统完成实际任务。
3. 从“被动回答”走向“主动操作”
AI根据业务状态主动执行操作,而不是等待用户逐条指令。
4. 从“模型能力”走向“系统能力”
稳定性来自模型理解、工具调用、流程编排和结果校验的协同。
四、结尾
AI正在进入多模态理解与执行阶段。
未来,真正有价值的多模态AI,不是能识别更多模态,而是能把跨模态理解转化为稳定行动。成熟的多模态系统,一定是“看得懂、能推理、会执行、可校验”的闭环系统。