











 深耕数码兴趣领域




5
8
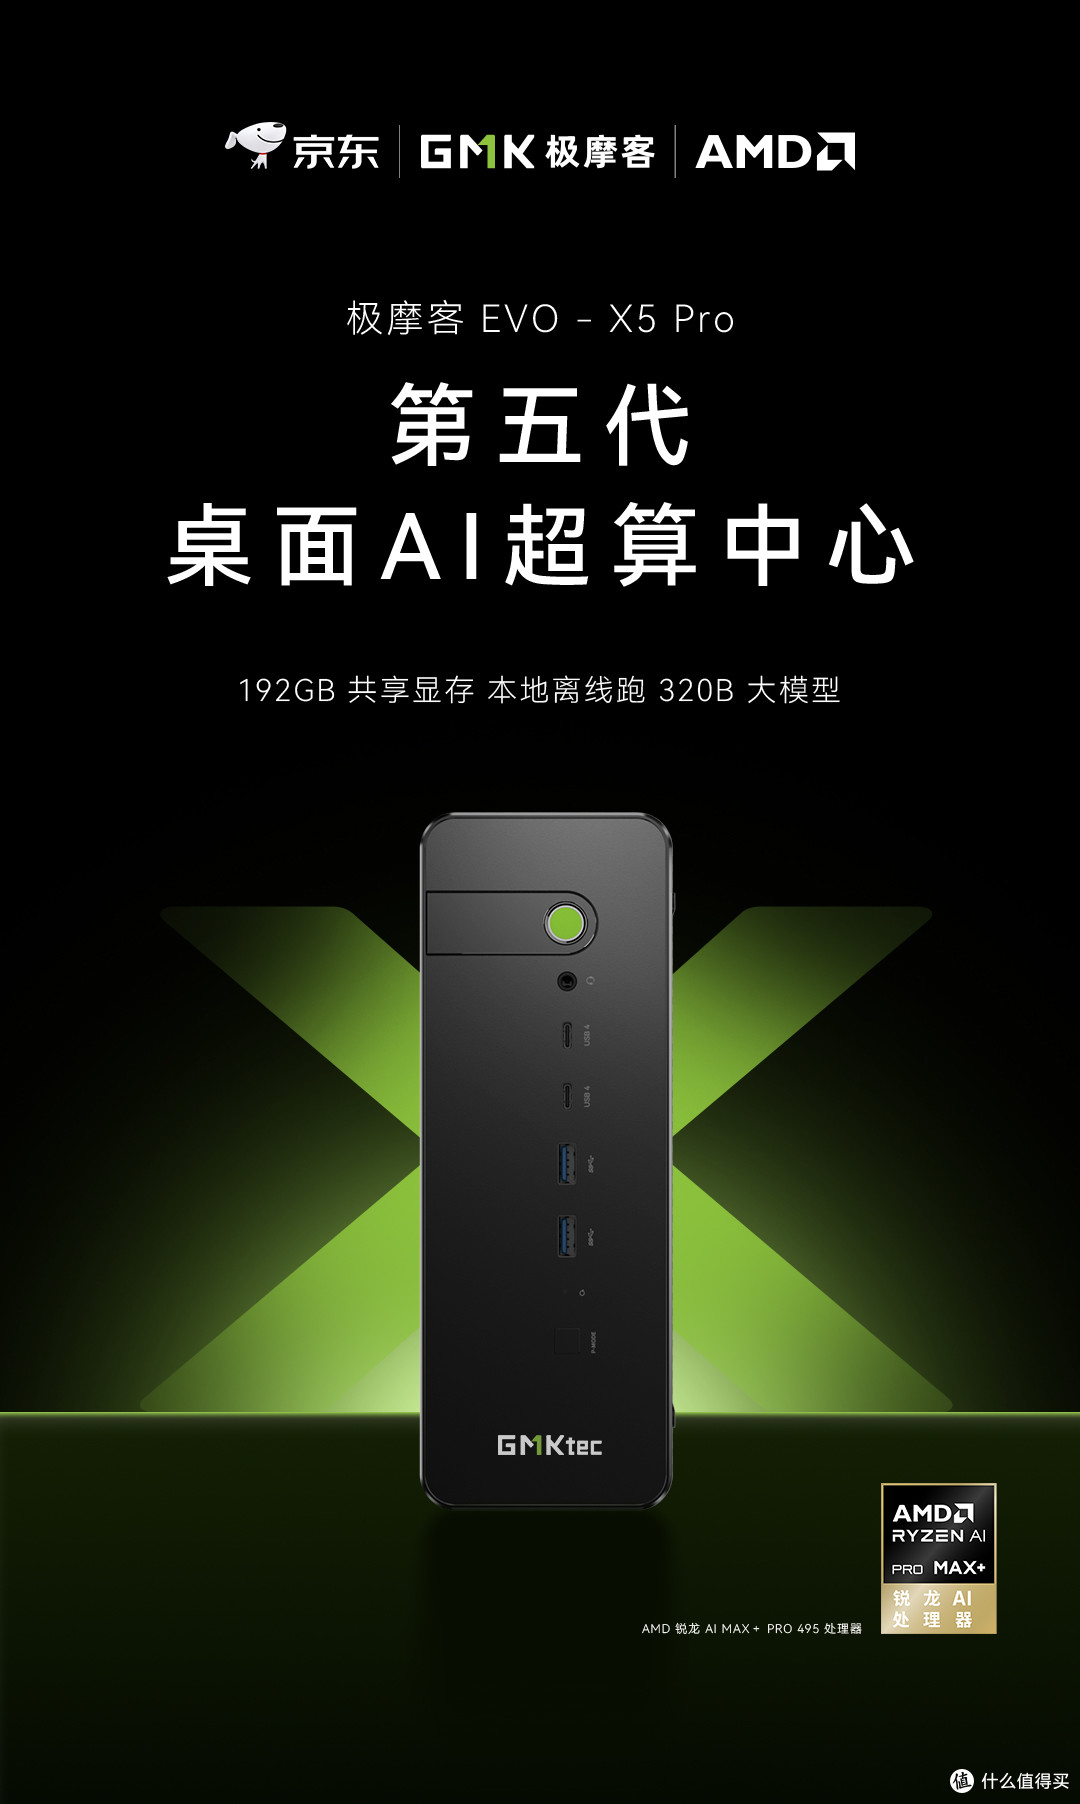
极摩客 EVO-X5 Pro 用 192GB 统一内存,装进 3.4 升小主机
2026-10-27 11:46:32
1点赞
1收藏
0评论
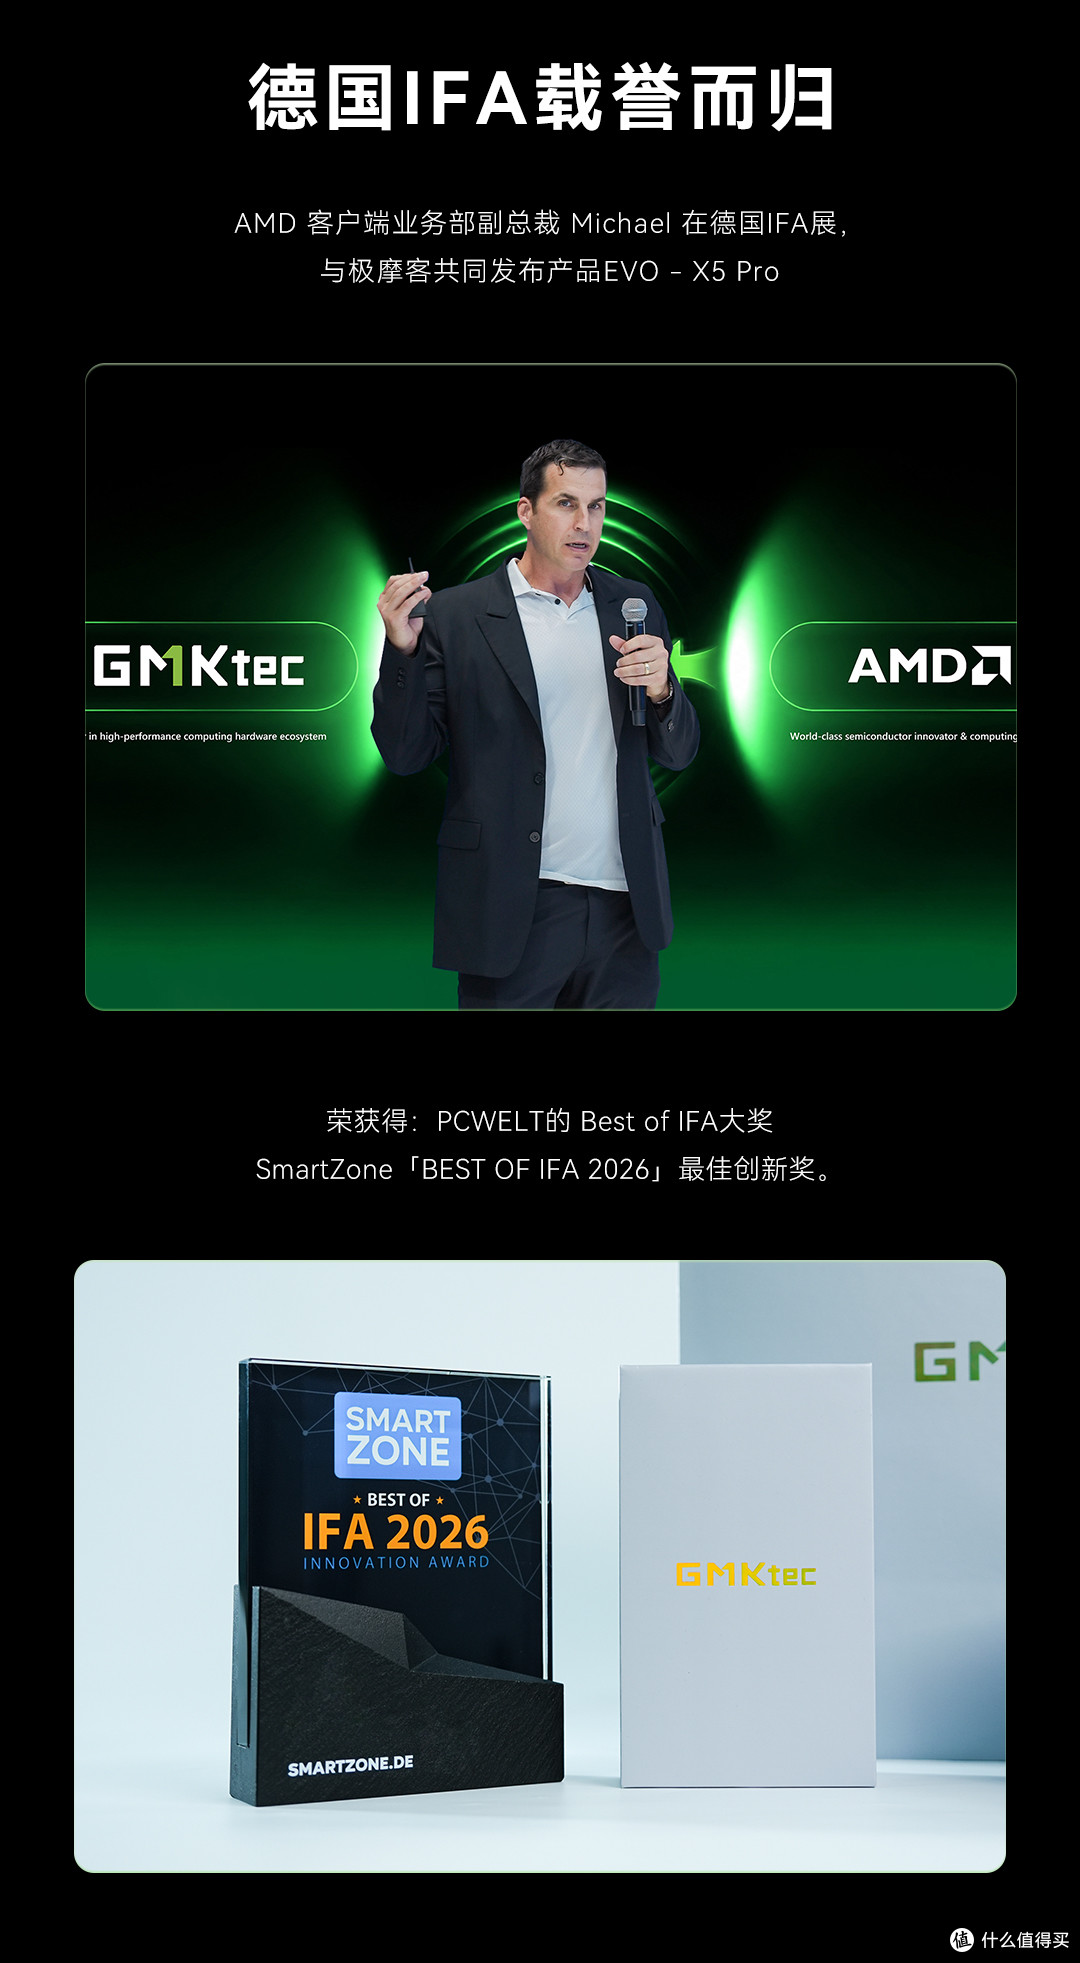
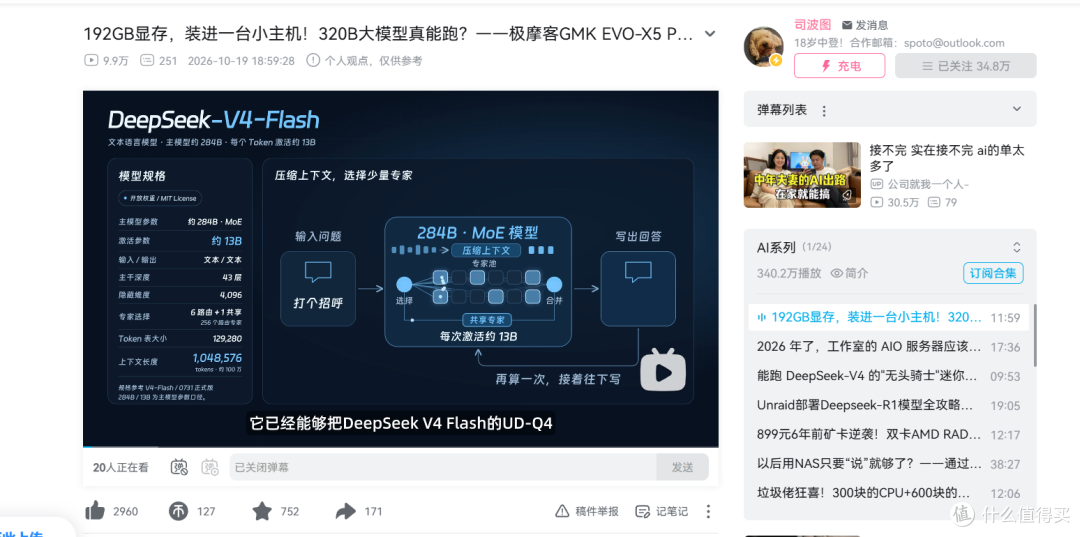
**深圳,2026年10月26日** —— 迷你主机品牌极摩客(GMKtec)旗下第五代桌面 AI 超算中心商用旗舰 EVO-X5 Pro,近日迎来全网首发深度评测。B站科技区头部UP主司波图于10月19日发布实测视频《192GB显存,装进一台小主机!320B大模型真能跑?》,全网首发深度评测逐项验证官方宣传:DeepSeek V4 Flash 全层加载 GPU、Qwen3.8 Flash Next 百万 token 上下文依旧 60 token/s、KV 池扩至 395 平台三倍,桌面级 AI 算力节点进入"日常可用"阶段。
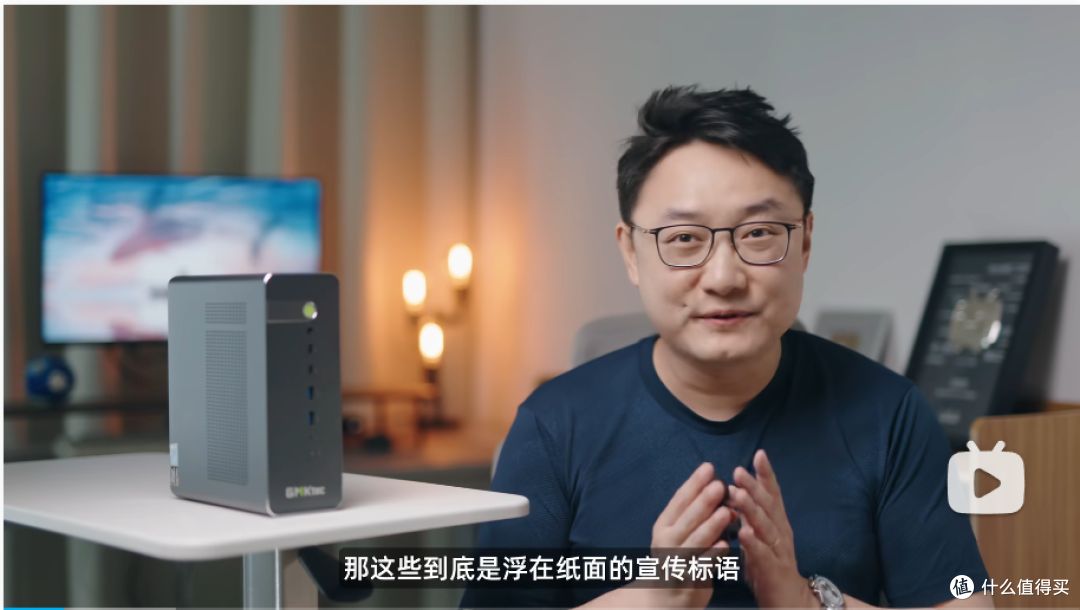
一周内播放量接近十万、评论超过三百条,评论区涌入大量关于本地大模型部署的技术讨论。评测以实机数据逐项验证了这款产品的核心宣传——搭载 AMD 锐龙 AI Max+ PRO 495 处理器与 192GB LPDDR5X 统一内存,本地离线运行 320B 参数级大模型,到底是"浮在纸面的宣传标语还是真正能用"。
一、开场悬念:内存比硬盘还大
"192GB 统一内存。是的,它的内存可能比你的硬盘还大。"司波图在视频开头用这句话设置悬念,并提前抛出三个预告级结论:其一,这台极摩客 EVO-X5 已经能把 DeepSeek V4 Flash 的 UD-Q4 模型全层加载到 GPU,"让你在家也能拥有一条私人大肥鱼";其二,320B 参数的 GLM-5.3-Flash 也能在这台机器上完成本地问答;其三,更实用的用法来自接近 1800 亿参 Qwen3.8 Flash Next——换到 192GB 的 X5 后,使用特定引擎能把 KV 池开到约 300 万 token,是 395 平台的三倍,且在百万 token 上下文里,全程吐字速度仍然约每秒 60 个 token。这三个结论是否成立,构成了本期评测的全部验证任务。
二、外观、结构与拆解:逐项细节
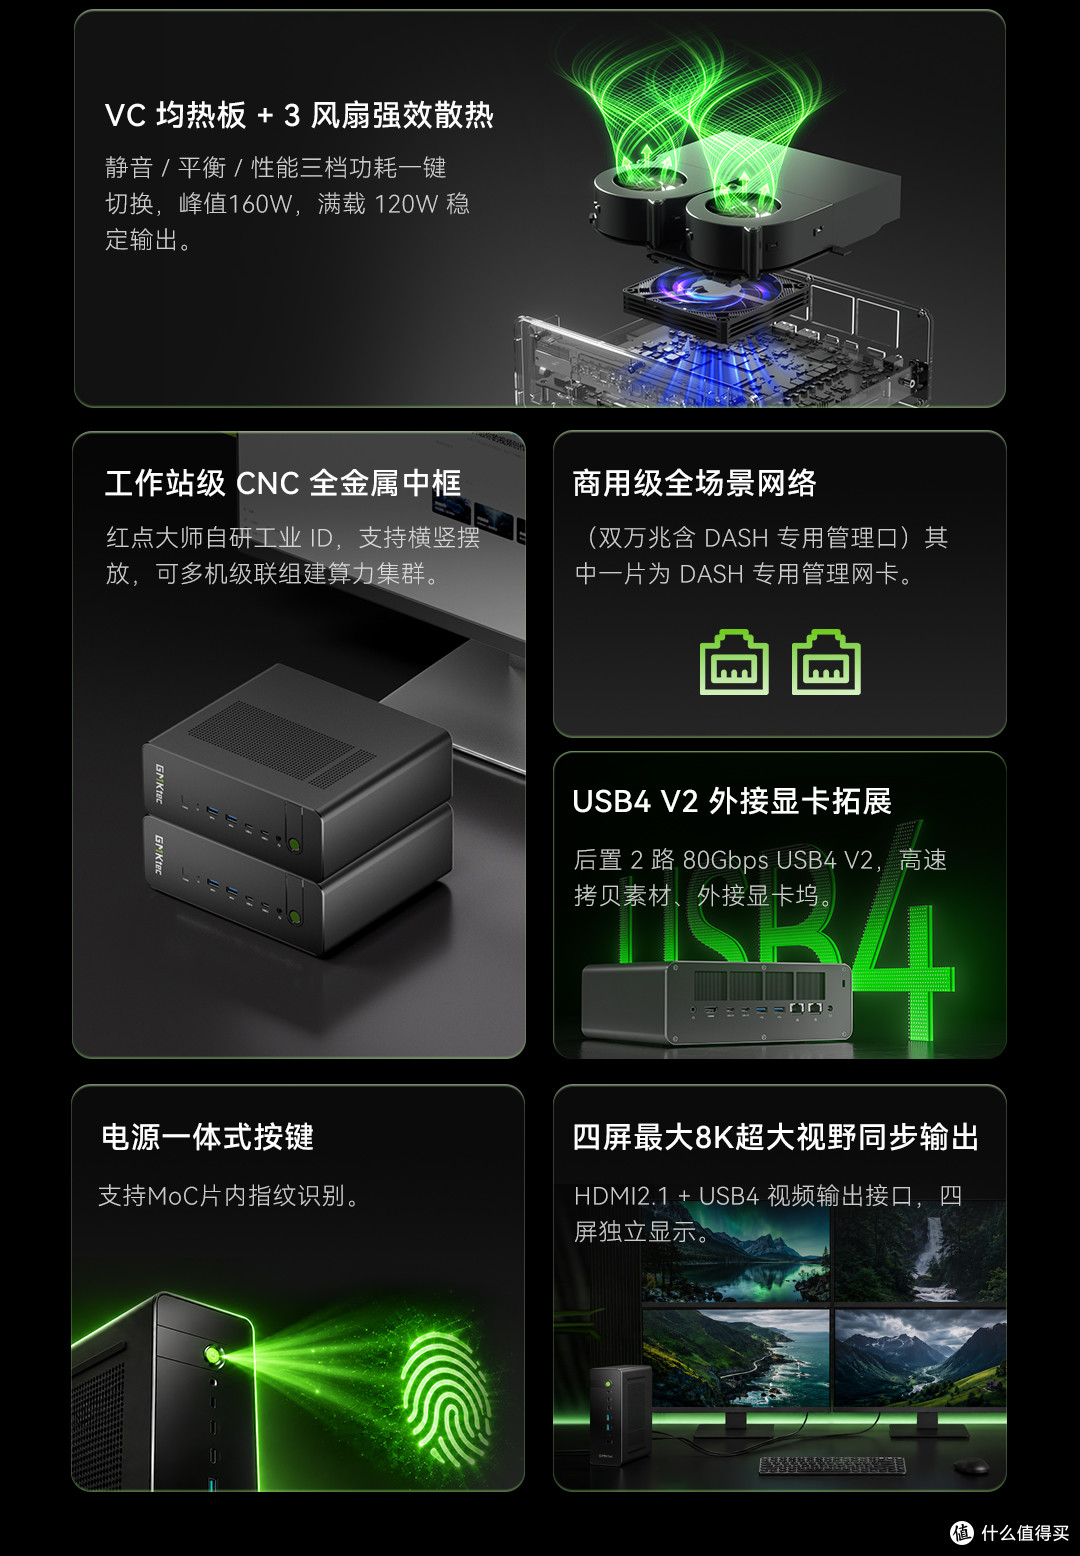
与之前扁平、铺得比较开的 X3 相比,X5 回到了更常见的小主机造型,上下宽面均设有较为充裕的散热开孔。整机外壳使用一体成型的铝合金中框,前后面板则为塑料材质。正面那颗绿色电源键集成了指纹解锁,日常使用更加方便。机器在纵向和横向的底部都设有橡胶软垫:横着放,可以摆在显示器下方;竖起来则更省桌面位置。整机体积只有约 3.4 升,裸机重量约 2.5 公斤。
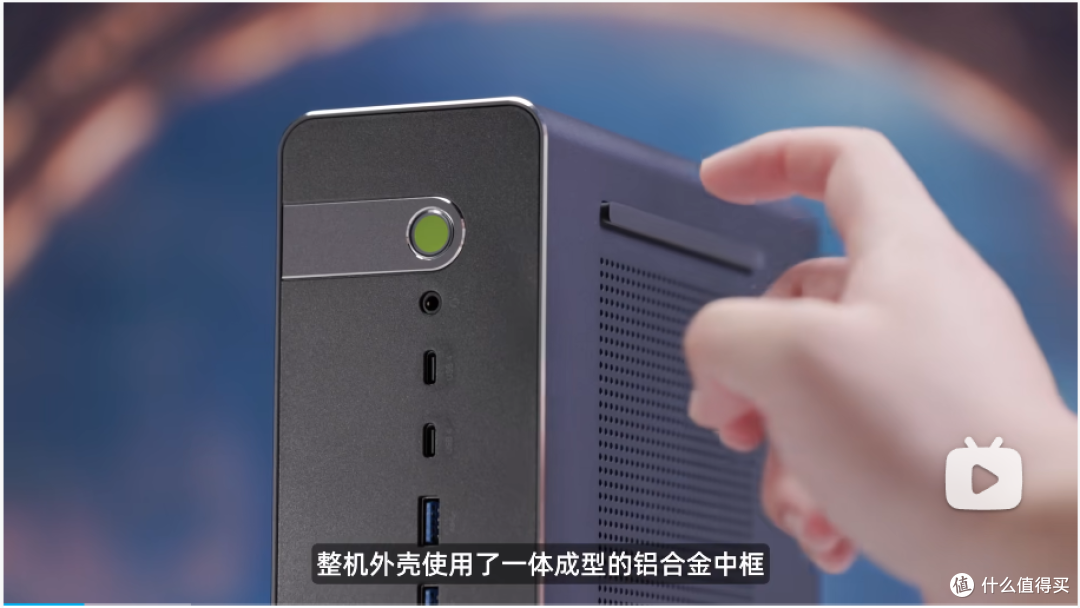
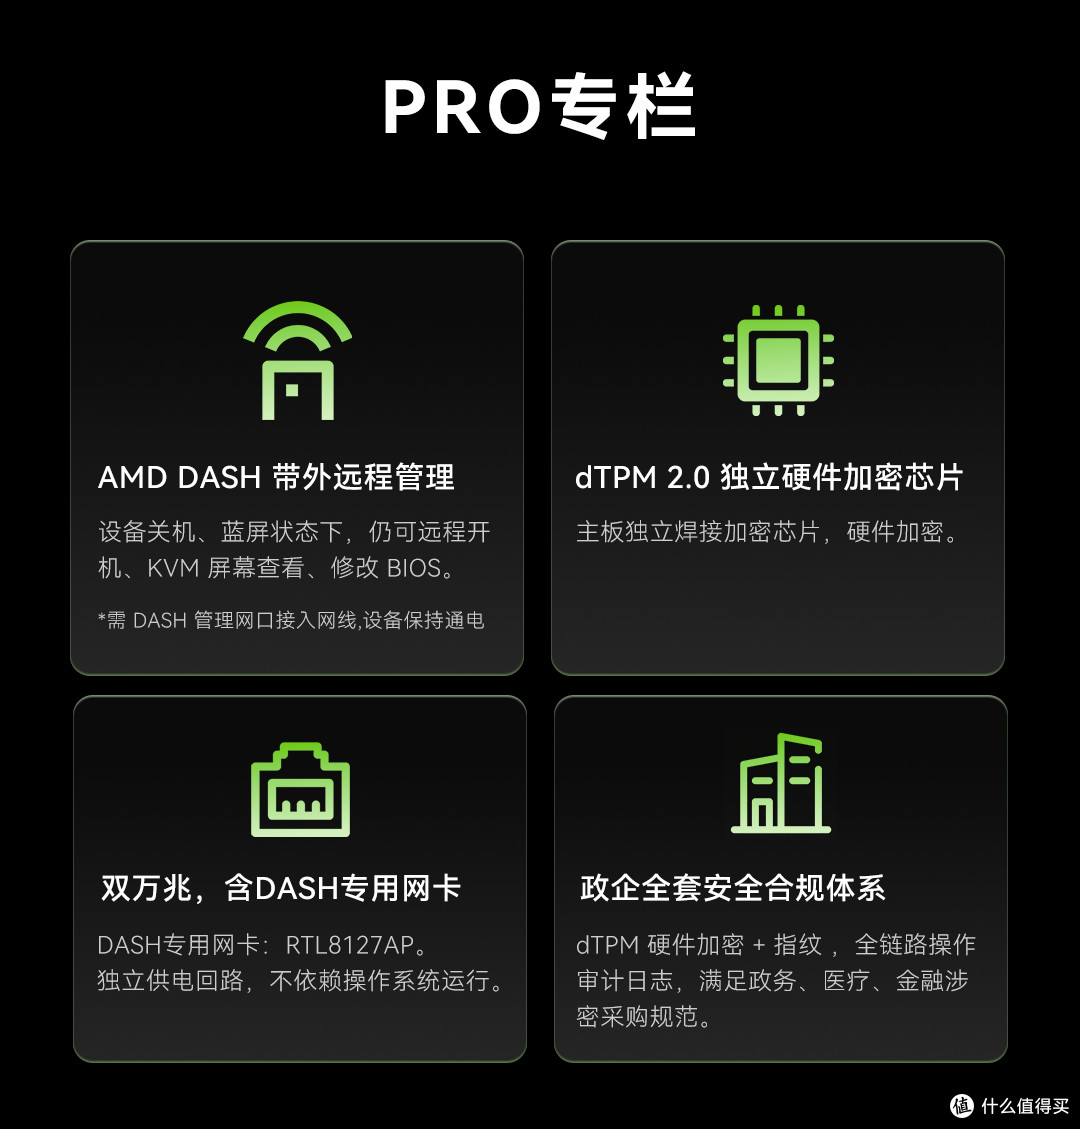
接口配置上,机器前置两个 USB-A、两个 USB-C 和耳机接口;背面给了双万兆网口——模型和素材放在 NAS 上,拷到本机更方便;同时还有双 USB4 v2,可以连接高速外设,网上还出现了魔改实现双机 RDMA 互联的方案。尾部是大面积通风孔。
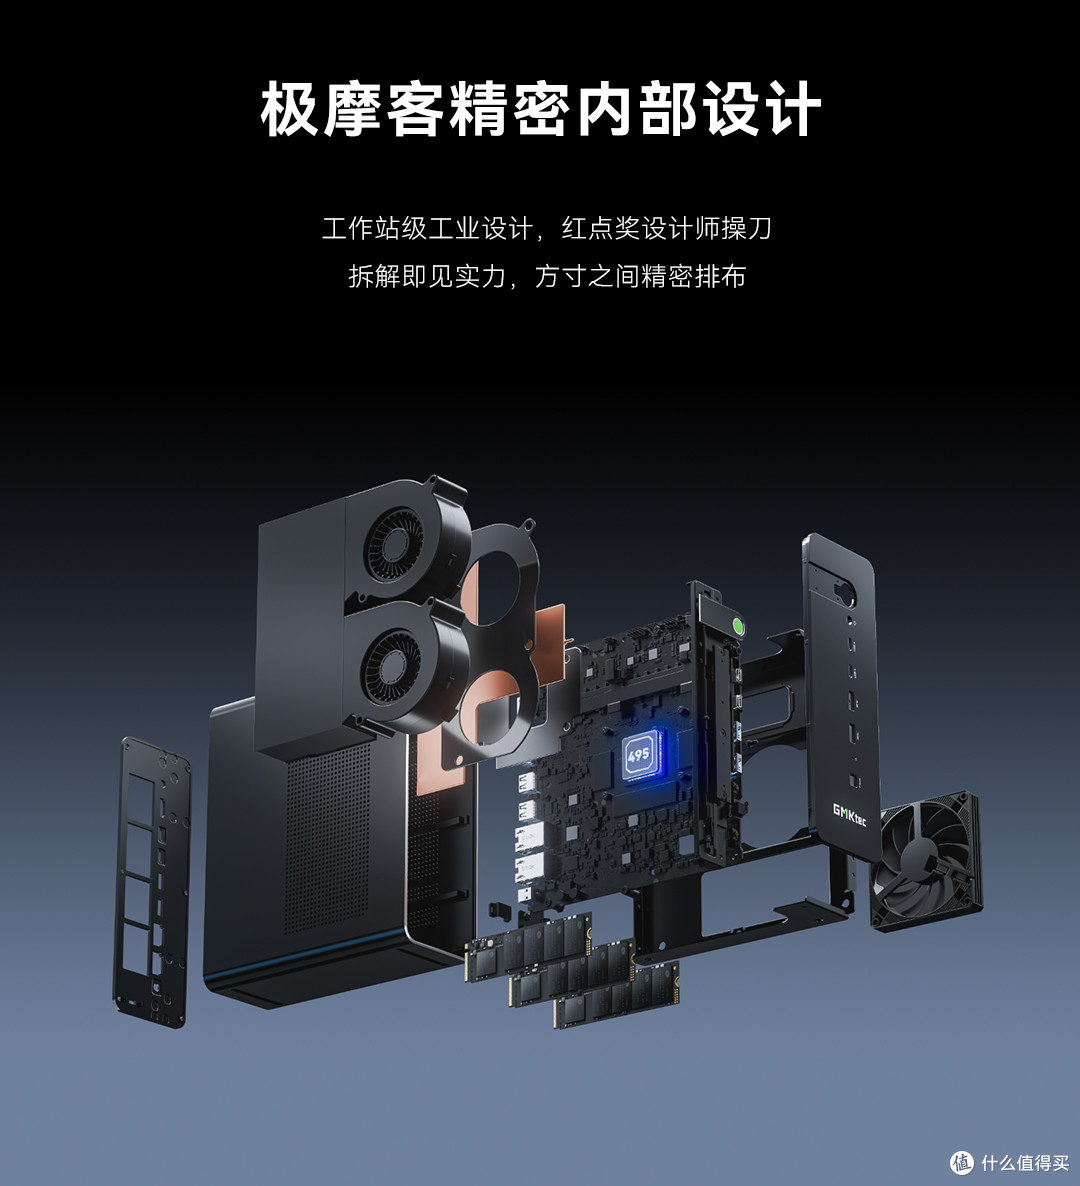
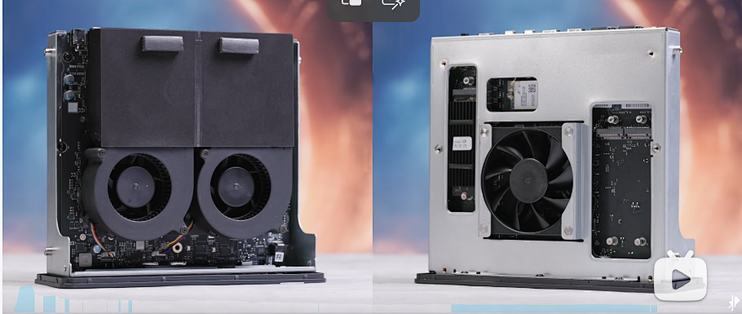
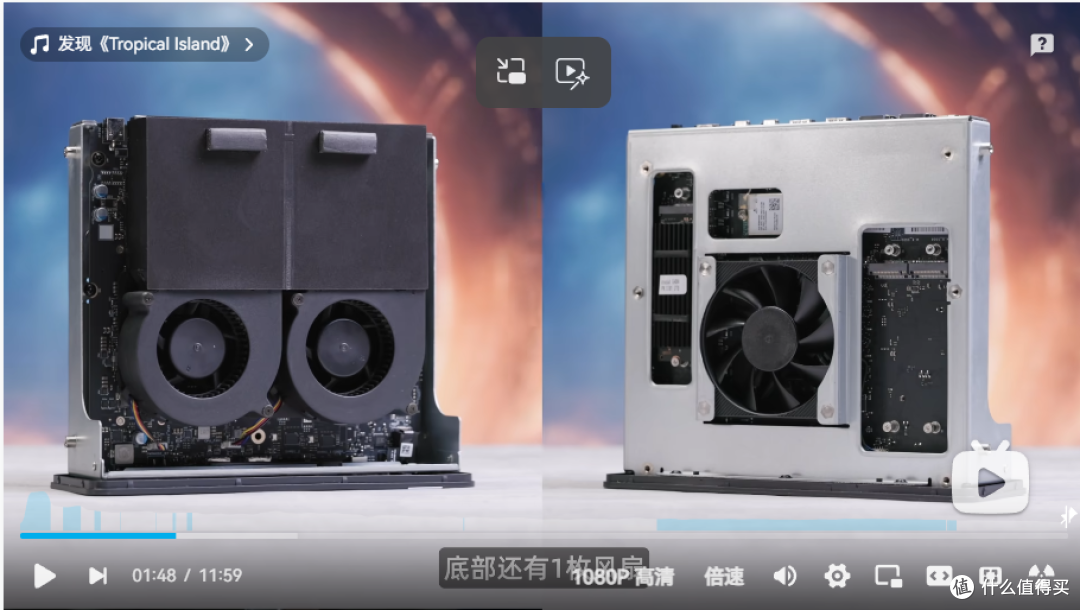
拆解也不复杂:卸下背部盖板,再取下固定内胆的贴片,就能把主板从前方抽出来。处理器上方是双涡轮散热器,覆盖超过 80% 的主板面积;底部还有一枚风扇;三条 M.2 插槽也都在这一面.
三、平台账面:从 Strix Halo 到 Gorgon Halo
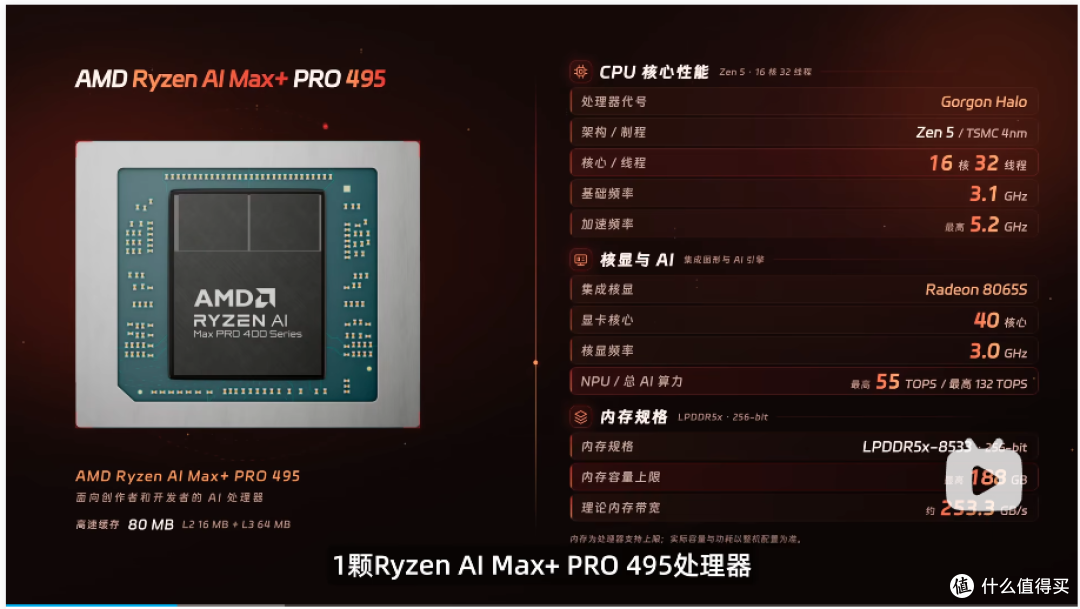
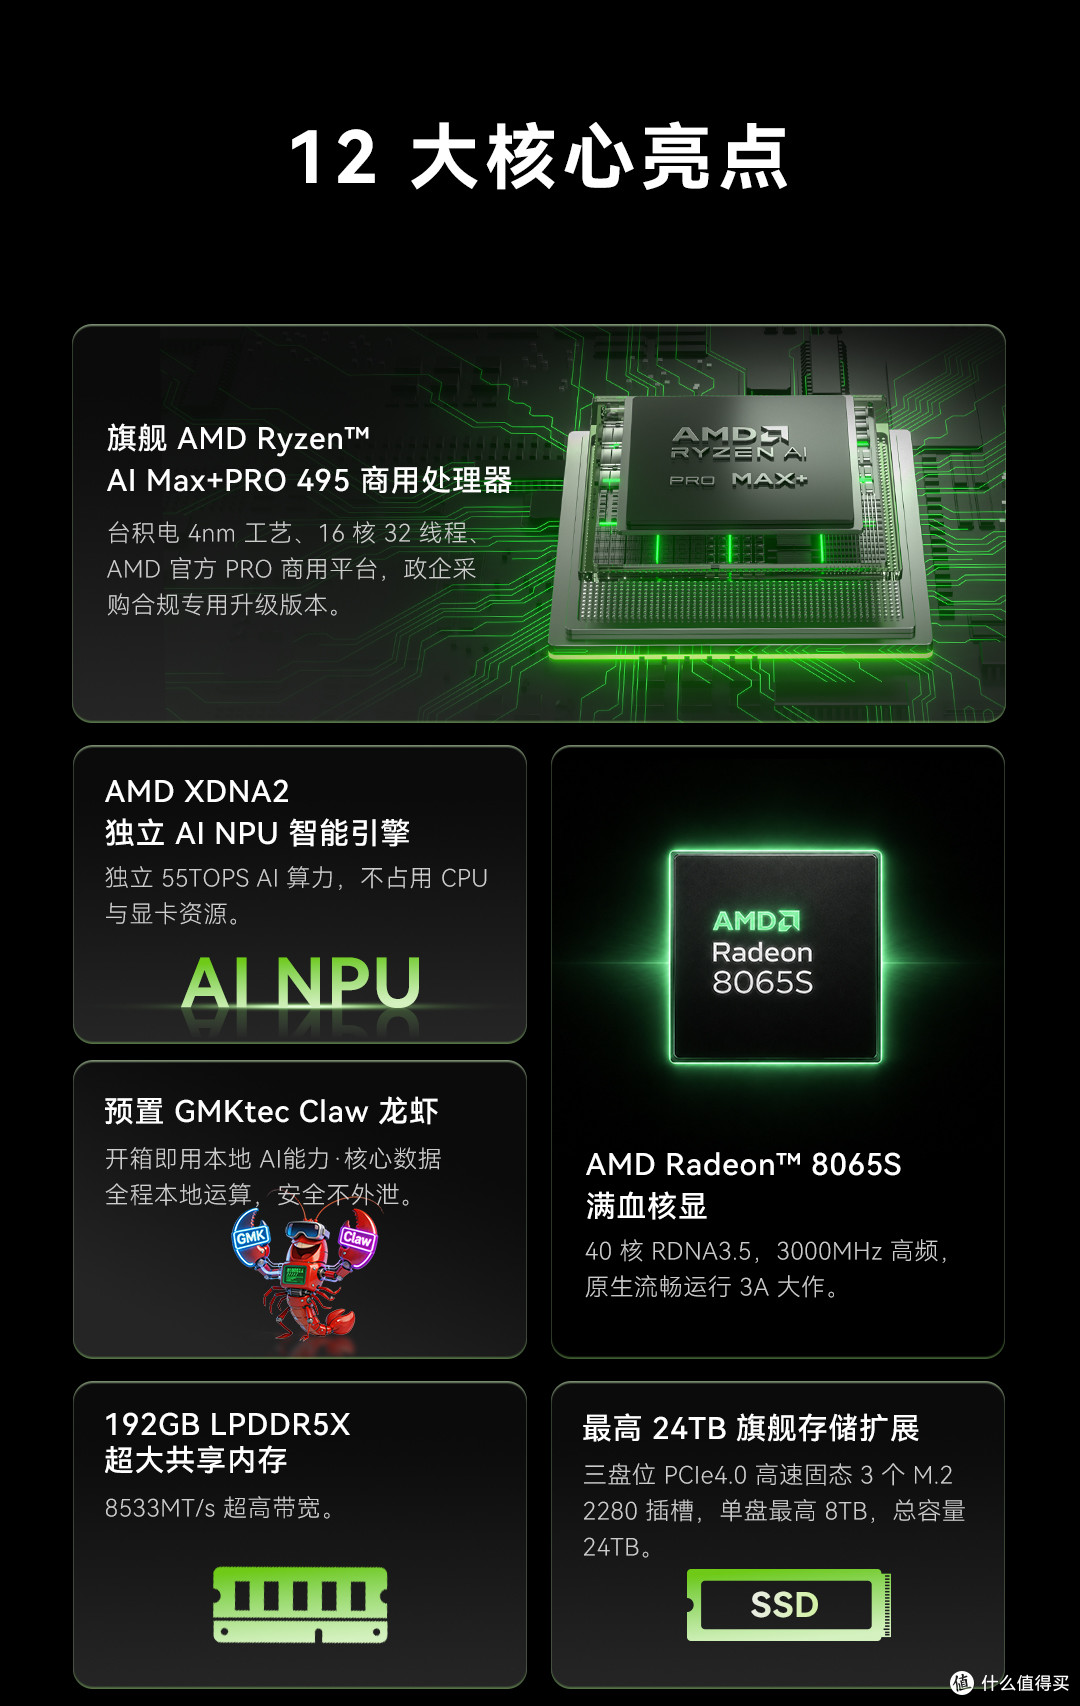
X5 搭载的是 Ryzen AI Max+ PRO 495,平台代号从 Strix Halo 变成了 Gorgon Halo。CPU 依然是 16 个 Zen5 核心、32 线程;相比上一代 395,基础频率从 3.0GHz 提到 3.1GHz,最高加速频率从 5.1GHz 提到 5.2GHz,各增加 100MHz。核显从 8060S 换成 8065S,仍然是 40 个计算单元,频率从 2.9GHz 提到 3.0GHz;NPU 则从 50 提到 55TOPS;内存速率从 8000MT/s 提到 8533MT/s,标称带宽从 256GB/s 提到 273GB/s——增加幅度并不算大。
四、持续性能释放:154W 冲高、120W 稳定、三轮不掉分
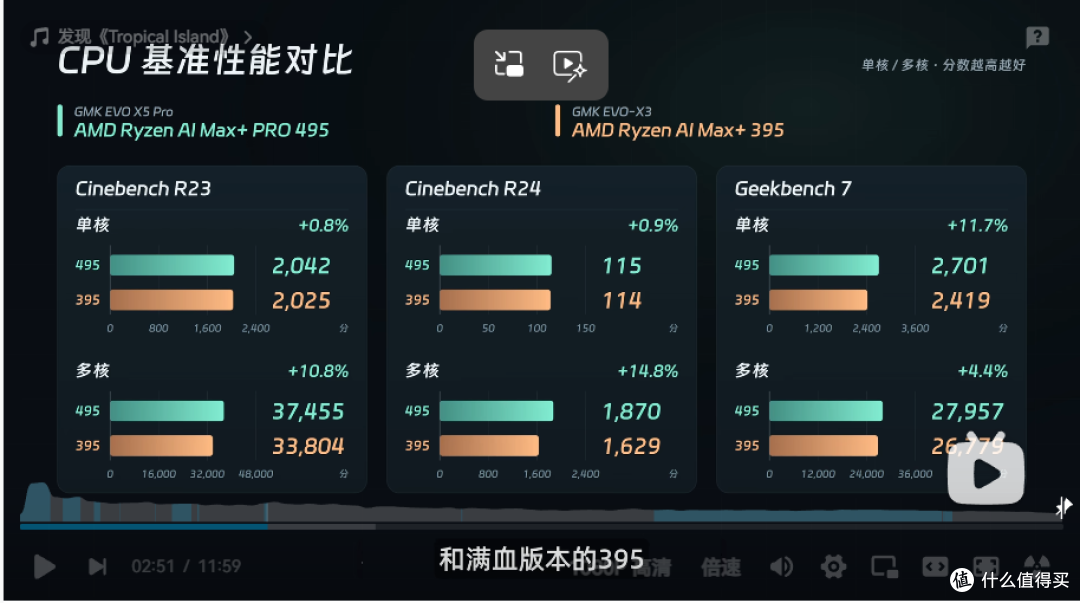
在 CPU-Z 压力测试里,封装功耗一开始最高冲到约 154W,随后稳定在 120W;温度来到 97–98℃ 时,有效频率仍然维持在约 4.49GHz。更能说明问题的是稳定性:进入这个压力平台后,立刻连跑三轮 CPU-Z,与此前的冷机成绩相比,多核相差约 1%–3%,没有出现持续掉分。司波图评价:"能在这么小的一台机器里满负荷 120W 运行,释放很激进,但能稳住也不容易,而且主观听感不算吵,适合放在房间提供算力服务。"其它几项 CPU 测试的成绩汇总在视频图表中——GMK-X5 的处理器性能和满血版 395 基本处在同一水平;16 核 32 线程,放在小主机里依然是旗舰配置。
五、核显生成与本地大模型基准:提升在哪里、瓶颈在哪里
在 ComfyUI 通用引擎的图片、视频生成测试里,495 的提升不再只是频率上的小幅变化:SDXL、Krea2、Z-Image 的热跑耗时比 395 快约 7%–13%;MiniMax H3 使用 SLA 最优配置后快约 8%;更大的 Qwen-Image 2512 完整热跑和 LTX 2.3 首段采样,则能到约 2.2 倍。同一批官方工作流的耗时对比放在视频图表中。
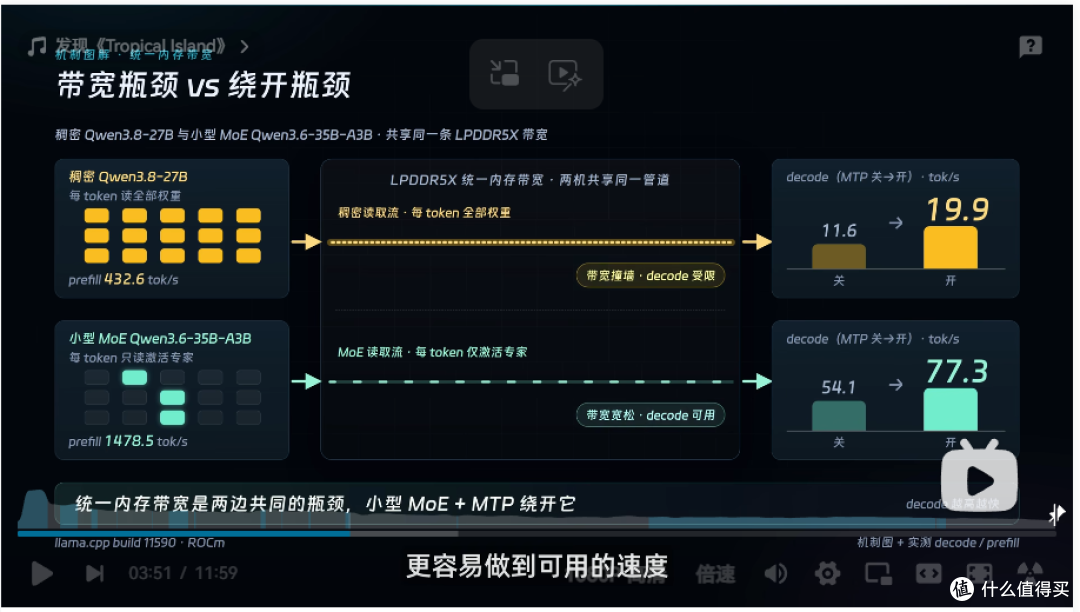
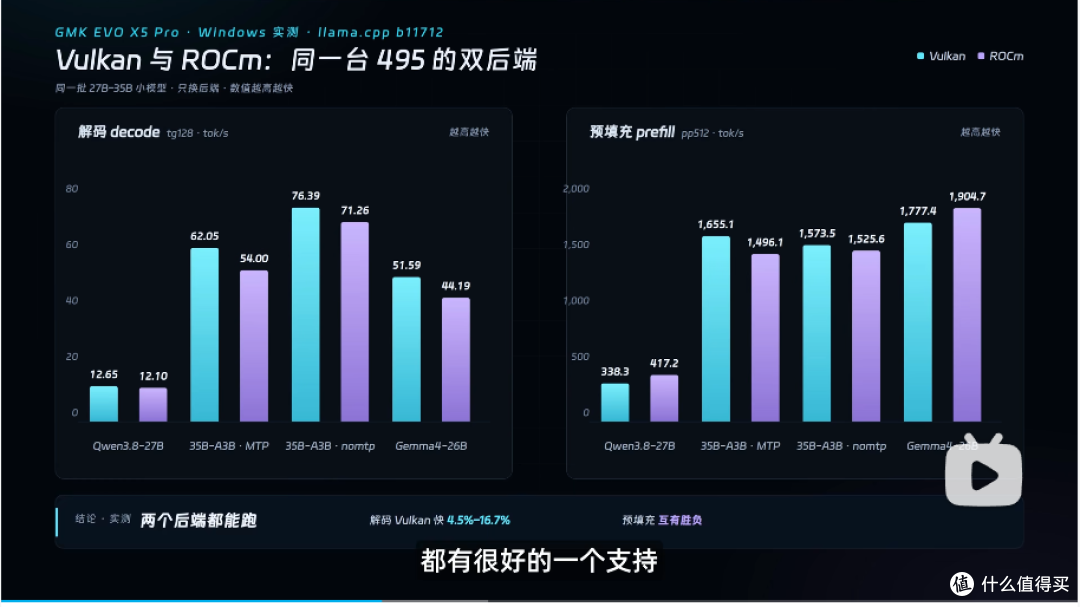
本地大模型方面,同批 llama.cpp 测试里,495 的输入处理比 395 快约 1% 到 16%,解码速度基本持平——两边主要还是卡在内存带宽上。整体稠密模型仍然受内存带宽限制,小型 MoE 模型配上 MTP 投机解码更容易做到可用速度;而更大的统一内存,主要能给模型权重和 KV 缓存留出更多空间。
六、Windows 生态:能用、好用、普通用户友好
和之前的 Strix Halo 一样,495 仍然是 x86 平台,可以直接使用 Windows。你可以把它当成一台普通 PC,同时在本机跑模型、生成图片和视频,日常使用不需要先换一套操作系统。值得一提的是,Windows 下 495 对 Vulkan 和自家的 ROCm 都有较好的支持,在通用 AI 工作流里和 Linux 下的性能差距并不大,用户不需要担心只有 Linux 才能发挥完整性能。
软件方面,牧马人、LM Studio 这类工具提供了图形界面,ComfyUI 也有适配 AMD 平台的桌面运行方案:选好对应版本和后端,安装、配置完成后就能用,入门门槛比从头搭环境低不少。游戏也可以通过 Steam 安装,这颗核显有兼顾 2K 游戏的能力。司波图总结:"总的来说,这一系列平台在 Windows 下能用、也好用,对普通用户比较友好,这是它的一大优势。"
七、玩法一:DeepSeek V4 Flash——155GB 权重,44 层全部进 GPU
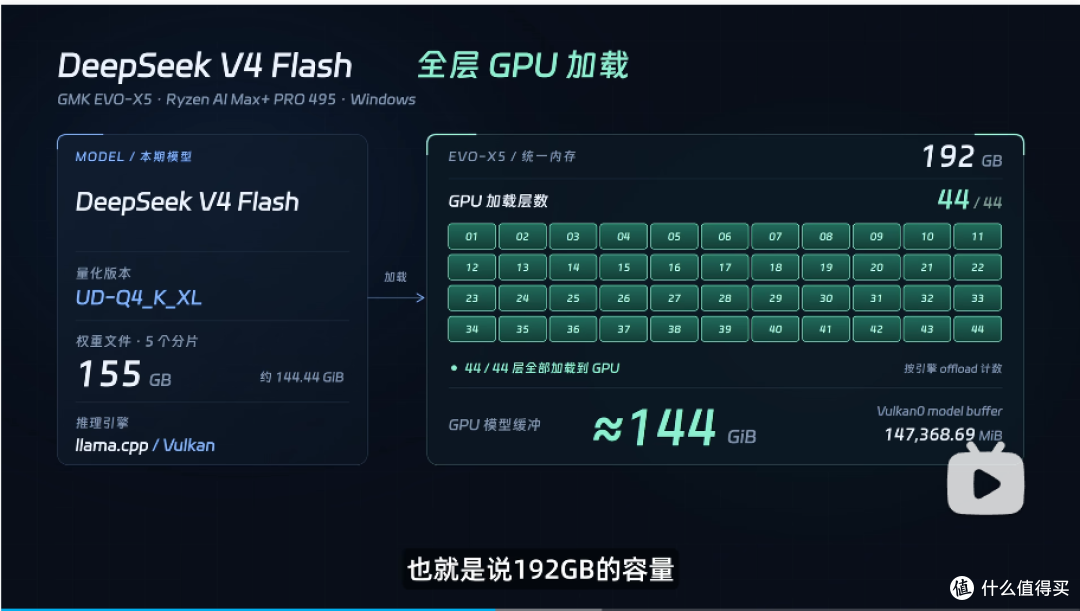
评测先看官方宣传的离线模型规模上限 320B。实测在 Windows 下跑通了 DeepSeek V4 Flash 和 GLM-5.3-Flash 两个模型。
先看 DeepSeek V4 Flash。这一轮用的是相对高规格的 UD-Q4_K_XL 版本,权重文件约 155GB,推理用 llama.cpp 的 Vulkan 后端。日志显示 44 层全部加载到 GPU,GPU 模型缓冲区约占 144GiB——192GB 的容量在这里有了直接用途。284B 总参数,一条放在家里的"私人大肥鱼"。
能力验证环节,评测团队让它审阅这份评测脚本,同时测了结构化输出、简单 Python 代码和工具选择:所测的 JSON、代码用例和工具参数都能完成,逻辑题最终答案也是对的。
速度方面,短提示下它的吐字速度大约每秒 16 到 17 个 token。第一次把 10K 左右的提示词交给它,冷读速度约每秒 109 个 token,开始响应要等 97 秒多,等待还是比较明显。好在读完以后,继续追问就轻松多了:第二、三轮只新算 27 和 31 个 token,开始响应都只需要约 1 秒,而且三个问题的答案也都正确。视频画面保留了原速过程,观众可以直接感受冷读和追问的差别。总的结论是:如果是日常对话,Prefill 性能并不会让你感到太大的障碍;只是如果需要大量注入或调用工具之类的场景,等待的时间就会比较久。
同一个 Q4 模型上,评测还只切换 DSpark 投机解码做了对照:关闭思考时,开关两边基本没差别;开启思考后,吐字速度从每秒 16.5 提到 21 个 token,提升约 27%。所以它并不是打开就必然加速——内容越容易预测,收益越明显。
八、玩法二:GLM-5.3-Flash——320B 参数,"将将够用"的 15 token/s
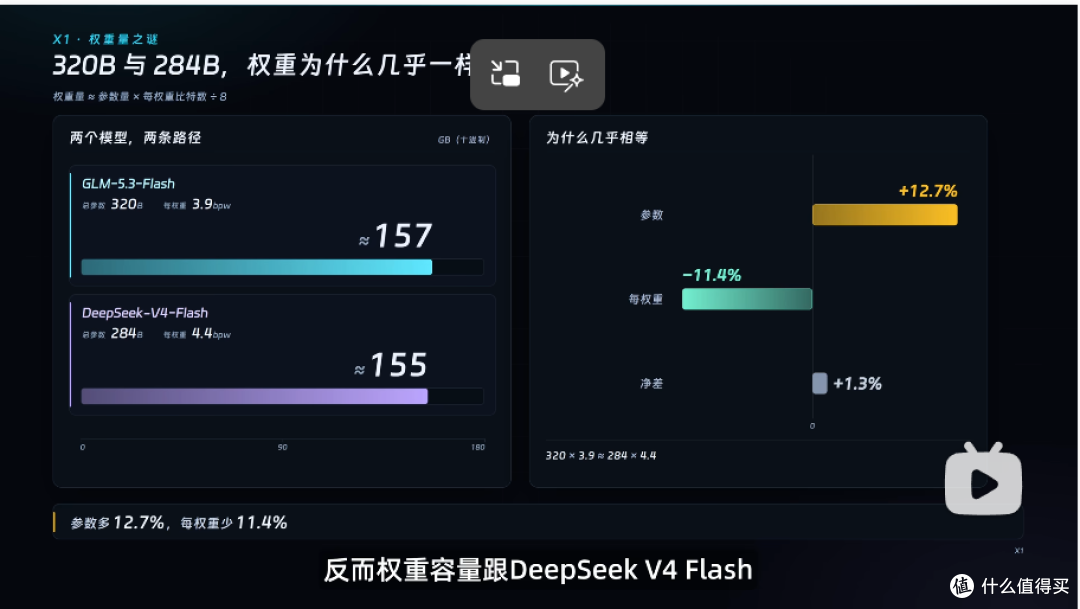
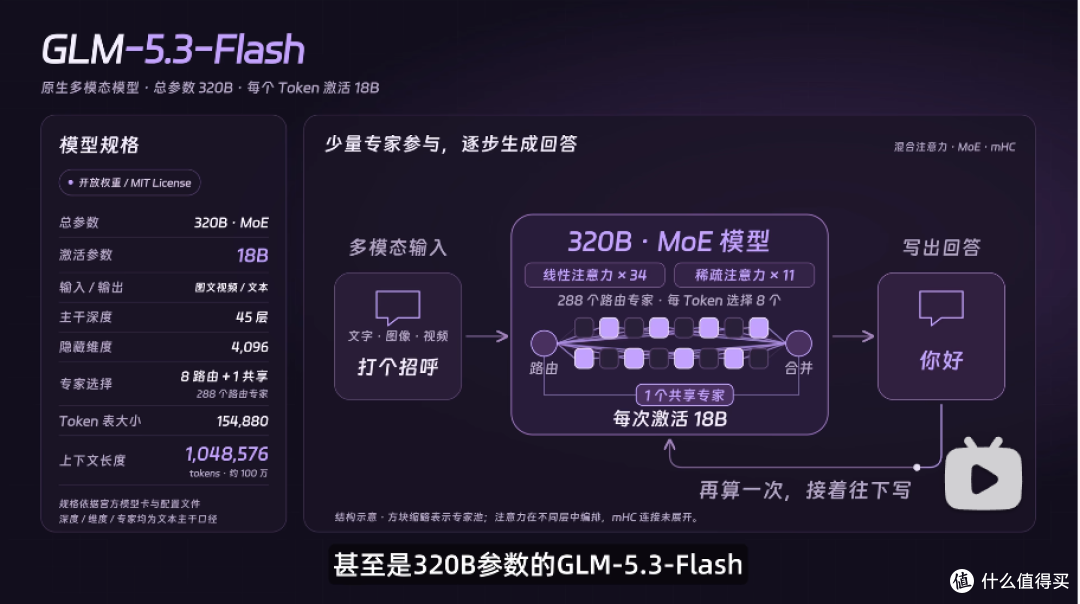
GLM-5.3-Flash 是 GLM 目前主力的开源高速模型,参数量为 320B。由于这次用的是 iQ4-XS 量化版本,权重容量反而跟 DeepSeek V4 Flash 几乎一致。加载后短输出约每秒 15 个 token,速度"将将够用"。当然,如果接受慢一点的速度,生成效果并不只是"能跑":评测让 DeepSeek 和 GLM 用同一句提示词,各自从零生成三版"鹈鹕骑单车"HTML 动画,六版全部在浏览器里完整跑通,视频中各挑选一版展示效果。
九、关键提醒:Windows 下的 176GB 与 Linux 建议
评测中特意补充了一个重要细节:在 Windows 下,系统对统一内存的管理较为严格,必须预留足够的容量给系统,跑模型实际能够使用的统一内存容量为 176G,这也会导致留给上下文的容量变少。所以要跑这类"贴着极限"的模型,最好还是使用 Linux 系统,最终整体性能也会更好。评测团队专门制作了一份 Windows 与 Linux 的对比图表放在视频中,供观众自行了解。
十、玩法三(重点):Qwen3.8 Flash Next——Agent 主模型的日常体验
真正打算日常高强度使用,甚至拿来作为 OpenClaw 这类 AI Agent 的主模型,评测的重点放在了 Qwen3.8 Flash Next 方案上——Agent 每一轮都要处理对话历史和工具返回,输入处理速度、吐字速度和长上下文能力,都会直接影响它干活的体验。
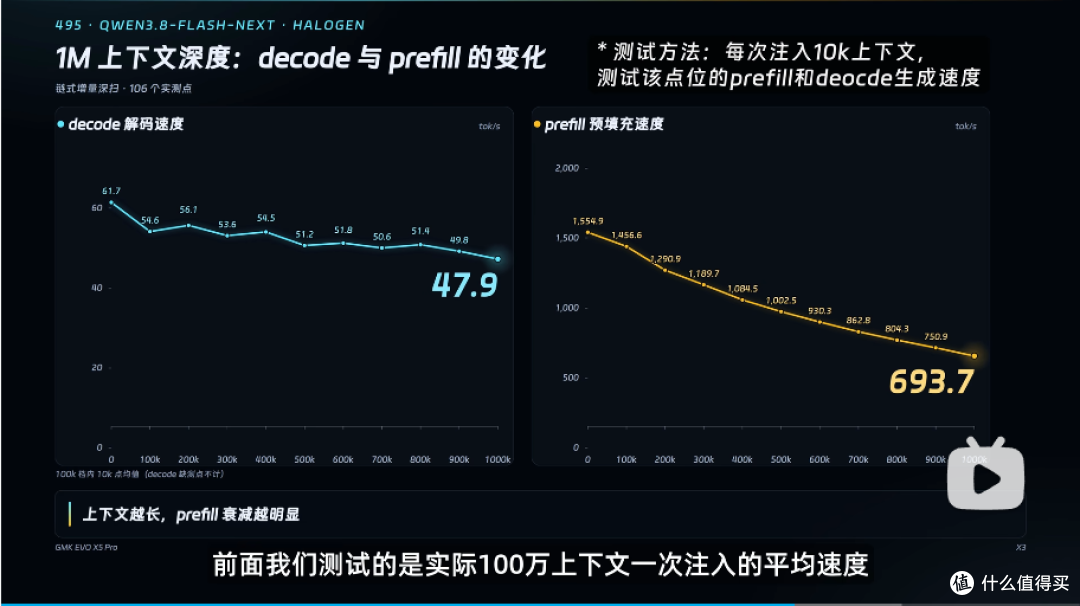
这个接近 180B 参数的模型,评测团队前段时间已经在 395、128GB 的 X3 上部署过;这次把同一套 Halogen 引擎搬到了 192GB 的 495 上。对照数据:395 的十类短提示平均吐字约每秒 59 个 token;495 在同引擎深度扫描里,8K 到 32K 上下文的吐字速度约每秒 66 到 69 个 token。
输入长度拉到百万 token 级,495 的代码和长文两个测点,吐字速度仍有每秒 60 到 62 个 token;输入处理约每秒 1318 到 1351 个 token。和 395 的百万级成绩相比,输入处理快约 9%,吐字快约 12% 到 15%。
不过,第一次把资料交给它,还是要等模型读完:8K 到 260K 的测点,495 的 prefill 大约每秒 1600 到 1900 个 token——这个性能对 180B 量级的模型来说已经非常够用,算上缓存,即便用在 AI Agent 上,每轮也都有很好的响应。评测团队自己也经常让它挂载 DeepSeek harness 完成一些长程任务。
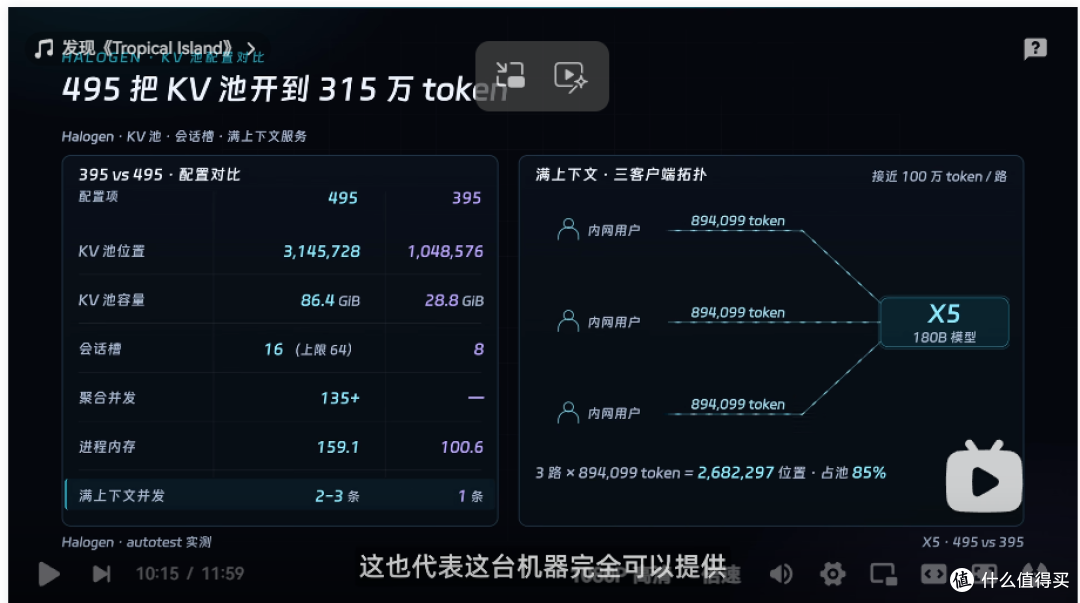
在 Halogen 中,495 能把 KV 池开到约 315 万个 token 位置,占约 86.4GiB,是 395 的三倍;默认配 16 个会话槽,聚合吞吐会在约 135 token/s 饱和。放到满上下文场景,395 只能容纳一条接近百万 token 的请求,495 的池子能接纳三条——这也代表这台机器完全可以提供三个内网相对完整的 180B 模型服务,同时输入请求解码速度还能达到每秒 30 到 40 个 token。
十一、192GB 的另一重价值:按任务重新分配内存预算
除了单个模型能装多大,192GB 还适合让几套服务待命,但要先把内存预算算清。评测给出的示例方案:比如划 128GB 给 Qwen3.8 Flash Next 负责写代码、整理资料做主模型,Holo4 35B-A3B 这类 Computer Use 模型负责看屏幕和操作桌面;也可以让主模型常驻,同时给 ComfyUI 留一份内存。128GB 不是绝对做不了,只是余量更紧;192GB 的优势,是可以按任务重新分配,而不是所有服务永远同时满载。
十二、UP主总结:三句话定调,集群评测预告
司波图在片尾总结:从硬件设计来看,极摩客 EVO-X5 在这么小的尺寸里实现了稳定的 120W 功耗释放,做工也有不小的提升,"我认为可以点个赞";而新的 495 处理器把统一内存拉到了 192GB 的容量,让玩法得到了很大的扩展——能在单机实现 GPU 完全加载 GLM 和 DeepSeek V4 这个量级的模型,且实现流畅日常对话,"这个相当厉害"。他个人认为真正有价值的,是这台机器能够在本地跑可供 3 人满血使用的 Qwen3.8 Flash Next——无论是解码、预填充、并发还是总的 KV 池,都达到了一个非常好的平衡,"这也让它在企业应用中达到了使用水平"。
此外,官方还提到有 5 机、20 机的集群玩法,本期评测尚未尝试,UP主预告"未来再给大家介绍",并感谢观众对高强度测试工作的支持。
结语:迷你主机的新霸主
过去衡量一台迷你主机,看的是 CPU 跑分和游戏帧数;而 EVO-X5 Pro 给出的新量纲是:能装下多大的模型、能同时服务多少人、上下文能有多长。当 192GB 统一内存把这些问题全部拉到"日常可用"的区间,桌面级 AI 算力节点这个品类,正在接受市场与用户的双重验证。作为商用本地算力,可以的选择