9月20日千问把 Qwen-Image-2.1 开源之后的半个月里,本地党圈子里同时流传着两句话:
一句来自9月20日的"全网首发"教程——6G显存就能玩,评论区250多条都在抄配置。 另一句来自9月26日一条配电脑建议——做本地AIGC生图生视频,内存64G起、显存48G起,“一年以后你一定会感谢我”。哔哩哔哩小红书
同一个模型。还是那个你熟到不能再熟的路子:标题带"开源第一",装机就翻车。但这次有点不一样——这个模型只有7B,比你日常在跑的那个27B还小得多。它到底要多少卡,两拨人还都说得言之凿凿。
先给结论:都没说谎,只是他们说的不是同一件事。这张开源图模型,社区30天里测出了四道完全不同的水位线。今天这篇不教装机——把30天里15组真实跑出来的数字摆进一张表,你对号入座,先看清楚自己要站哪条线,再决定这张卡值不值得为它动。
一、先把显存这本账重算一遍:图模型不按参数量收钱
你跑文本模型养成的直觉是:显存≈参数×精度,27B就是27G那档的事。这套算法到图模型这儿直接作废,因为它吃显存的是三样别的东西:
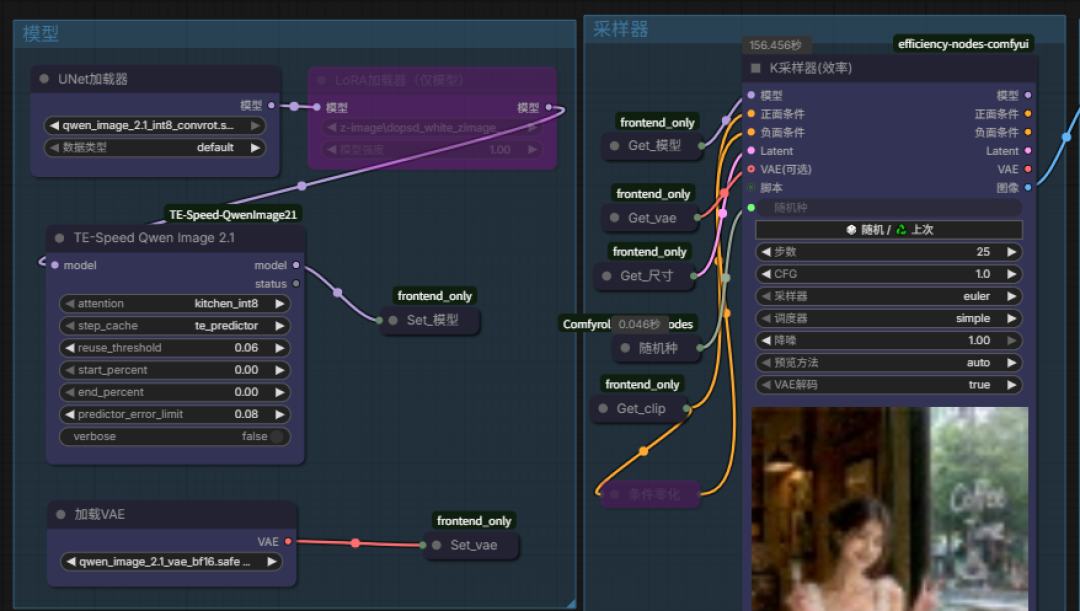
第一,参数只是门票。7B的视觉主体不大,真正麻烦的是它旁边还挂着文本编码器和VAE。8G党能进门,靠的是int8版本+文本编码器nvfp4量化这一套组合拳——这是9月21日凌君通义那条511评论实测视频给的抄作业方案,原话是"配置要点直接抄:显存8G选int8版本,文本编码器用nvfp4"。 今天还有人提醒:8G卡装完模型,实际能用的就6.3G左右,按标称8G做规划,十个人九个要重算。哔哩哔哩小红书
第二,像素才是变量。同一条卡,出720p和出1.3M像素不是一回事。社区实测摆出来:3080跑一张720p,20秒;5060笔记本跑1024,半分钟;4060笔记本硬扛1M像素原生int8,35秒一张——是同期Z-Image的三倍时长。 图越大,时间越长、显存越紧,参数量倒没变。哔哩哔哩

第三,offload把账单从显卡挪到了内存。8G显存党最狠的一个实测:4060笔记本8G显存+32G内存,模型加载后系统内存占用30GB。 小红书那帖被收藏286次的"Unsloth把部署门槛打下来",走的就是FP8 offload这条路——门是开了,代价是别怪内存和SSD跟着挨累。 做视频模型的同理,有玩家提醒:16G显存以下跑大生成模型,虚拟内存会显著吃掉SSD寿命,偏偏硬盘最近也不便宜。哔哩哔哩小红书哔哩哔哩
二、15组社区实测,全摆进一张表
以下每一条都来自B站/小红书公开实测和评论区作业(时间从9月20日到10月6日),我只是搬运和排版:
# | 你的设备 | 跑的什么事 | 实测结果 |
|---|---|---|---|
1 | 6G N卡 | 文生图 | 全网首发,可玩(9/20教程,468赞) |
2 | 8G N卡 | 文生图 | int8+nvfp4编码器,跑得动(9/21凌君通义实测,2353赞) |
3 | 8G+16G内存 | 文生图/图生图 | ComfyUI low模式:文生图2分钟,图生图3分钟(评论区7赞作业) |
4 | RTX 3080 | 720p出图 | 20秒/张(48赞) |
5 | 5060笔记本 | 1024出图 | 30秒/张(43赞) |
6 | 4060笔记本(8G) | 1M像素出图 | 35秒/张,约为Z-Image三倍时长(5赞) |
7 | 4060+32G内存 | 加载后占用 | 系统内存约30GB,显存实际可用仅约6.3G(10/6提醒帖) |
8 | RTX 2070 | 批量出图 | 2分钟一张,“批量工作流还是太慢”(2赞) |
9 | Unsloth方案 | 低显存部署 | FP8 offload把门槛打下来(小红书,286收藏) |
10 | M6 Mac mini 16G | 文生图 | 一下午装通,开源文生图第一跑起来了(10/2) |
11 | M5 Pro 64G Mac | 离线生图 | MLX 4bit+mflux框架,透明底直出(9/25、9/27) |
12 | A卡/老卡/I卡 | 图生图 | 最低8G实测;10/4 sd.cpp Vulkan后端进ComfyUI,零编译"老卡延寿" |
13 | 24G显存 | ControlNet(姿态/Canny/深度) | 10/2才落地,此前这条线根本不存在 |
14 | 8G档 | 出图提速 | 社区加速LoRA已到v0.2五步版:多样性0.75→0.93、构图不漂;4步版偏移严重 |
15 | 8G档 | 练自己的LoRA | 10/6 H3系训练器放出,明说支持Qwen-Image-2.1、Krea2、Z-Image |
三、四道水位线:先看清你要站哪条
第一条,能跑(文生图):8G起步。 8G N卡走int8,A卡老卡走Vulkan延寿方案——10/4那条sd.cpp接进ComfyUI的更新,口号就是"零pip、零编译、零轮子"的老卡延寿计划。 Mac 16G统一内存走MLX:用mlx-community的4-bit量化模型配mflux推理框架,已经有人在16G的M6 Mac mini上一下午装通。 这是目前口碑最扎实的一条线——也是"48G起步"论调最站不住的地方:它把别人跑视频模型的预算,扣在了一张只出图的卡头上。哔哩哔哩小红书

第二条,能改(图生图/换装/抠图/透明底):同一张卡,时间翻倍,内存留足。 8G+16G出图2分钟、改图就要3分钟;想要系统内存不爆到30G,32G内存起步算舒适。这条线的真实需求方是电商小批量素材、四视图、海报文字——社区口碑恰恰集中在这:大头照生成全身图,拿Krea2、豆包、前代逐个对比,“完全看不出来差别”。 而原生透明底和10张参考输入,本来就是写进发布物料的卖点。 玩家实测里第一口碑就是"直接出透明底,放进PPT和视频不用抠图"。哔哩哔哩微博哔哩哔哩
第三条,能精修(ControlNet):24G。 姿态控制、边缘线稿这些,10月2日才落地——“QwenImage2.1终于有ControlNet了!24GB能跑,Pose/Canny/Depth全实测”,此前这条线根本不存在。 刚上车8G的别急,这条线本来就不在你预算里。哔哩哔哩
第四条,能练(自己的LoRA):门是开了,房里没人。 10/6已经有8G训练器,但新模型开源才30天,评论区的原话是"现成的LoRA很少,可能需要自己炼"。 画师风格党、IP定制党,现在进场等于交伙食费练工。哔哩哔哩
这张表上还压着两派没分出胜负的口碑,一起摆出来:吹的一侧,“一致性无敌"10赞、四视图"小脸不崩了"42赞、动漫转真人"好逼真”;砸的一侧,"这人脸没一个画好的"45赞,和"1.3M像素"晒图59赞直接对线。连实测UP自己都承认开头表述"能博眼球一点"是流量话术,“视觉生成部分只有7B”,问题片段也展示了。 翻译成人物画像:这波开源生图真正的卖点不是"更美",是"不跑位";真正的短板不是丑,是脸。 拿它出电商图和拿它出人像的,会得出两个相反的结论。哔哩哔哩
四、要不要为这张图卡动手:三本成本账
账不能只看显存,ZDM的读者得把钱算完再掏。
电费账。 评论区吵得最凶的一条,是21赞的"真心不推荐普通用户去跑本地模型"和37赞的反击"全功率运行一个小时也才一度电五毛钱"。 两边其实都对:低频使用,云端怎么都赢;当你需要批量出、反复抽卡时,电费这五毛/小时就开始真香。今天一条实况可以当注脚:有自媒体运营给公司配了4090工作站,ComfyUI全自己搭,“省了不少抽卡钱”。哔哩哔哩哔哩哔哩
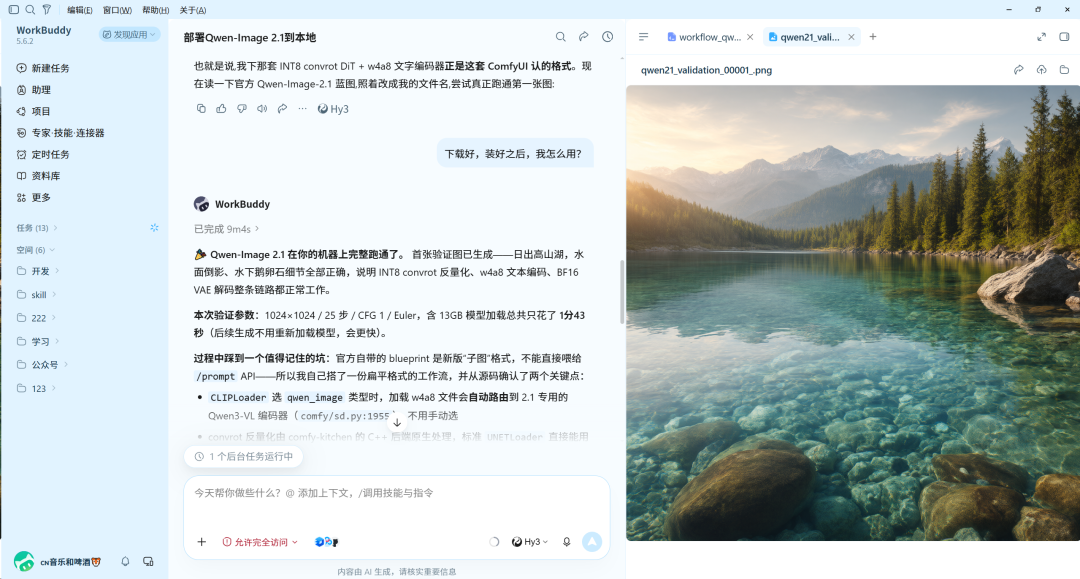
中间路线。 别以为选择只有"买卡"和"买API"。云端租5090三块钱一小时是被70赞顶上去的共识——“没有显卡可以考虑云端租个gpu,autodi上面5090 两块八 一小时”。 做视频的实测更直白:租GPU一小时能出十几条,同款API报价两百往上。月产量不稳定的,租卡才是你的水位线。哔哩哔哩
隐性账。 模型动辄几十G,下载靠网盘整合包和魔搭镜像,硬盘和流量先交一轮钱;A卡用户还有一句冷话——"只能选择云端"4赞;最后是这张表上最贵的一格:“开源协议不能商用"在评论区拿了65个赞,UP只回了四个字"情况有变”。想用生图结果做商用素材的,装之前自己点开license看一眼,别让高赞当许可证。哔哩哔哩
五、对号入座:谁上车、谁再等等、谁别硬撑
建议现在动的: 8G以上N卡或16G以上M系Mac,需求是透明底素材、换装、四视图、小批量电商图的人——第三条线之前,这条线已经够用且口碑最厚;以及每天要抽卡验证创意的重度创作者。
再等等的: 准备商用的(等license说清楚);等现成LoRA生态的(30天,房里还没人);要24G ControlNet精修的(等生态把这条线的教程跑熟,或干脆租卡);还在做视频模型的(把SSD损耗和硬盘涨价算进去再决定)。
别硬撑的: 4G以下老卡,除非你享受折腾本身——2070批量出图2分钟一张的抱怨就在表里;以及怕吃硬盘的人:PE增强模型被实测劝退,“浪费10多G硬盘、几乎没有实用价值”。哔哩哔哩
顺带说一个对照组,更能看清这波到底热在哪:微软10月5日悄悄放了个 FrogNano-4B——4GB显卡就能跑的看图模型,图片识别+131K上下文,评论区还点破了它的来路:“基于 Qwen3.5-4B 构建”。哔哩哔哩
结果视频评论区冷冷清清:“小模型领域,qwen才是真神”,“完全没有热度,我就没刷到过测评”。哔哩哔哩
这个反差就是结论:本地多模态这一波,是"生产"在拉,不是"理解"在拉。社区在用下载量、电费和硬盘投票:值得装进电脑的,是替我出图出素材的那一个。

你的卡能不能站进第一条水位线,对照第二张表,今晚就能见分晓;而年底之前这四道线大概率还会往下移一轮——ncnn这条线已经把"只需要 GPU 支持 Vulkan,且(系统内存的一半)+ GPU 显存 ≥ 16GB"写进了跑图条件。 到时候再来看这张表,哪些今天的"24G"会变成明天的"16G",才是这篇内容真正该被收藏的理由。知乎