以前跑 125B 模型,得用 80G 显存的 A100 凑一机柜。现在一张 12GB 显存的 RTX 5070,官方实测每秒吐 94 个 token。知乎知乎GitHub
开源引擎 Strata,9 月 24 日刚建仓,半个月 star 两万多,被顶上了 Hacker News 首页。它就干一件事:把阿里 8 月底开源的 125B 模型 Qwen3.8-Flash-Next,塞进普通游戏显卡。知乎小红书知乎知乎
模型没变小,只是大部分没上工
这是个 MoE 模型:125B 是库存总量,每个 token 真正激活的只有 6B 左右——每层 512 个专家,轮值的只有 10 个加 1 个共享专家。魔搭社区

Strata 顺着这点把机器拆成四层:热专家驻显存、全量权重放内存、冷门专家 CPU 现算、查找表躺 SSD。README 的比方很直白:做菜不必把储藏室全搬上料理台,常用调料伸手就有,其余随用随取。再配 MTP 投机解码,小草稿头先猜一串 token、大模型一次核验,吞吐再提 1.6~1.8 倍。知乎知乎GitHub
真正的门槛:显存管进门,内存条定座位
模型下载约 70GB,启动往内存灌 35~55GB,整机卡住 1~3 分钟。量化档位被内存卡死:32GB 只能跑 Coder 变体,48GB 够到 Q2_0/IQ2_XS,64GB 才轮到 IQ3 档,96GB 以上才配 UD-IQ4_XS。瓶颈从显存挪到了内存条和 PCIe 带宽:中端卡配 128G 内存,反而比旗舰卡配 32G 吃得更多。坏消息是内存正涨价:近三个月 DDR4 合约价涨 24%、DDR5 涨 20%。先别急着加条子,对着现有内存找档位。知乎GitHub知乎知乎
你的卡能跑成什么样
5070(12G 显存+64G 内存)Q2_0 实测 94 token/s、读提示词 2,650 token/s。3090 24G 官方预估 100~140。HN 网友 4090+128G 实测 124。B站 UP 主自报 22G 老卡 2080Ti 跑 48~60,扩到 512K 上下文只掉 4%。RX 9070 XT、7900 XTX 等 A 卡也已进官方支持。这些多是自报或预估值,看方向可以,别当保证书。知乎GitHub知乎哔哩哔哩

没有免费午餐
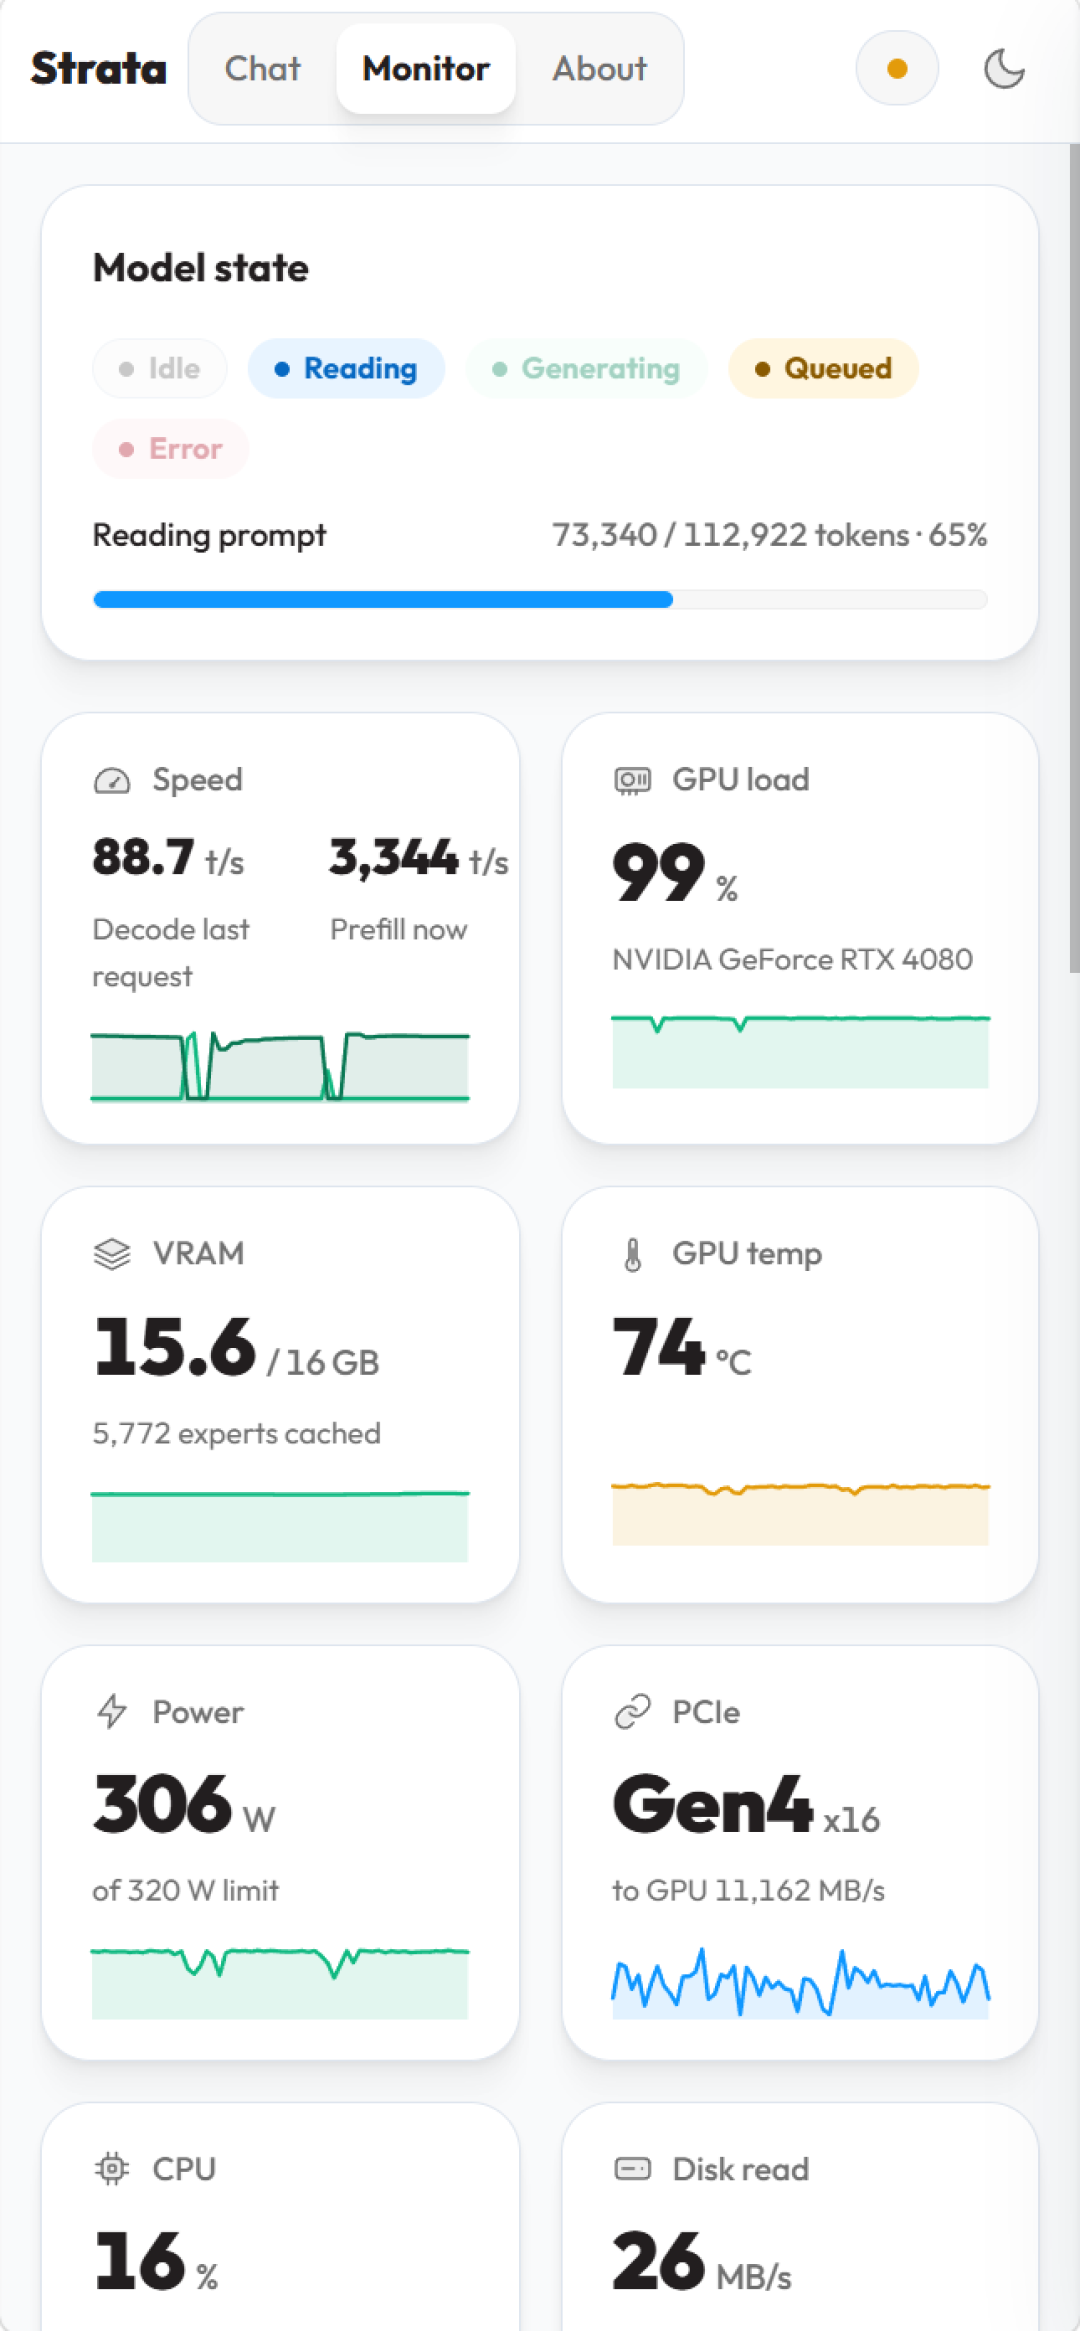
Q2_0 是 2bit 级量化,速度真,掉质量也真;Coder 变体砍掉一半专家,SWE-bench 保住 91% 的分,出了代码就变弱。一位 4080 用户实测:IQ3_XXS 比 IQ2_XS 中文知识 CMMLU 高 4 分,首字延迟从 1.33 秒涨到 3.4 秒。还有笔隐藏账:上下文和跟手感共用预算,128K 扩到 256K,KV 缓存多占的 1.5GiB 全从专家缓存里扣,短提示反而慢 25%。知乎知乎知乎
要不要上车
接入很顺:本机同时提供 OpenAI、Anthropic 两套兼容接口,Cursor、Claude Code 改一行地址就能挂。写草稿、做检索、日常问答,Q2_0 够爽;正经产出,从 IQ3 档起步、忍一下首字。它不是云端那个满血 125B,换到的是数据不出门、不限流、不按次付费——代价写在内存条、SSD 和等待时间里。知乎知乎