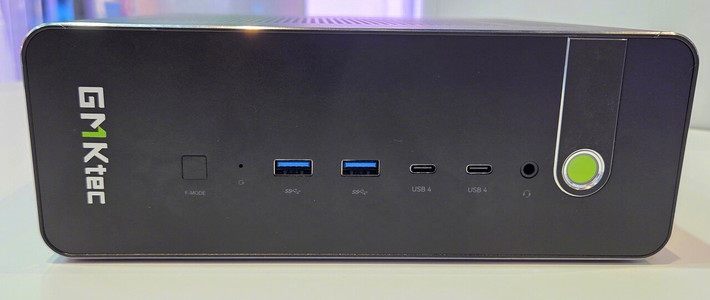
本地大模型圈这几天被一台小主机刷了屏。
10月19日,数码博主司波图放出极摩客EVO-X5 Pro实测,直接发问:192GB显存装进一台小主机,真能在家跑320B大模型?一晚上播放破2万,评论区吵翻了——有人喊真香,有人说这价钱都够买两台上一代了。哔哩哔哩
4万7一台的AI小主机,到底值不值?咱们把账算明白。
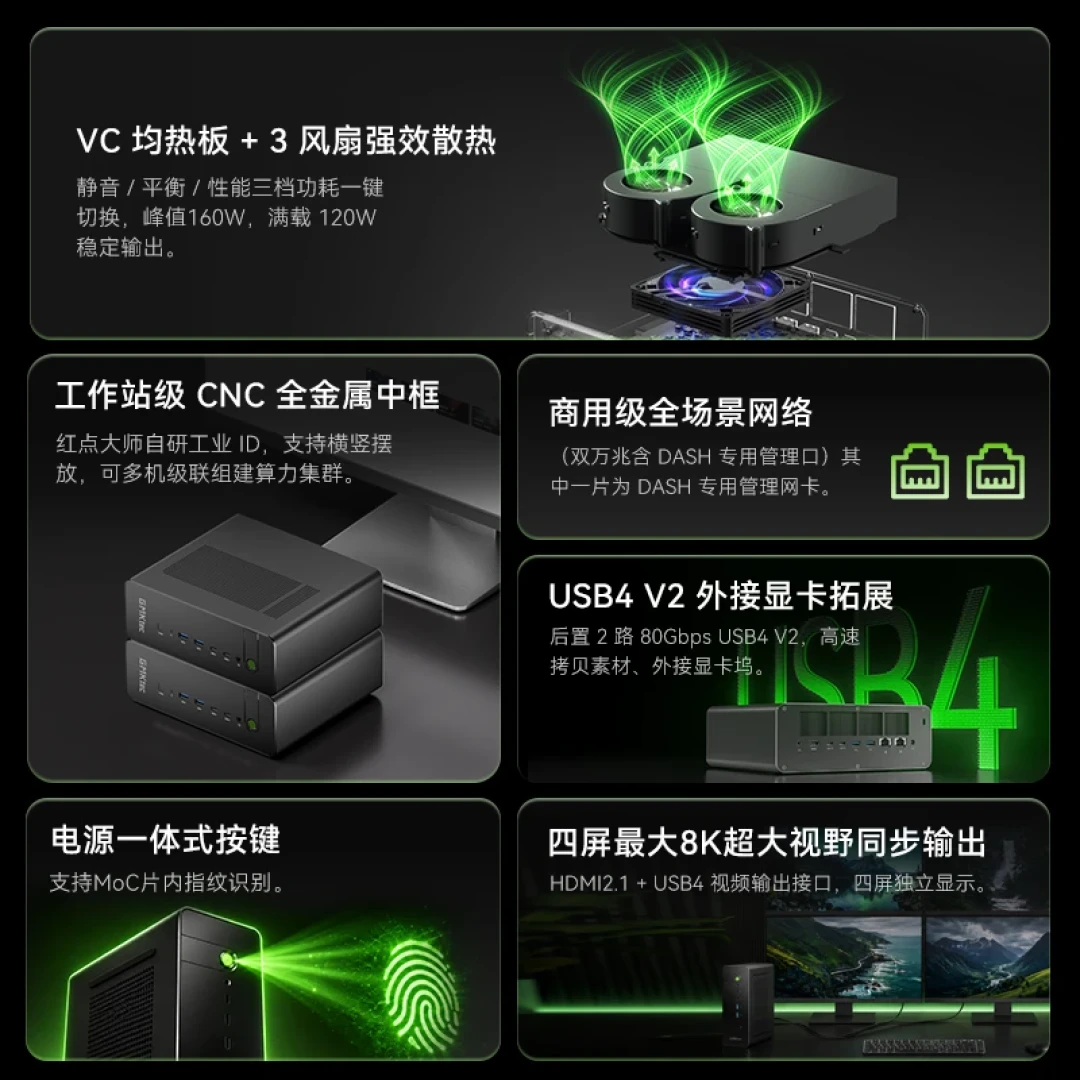
它是什么:192GB内存的「移动工作站」
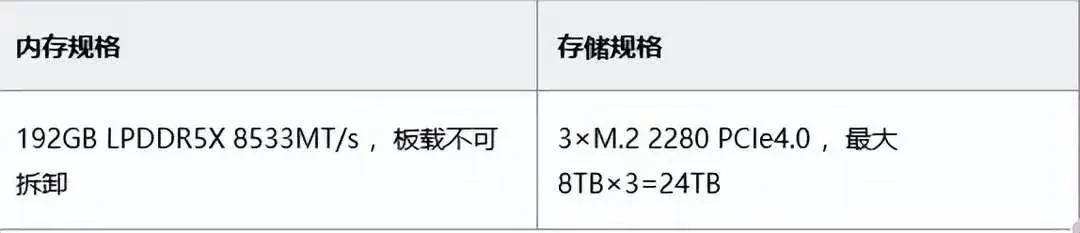
EVO-X5 Pro用的是AMD刚发布的旗舰移动芯Ryzen AI Max+ PRO 495,16个Zen 5核心,本质是锐龙9 9950X的缩小版。最大的卖点是内存:8颗LPDDR5x芯片直接焊在板上,凑出192GB统一内存,比上代395的128GB多了50%。微博知乎小红书
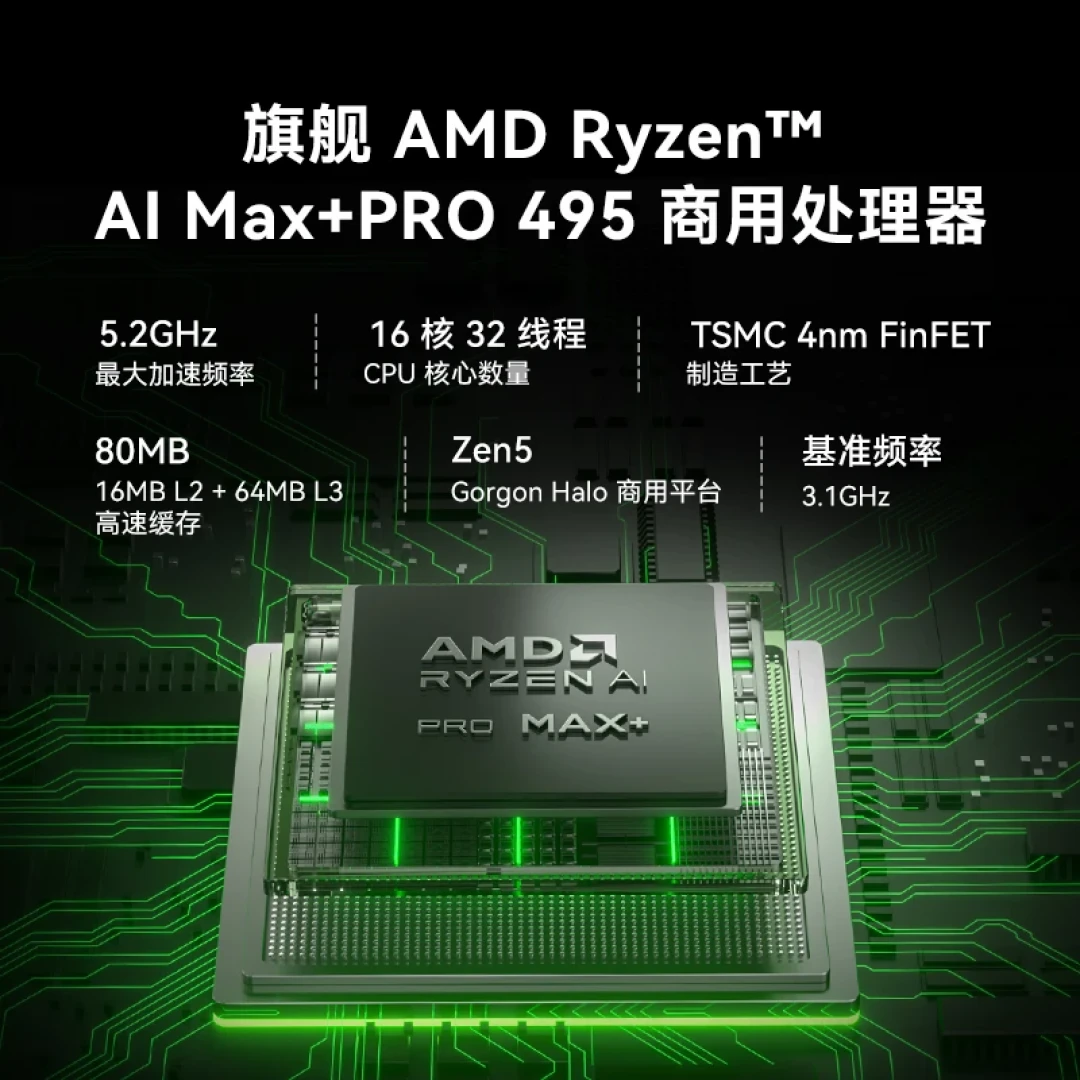
192GB是什么概念?Q4量化的DeepSeek V4-Flash(284B)要吃约130GB,上代128GB的机器连门都进不去;这台机器在Windows下扣掉系统开销,实际还能给模型留约176GB,连GLM-5.3-Flash(320B)都能装下。300B级大模型,第一次被塞进一台巴掌大的桌面机。哔哩哔哩哔哩哔哩
实测数据:输出速度能打,输入速度露怯
至顶AI实验室用llama.cpp跑了实测:DeepSeek V4-Flash生成速度约17 token/s,首token延迟2.1秒;开启投机解码后提到27 token/s,提升约60%。司波图玩得更极限——用特定引擎跑Qwen3.8 Flash Next,百万token上下文仍能保持约60 token/s。哔哩哔哩哔哩哔哩
输出速度已经媲美云端API,写文档、改代码、当日常助手完全够用,而且数据一个字都不出家门。
但冷水也得泼。这颗芯片的GPU还是上代的Radeon 8065S,一点没变;内存带宽从256GB/s挪到273GB/s——容量+50%,带宽只+7%。司波图评论区有条高赞说得很扎心:这类统一内存小主机的输入(提示词处理)速度普遍只有1.5K~2.5K token/s,而云端API上万才是常态。喂长文档的时候,它是个「读得慢、写得快」的闷葫芦。知乎哔哩哔哩
生态也是老问题:没有CUDA,训练微调基本免谈;Linux的NPU驱动还卡在两行代码的补丁上,最快也要等Linux 7.4内核。本质上,这是一台「推理专用机」。知乎
谁该买,谁该等
价格先报一下:46999元起,顶配版逼近5万,海外2TB版卖6799美元。知乎微博
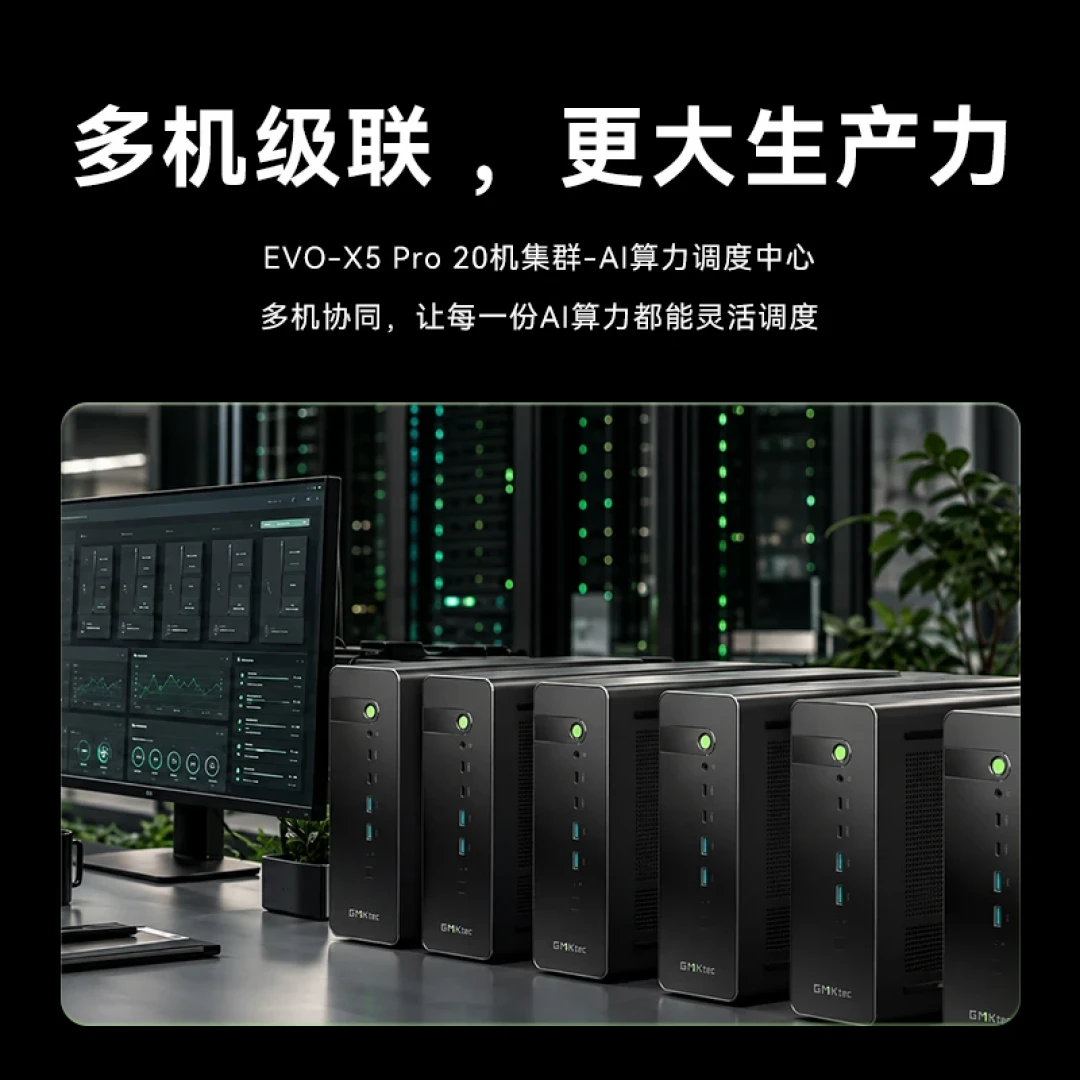
适合下手的,是必须本地跑128GB以上模型、或者要百万token长上下文且数据不能出门的人:小团队私有化部署、长文档重度用户。对你们来说,这是目前桌面上最省事的「单机整包方案」,不用拼卡不用组集群。
只是玩玩27B、量化125B的玩家,真不用为192GB掏溢价——评论区那句「这价钱都可以买两台395了」不是段子,两台128GB照样香。还有人说得更损:搞个nuc,省下来的钱买API绝对能用到内存降价。哔哩哔哩
想搞训练、离不开CUDA的,直接绕道。
最后提一句:495这波机器正在扎堆上市,极摩客、阿迈奇、铭凡、TOPCTX全来了,连Framework都开了预售。竞争才刚开始,不着急的,等等第二批价格再出手。知乎知乎