















 深耕数码、文娱兴趣领域




21
29
DeepSeek究竟处于什么水平?
2025-01-31 12:01:42
10点赞
16收藏
18评论
真的如同新闻报道的那样处于国际领先地位了吗?
DeepSeek-V3仅用2048块H800 GPU训练了不到2个月,总计266.4万个GPU小时,花费约557.6万美元,经过两个月的训练,就打造出了一个在chat BOT竞技场里排名第十的模型,而排名前九的都是Google和open AI的模型,这一成绩相当了不起。且他们的Tech report将技术细节基本上都开源了,这有助于其他公司了解和跟进其技术。
DeepSeek能达到现在的成果和数据质量有关系,但不完全归结于数据的优势,而是开发者们找到了更加适配数据的模型解决方案,在算法模型上优化,在有限的训练成本内找到了数据和模型更加合适的匹配与优化方式,是一种训练范式的创新。之前通常是数据好就套用基本相同的模型,而deepseek在这方面有了新的突破。
 Microsoft AI 公司首席执行官穆斯塔法・苏莱曼(Mustafa Suleyman)昨日(1 月 30 日)在 X 平台发布推文,宣布所有 Microsoft Copilot 用户现在都可以免费使用 OpenAI 的 o1 推理模型。
中国AI界上演"逆袭爽剧":开源模型让科技大佬集体失眠的N个理由
当DeepSeek甩出自家"炼丹秘籍"时,全球AI圈仿佛看到了现实版《功夫熊猫》——这只中国熊猫突然掏出惊为天人的功夫秘籍,吓得隔壁山姆大叔手里的GPU都抖了三抖。这场面堪比科技界的"路边摊经济革命",让我们看看这场"平民AI狂欢"背后的欢乐真相:
1. 中国AI:从跟跑变并驾齐驱的"秋名山车神"
美国ChatGPT刚出道时就像开保时捷的富二代,中国AI团队蹬着共享单车在后面追。谁料这两年我们悄悄改装出"五菱宏光版大模型"——Qwen、Kimi、InternVL轮番上阵,现在DeepSeek-R1直接秀出漂移绝技,在视频生成弯道玩起了超车。美国网友惊呼:"说好的技术代差呢?"

2. 开源模型:AI界的"拼多多"横空出世
当某些美国公司忙着用"AI灭世论"吓唬群众时,DeepSeek反手甩出MIT许可的"剁手价大礼包"——OpenAI收60刀的服务费,这里只要2.19刀!这价格差足够请30杯奶茶,堪称技术圈的"骨折促销"。建议改名叫Deep便宜(DeepCheap)算了!

3. 算力焦虑?不存在的!"中国式精打细算"震惊硅谷
被芯片卡脖子怎么办?中国团队祭出祖传"抠门大法":用性能缩水的H800显卡,配合算法优化的"降龙十八掌",硬是把训练成本压到600万美元。这操作好比用电磁炉做出了米其林大餐,气得显卡商直呼:"你们这样显得我们很呆!"
4. 科技大佬的"罗夏墨迹测试":同一个模型,N种破防
华尔街看到DeepSeek就抛股票,开发者看到却乐开花——这场景像极了过年时的亲戚群:有人看到"别人家孩子"就焦虑,有人盘算着用现成模型开发AI月老/法律顾问/病历翻译官。建议改行做"AI算命",毕竟连心理测试的活儿都能抢。
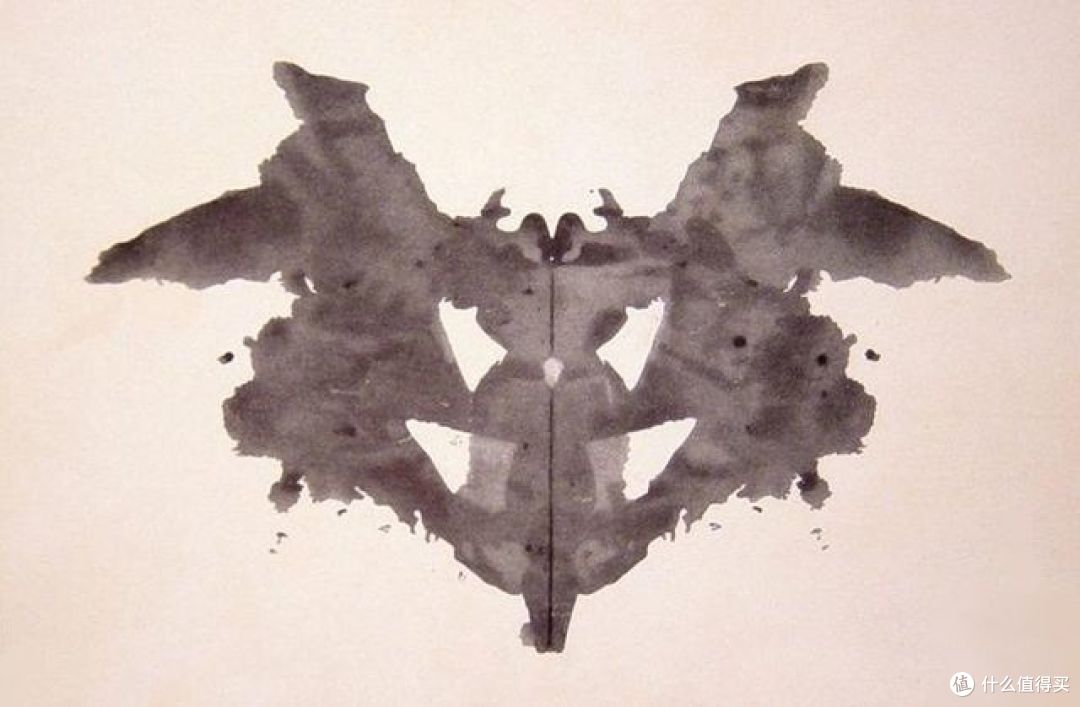
【冷知识彩蛋】文中提到的罗夏墨迹测验,堪称心理测试界的抽象画大赛。建议下次AI发布会直接办成艺术展:"您从这张参数分布图里看到了什么?是和平鸽还是制裁令?"(手动狗头)
这场AI界的"技术下乡"运动正在改写游戏规则:当基础模型变成白菜价,每个开发者都能化身"AI魔术师"。借用某网友神评:"以前玩AI像养吞金兽,现在简直是在支付宝喂小鸡!"
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~










校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案