









2
2
Mac 变随身 AI 服务器:每月省40刀,人在地铁也能调用家里算力
2026-05-11 21:13:31
38点赞
381收藏
18评论
 page_001.png
1. 凌晨 2 点的"配额焦虑",让我决定把 AI 搬回家
凌晨 2 点,我还在改一篇公众号文章。
打开 OpenAI,输入一段 800 字的润色请求——"You've exceeded your monthly limit"。上个月 $20 的 Plus 配额,到这个月的第 15 天就已经用完。再开 Claude Pro $20,两个月加起来 快 600 块人民币,就为了在关键时刻看它告诉我"额度用尽"。
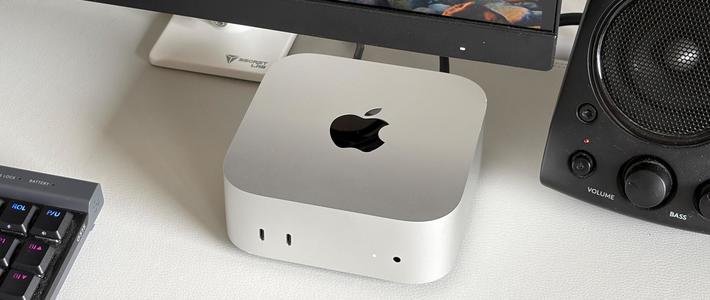
而我的 Mac Studio 正安静地放在家里书桌上,64GB 统一内存里的 Qwen3.6-35B 模型 24 小时待命——免费、无限、零延迟。只是有个致命问题:它只能在家里用。
如果我在地铁上、咖啡馆里、出差的酒店,都能直接调用家里 Mac 的算力呢?
折腾了三个月,我终于跑通了这套方案。之前那篇 《拒绝昂贵 API!Claude Code + llama.cpp + Qwen 3.6 打造最强本地 AI 系统》 讲了"怎么在家跑 AI",今天更进一步——怎么走到哪都能用。直接带你实现真正的 Token 自由。
2. 方案全貌:三块拼图,打通"人在天涯,AI 在家"
 page_003.png
逻辑上只需要这三块拼图:
Mac(算力底座):Apple Silicon 统一内存的天然优势,24 小时低功耗待命。关于 Mac 跑大模型怎么选配置,可以看我的 《2026 Apple Silicon Mac 跑本地 AI 大模型终极避坑指南》。
llama.cpp(翻译官):把模型文件转化为标准 API 服务,让本地 Qwen3.6 像 ChatGPT 一样被各种客户端调用。llama.cpp 跟 Ollama、LM Studio 怎么选?这篇横评 帮你理清。
Tailscale(隐形网线):无需公网 IP,无需折腾路由器端口映射。在手机、iPad 和家里 Mac 之间拉起一个全球范围的虚拟局域网。
这套架构的妙处在于:你不是把 Mac "暴露"在危险的公网上,而是把远方的设备"邀请"进了一个绝对私密的数字房间。
[你的手机/iPad/异地设备] <—— (加密隧道:Tailscale) ——> [家里的 Mac (llama.cpp + Qwen3.6)]
3. 为什么 Mac + Qwen3.6 是 2026 年的"天选组合"?
 page_004.png
关键在于 Qwen3.6-35B-A3B 采用的 MoE(混合专家架构)。350 亿参数知识储备,每次思考只激活最顶尖的 30 亿参数(3B Active)。用 3B 级别的极速推理,换取逼近 GPT-4o 的理解力。关于 Qwen3.6 的更多技术细节,可以看我这篇 《Qwen3.6-35B-A3B 重磅开源》。
再配合 Mac 的 统一内存(Unified Memory),PC 端需要两张昂贵显卡才能塞下的模型,在 Mac 上只是分掉了一部分内存而已。
维度云端 API (OpenAI/Anthropic)本地 Mac + Qwen3.6月费成本$20 - $200(持续上涨)0 元(仅需电费)Token 限制严格速率限制,用多必贵完全自由,24 小时无限量隐私安全数据投喂云端,不可控100% 物理隔离,私有网加密响应速度取决于跨境网络和服务器负载本地响应,秒开秒回部署难度扫码即用1 小时初始配置(看这篇就够了)
4. 部署思路:一小时搞定"AI 基座",真的不难
 page_005.png
我踩过无数坑后,帮你总结出了这条"成功率 100%"的最优路径。别怕,只要会复制粘贴,你就赢了。如果你还想搭建更完整的本地 AI 生态(llama.cpp + ComfyUI + OpenWebUI),可以看我那篇 《2026 本地 AI 末日堡垒》,那篇讲得更全面。
4.1 搭建私有网络(10 分钟)
 page_006.png
在 Mac 和你的随身设备上分别安装 Tailscale,登录同一个账号。看到 Mac 的 IP 地址(比如 100.x.x.x)亮起时,你的全球局域网就建好了。
4.2 编译推理引擎(15 分钟)
 page_007.png
打开终端,安装支持 Metal 加速(Mac GPU 核心)的编译环境:
# 1. 安装基础工具
brew install cmake git

# 2. 拉取源码并进入目录(最容易漏掉的一步!)
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp

# 3. 编译 Metal 版本
cmake -B build -DGGML_METAL=ON
cmake --build build --config Release
4.3 下载"黄金量化"模型(30 分钟)
推荐下载 Qwen3.6-35B-A3B 的 Q4_K_M 格式。约 21GB,既保留了绝大部分智能,在 32GB 内存的 Mac 上跑得飞快。如果你不確定选哪个量化版本,这篇本地大模型横评 详细对比了各量化的表现差异。
4.4 启动 API 服务(5 分钟)
# 启动服务器,监听 0.0.0.0 确保 Tailscale 内网可访问
./build/bin/llama-server -m models/qwen3.6-35b-a3b-q4_k_m.gguf
--host 0.0.0.0 --port 8080 -c 8192
温馨提示:在手机客户端配置时,API Key 随便填(如 "dummy")即可,因为你的私有网络里你就是唯一的超级管理员。
5. 真实生活:当 AI 走出房间,这四个场景"爽翻了"
 page_008.png
场景一:地铁上的"灵感白嫖"
2026 年的北京地铁 10 号线依旧拥挤。今天早高峰,我被挤在车厢角落,突然想到一个关于"数字极简"的绝妙标题。
我打开 Chatbox 客户端,API 地址填的是家里 Mac 的 Tailscale IP。输入:"帮我把这几个关键词发散出 10 个有痛点的标题。" 几秒钟后,Qwen3.6 开始在手机屏幕上疯狂输出。如果用的是 OpenAI,这 10 个标题大概要烧掉我 2 天的配额。而现在,一分钱没花。
那一刻,耳边嘈杂的报站声仿佛都消失了。100% 属于我的私有算力,不排队、不收费、不要 Token 钱。
场景二:公司电脑的"影子武士"
公司配的那台轻薄本,开三个网页都能转圈。更麻烦的是,公司内网会对所有上传云端的数据进行审计。
有一次,我需要分析一段包含客户敏感信息的系统日志,我怎么敢发给 OpenAI?
我开启了 Tailscale,让公司这台弱鸡电脑瞬间"魂穿"家里的 Mac Studio。Qwen3.6 在家里的机器上飞速运转,给出的优化建议精准且专业。数据从始至终只在我的私有隧道里流动,没经过任何第三方服务器。
 page_009.png
场景三:iPad 变身"移动智囊团"
周末,我带着 iPad Pro 来到一家满是豆子香气的精品咖啡馆。不想带沉重的笔记本,只想轻盈地写稿。
我点开分屏,左边是 Obsidian,右边是调用家里 AI 的聊天框。让 Qwen3.6 帮我梳理三本书的逻辑交叉点。如果你也想把 Obsidian 知识库和本地 AI 深度打通,可以看我那篇 《受够了 AI 一问三不知?Obsidian + 本地 RAG 才是终极方案》。阳光洒在屏幕上,随着文字跳动,iPad 不再是一个只能看剧的平板——它成了连接我个人知识库与强大算力的"超级终端"。
场景四:深夜的"写作副驾驶"
作为博主,我经常在凌晨 2 点修改排版。一个好段落,可能要推翻重写七八遍才能满意。用云端 AI 的话,七八遍的改写足够烧掉大半配额,我会不自觉地给自己设限——"算了吧,就这样吧"。
现在?让 Qwen3.6 帮我润色每一个段落,一遍遍推倒重来,没有任何心理负担。不满意就重来,再不满意换个角度再来。"Token 自由"带来的不仅是省钱,更是思维的彻底解放。 你可以毫无压力地尝试各种古怪的指令,直到打磨出最完美的句子。
6. 安全警示:别让你的 AI "裸奔"在公网
 page_010.png
我必须严厉地提醒大家:本地部署不等于绝对安全!
我见过太多新手为了图省事,在路由器里搞"端口映射",把 Mac 的 8080 端口直接丢到公网上。这在 2026 年跟裸奔没有任何区别。一旦 IP 被黑产扫描到,你的整个 API 服务甚至关联的本地文件,都将成为别人的"战利品"。
我的"三不"原则:
不搞公网映射:坚持使用 Tailscale 这种基于 Zero Trust(零信任) 架构的私有网络。
不乱授权设备:定期检查 Tailscale 设备列表,把临时测试的设备及时踢出去。
进阶玩家配置 ACL:在 Tailscale 后台配置 访问控制列表 (ACL),规定只有手机和 iPad 能访问 8080 端口。
安全不是来自你的密码多长,而是来自你的暴露面有多小。
如果你还关心 AI 生图领域的隐私安全问题,这篇《AI 生图隐私安全免费全都要》 同样值得阅读。
7. 结语:云端是租来的,本地才是自己的
 page_011.png
折腾技术的终点,从来不是为了技术本身,而是为了那种"随时随地、自由掌控"的爽快感。
云端 AI 确实强大,但它始终是别人家里的"租房"——随时可能涨价、断电、偷看你的隐私。只有这套跑在自己 Mac 上、通过私有网络随身调用的本地 AI,才是你真正的"数字避风港"。
只有随时随地能用的本地 AI,才真正属于你自己。
📚 更多推荐阅读:
《3000 元老电脑跑起 35B 大模型》 —— 没有 Mac?老电脑也能跑大模型
《装了 OpenClaw 却只会聊天?》 —— 让本地 AI 真正帮你干活
《白嫖党必看 ChatGPT Business》 —— 本地 + 云端的最佳平衡策略
你平时在什么场景下最想用 AI? 是地铁上脑暴选题,还是公司里偷偷分析敏感数据?
欢迎在评论区聊聊你的场景,我看看能不能帮你调优配置。
福利: 评论区回复关键词"命令",我整理了一份包含完整启动参数、进阶 ACL 配置模版以及常见报错处理的"全家桶部署包"发给你。
作者:旅行者 标签:#本地大模型 #MacAI #Qwen3.6 #Tailscale #私人AI #Token自由 #玩客笔记






校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案
校验提示文案