9月3日,黄仁勋在英伟达博客上写下的第一句话,把金额精确到了千位:12,930,300,000美元。英伟达博客
两个月后,美国司法部问的是另一个问题。路透10月28日报道,监管人员在问询这笔交易会不会让英伟达掌控AI领域的「基础分发节点」。 路透的说法来自两位知情人士。司法部拒绝置评。知乎
被买下的公司,大多数普通人没打开过。
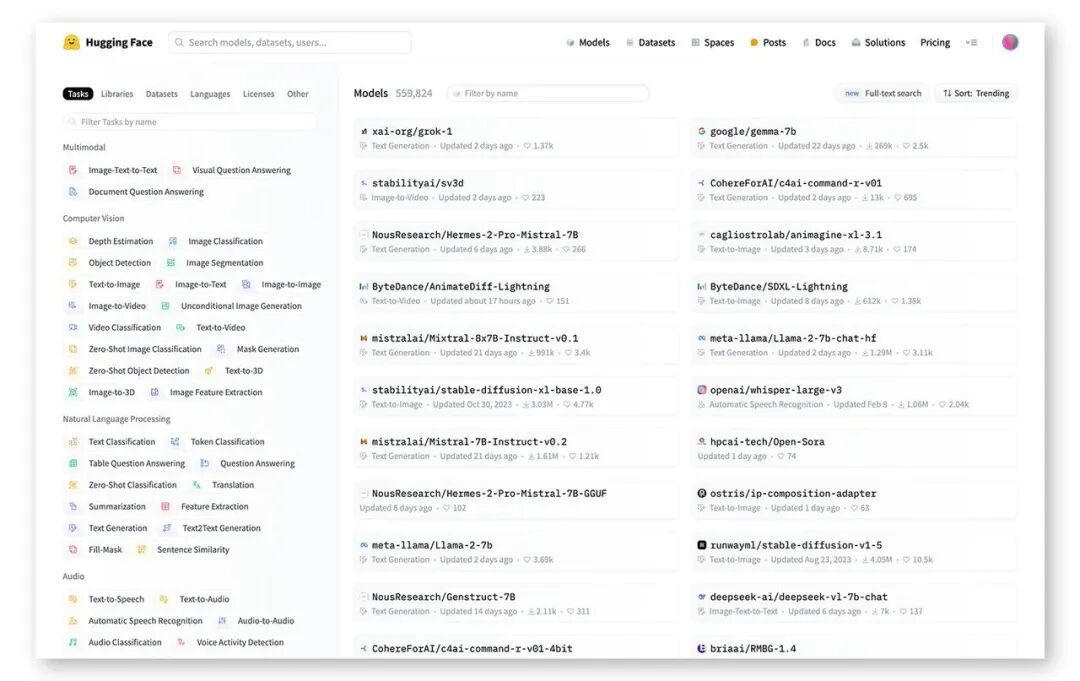
Hugging Face不训练GPT,不造GPU,也不是云厂商。但1800万开发者在这里找模型、比数据集、做微调、部署应用。
平台上放着300万个模型、50万个数据集、100万个应用,20万家公司用它发现、评估、定制和部署AI。36氪
它今年8月的年化收入约1.5亿美元。这个数字来自第三方估算,公司从未披露。129.3亿除以1.5亿,约86倍市销率。
对英伟达不算贵。它给第三财季的营收指引是1080亿美元,这笔钱约占12%。这份指引还没有计入中国大陆和香港的数据中心计算收入。
一家收入1.5亿美元的公司,为什么值这个价?
答案在2017年之后。Hugging Face最早是个陪人聊天的机器人,真正改命的是Transformers开源库:它把BERT、GPT这些模型装进同一套接口,开发者不用为每个新模型重写一遍工程。
后来的Hub又把发布、发现、下载、微调、再分发接成一条动线。
对一个开源模型来说,「在Hugging Face上线」越来越接近发布动作本身。
英伟达买的正是这条动线。
它最大的几个客户——谷歌、亚马逊、微软、Meta、OpenAI——都在自研芯片。
CUDA的护城河有一个前提:模型还得绕着英伟达转。买下Hugging Face,等于从卖铲子的位置,往开发者打开电脑的第一站挪了一步。
英伟达不需要封杀谁。
只要让自家硬件更早拿到适配、文档更全、性能榜单的口径更熟悉、一键部署默认指向合作云,天平就会慢慢倾斜。
The Register的比喻很直白:不会有人允许汽车制造商买下主要的燃料分销渠道,再买下维修技师的培训体系。
收购宣布时,黄仁勋承诺Hugging Face仍是开放平台,开发者不必使用英伟达算力。
公开承诺写得很具体,但都停在意愿层面:没有写期限,没有写治理机制,没有写独立董事会安排,也没有写非英伟达后端的投入承诺。
这个入口有多大,看一组数。
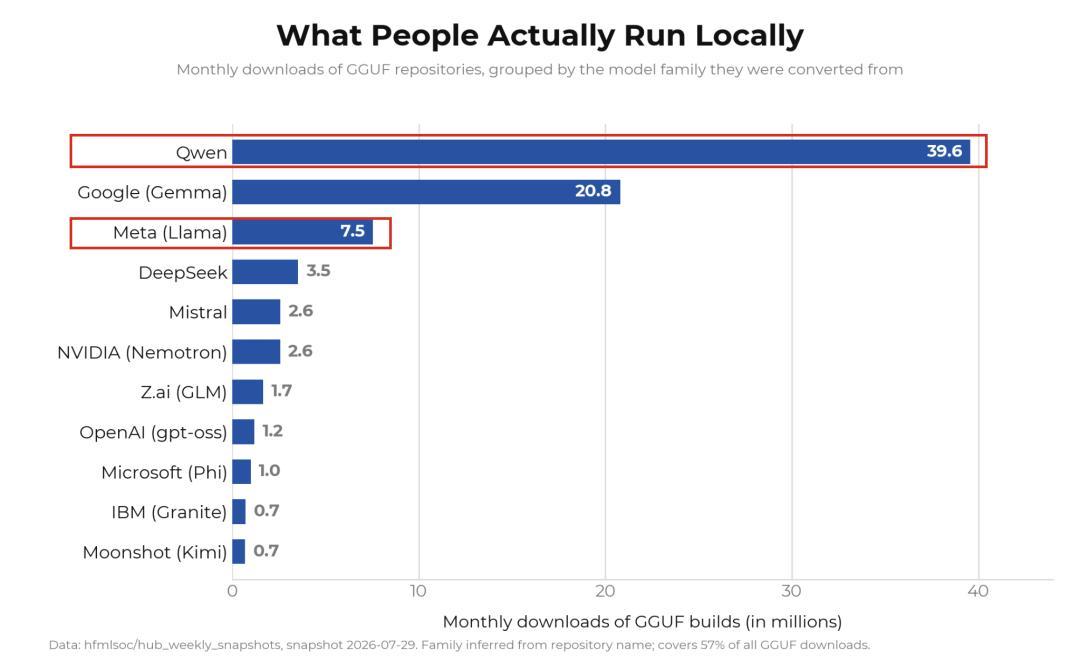
Hugging Face自己的报告里,基于Qwen衍生的模型有151,448个,是谷歌的近两倍、Meta全系之和的2.6倍。
按GGUF格式的本地下载量算,Qwen每月3960万次,是Llama的5倍多。 中国开源模型出海,很多从这里开始。36氪
英伟达自己也是这个平台最大的开放模型贡献者:500多个模型、250多个数据集。买之前是最大的贡献者,买之后是所有者。
最接近的先例是GitHub。2018年微软花75亿美元买下它,对应25到37倍市销率,外界同样喊贵。今天GitHub有近2亿开发者。
但GitHub背后有Git,代码和提交历史可以完整克隆走。模型没有这样一层对应物。
搬走一个safetensors文件很容易。搬走围绕它长出来的微调版、量化版、工具适配和讨论,很难。
司法部这次只是问询,不等于认定违法,交易预计2027年上半年交割。在CNBC的采访里,黄仁勋说他原本希望Hugging Face保持独立,但出现了其他竞购者。
接下来值得盯三件事:欧盟11月会不会发正式问询;8-K里10亿美元留任计划的兑现条件;ROCm、Gaudi、Trainium在Hugging Face上的增量。
129亿美元买不到300万个模型——绝大多数本来就不属于Hugging Face。它买的是开发者输入模型名字之后,系统默认把他带向哪里。
这笔账,要等交割后一两个季度才看得清。