WorkBuddy 的模型限额放开之后,很多人的用法还是老样子:打开,点"均衡",让它跑。知乎
然后盯着积分账单犯嘀咕:为什么一个看着挺简单的活,扣了几十分积分,而上次类似的只花了几分?
这不是错觉。这几天好几个测评人各自跑了同一类实验:把 WorkBuddy 里的模型挨个喂同一份任务,数积分——同一件活,差价能拉到二十到三十倍。知乎哔哩哔哩
别迷信默认三档
快速、均衡、极致,这三档看着省事,但有实测者算过账:均衡档的实际积分消耗约为快速档的 10 倍,极致档约 30 倍。倍率数字看着人畜无害,但倍率只定单价,模型思考多久、吐多少字、中途返不返工,才决定总积分。评论区的困惑很典型:同一个任务,前后两个难度差不多的问题,前一个花几分,后一个花几十分。知乎哔哩哔哩
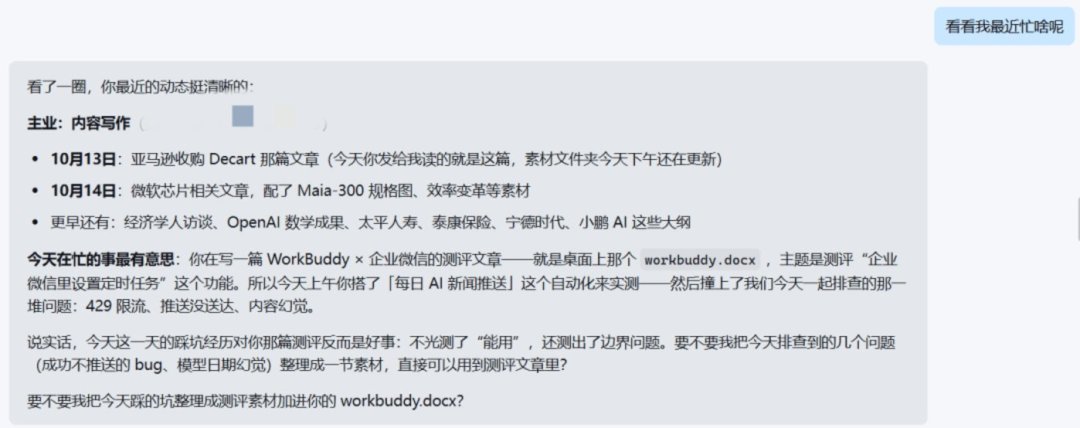
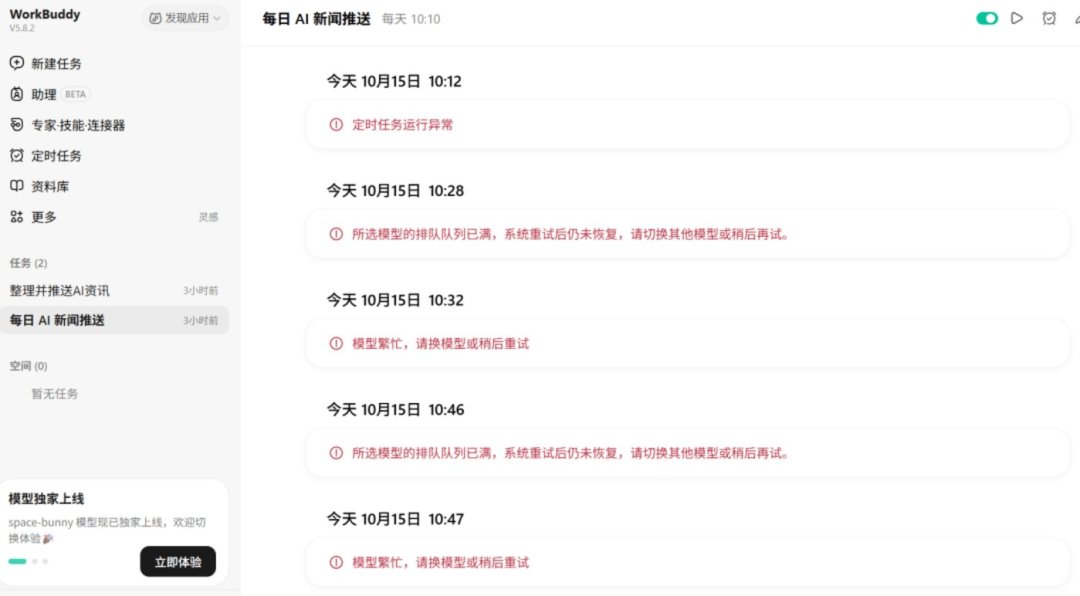
返工和排队才是吞分大户:任务中途暂停、选择继续,会重复消耗积分和运行配额。同样的活,有人用 DeepSeek 花 2.4 积分十分钟收工,换混元 4 跑了四十多分钟没完、只能打断换模型重新生成。钛媒体哔哩哔哩
主力其实是便宜的
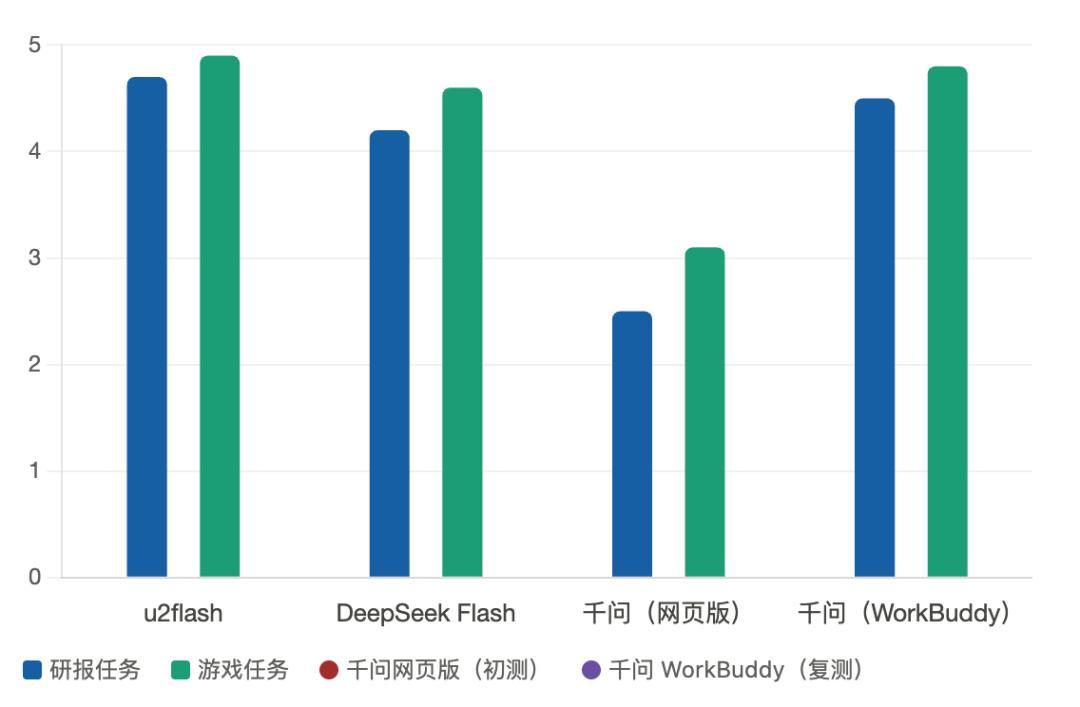
在多位实测者手里,真正能当主力的就两个 Flash 型号:DeepSeek-V4.1-Flash(约 0.11x),长文本、超长项目的天花板;GLM-5.3-Flash(约 0.08x),图形视频类的活比前者还稳,还更省积分。这两个轮着用,日常九成的活就够了。Flash 模型也越来越像 AI 世界的基本款,速度快、价格低,应付日常任务绰绰有余。知乎36氪
剩下的按场景分配:
写公文、合同,GLM-5.3 的合规化表达是真漂亮,0.69x 值这个价。知乎
长重任务再考虑 Kimi 系,贵但稳,评论区原话:有钱想省事无脑 Kimi 就行。哔哩哔哩
Hy3 白天限免、Hy4 preview 夜间限免,捡漏可以,别指望扛重活——"我直接用的它拒绝给我服务了"就是前车之鉴。哔哩哔哩
动手前先做一件事
最容易被忽略的坑:倍率不是静态的,跟着官方调价走。有人晒出自己客户端的记录,DeepSeek Flash 的倍率从 0.06x 开始一路变。DeepSeek Pro 更是涨到 0.51x,只是它写代码确实能打,贵有贵的道理。所以每次扣积分之前,先打开模型选择窗,扫一眼当前的倍率表,别拿旧印象结算新账单。哔哩哔哩知乎
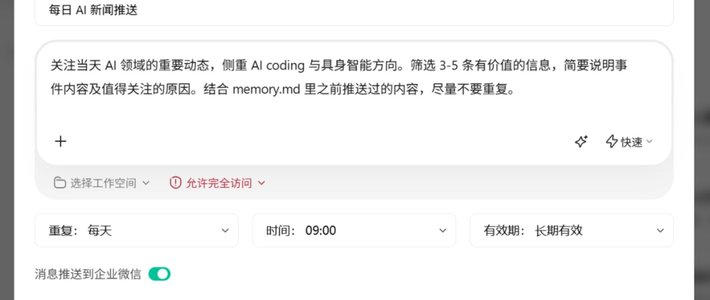
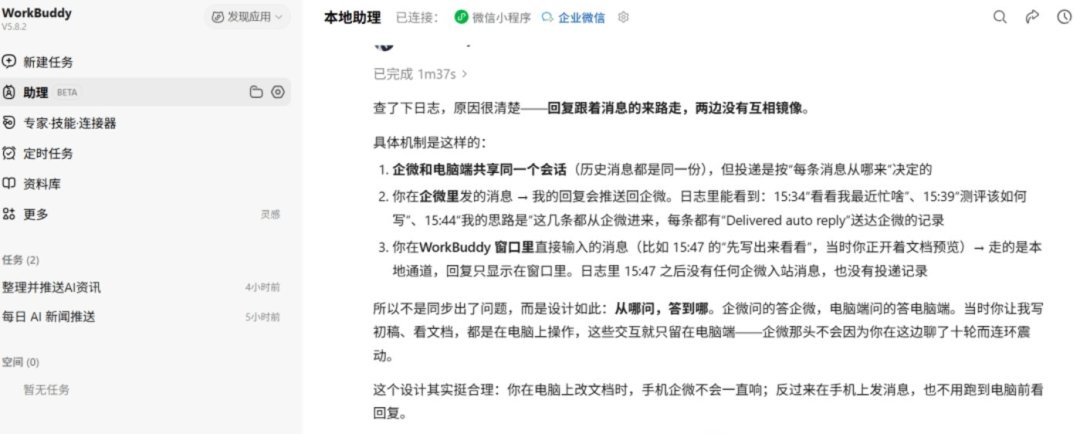
另外,记账也别偷懒:把 WorkBuddy 接到企业微信后,任务进度和交付结果都会推回聊天窗口。哪一轮扣了积分、哪一轮是白跑,一眼就能对上账。钛媒体
AI 办公用得起不值,分水岭已经从"哪个模型更聪明"挪到了"谁能算明白积分这本账"。贵的只用在刀刃上,其余全交给 Flash——这套打法跑下来,你每月的积分大概率能多活一阵。