

如果你的 Agent 上线半年,还在犯三个月前犯过的错,那大概率不是模型笨,是它压根没"记住"。
今年11月,Anthropic 发布研究文章《The Components of Agent Memory》,把长期记忆的设计摊开讲了一遍。结论翻译成人话就一句:记得越全,不等于记得越对。知乎
一个扎心的实验:拼命记,反而玩得差
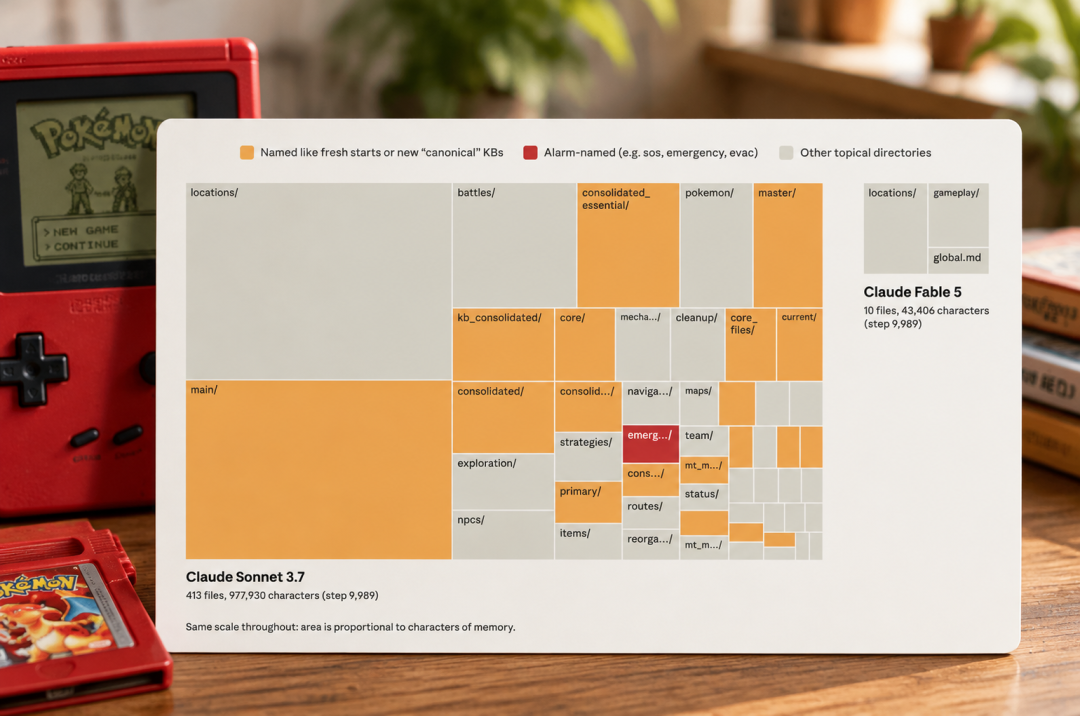
玩到约 1 万步时,Sonnet 3.7 写下了 413 份记忆文件,却只拿到 1 枚徽章。Anthropic官网知乎
Fable 5 只留 10 份文件、约 4.3 万字符,拿了 4 枚徽章。知乎
更扎心的是,Sonnet 3.7 曾连续 17 个步骤都在维护记忆文件,期间游戏一步没推进。(两个模型基础能力不同,成绩差距不能全算在记忆策略头上——但两条路线被摆上了台面:完整记录经历,vs 选择性保留经验。)Anthropic官网知乎
记忆是预测,不是硬盘
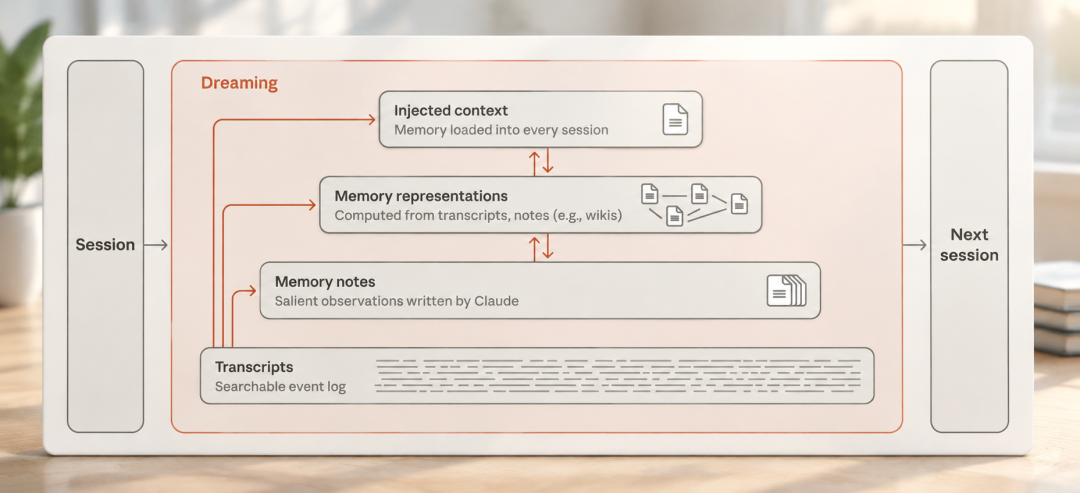
Anthropic 原话很直接:Memory is, occasionally, a prediction——每存一条信息,都是在赌它未来用得上。他们把记忆拆成四层,从底到顶。Anthropic官网知乎
Transcripts:原始执行记录,存下全部经历;
Memory Notes:只提取用户偏好、失败教训、已验证规则;
Memory Representations:把零散记忆组织成互相链接的知识 Wiki;
Injected Context:只把最重要的信息带进新 Session。
注入层有硬配额:Claude Code 的 Auto Memory 只把 MEMORY.md 前 200 行或 25KB 放进上下文,其余靠索引按需读取。它给出的设计原则很干脆:长期记忆可以不断增长,但每次真正进入 Context Window 的信息必须经过筛选。Anthropic官网知乎
Dreaming:睡一觉,改掉"记错的"
最有话题度的概念是 Dreaming——离线复盘:任务结束后让另一个工作流回查执行记录,修正错误,生成新笔记与知识表示。Anthropic 说得很形象:这就是借鉴人类睡眠期间记忆巩固的机制。Anthropic官网知乎
Anthropic 讲了个恐怖故事:Claude 把山洞出口的位置记错之后,每个 Session 都信这条错误笔记,反复迷路,到不了下一座城市;Dreaming 回查修正后,Agent 才走通。Anthropic官网知乎
错误记忆比遗忘更麻烦——一次错误被写入长期记忆,就会被后续 Session 反复引用、复制。知乎
做应用开发的,现在能抄三件事
先筛选再存:界面随时能查到的(金钱、位置)一个字都不值得存,只留"要靠踩坑才知道的规律";
给知识整理设信息密度闸门:一个实验里原始文件只有 115KB,整理出的 Wiki 反而膨胀到 203KB,比原文还大。整理不等于压缩;知乎
给记忆配"复盘任务":知识库 Wiki 实验里,Dreaming 会话从 2 轮扩到 128 轮后,25 个问题的得分从 13% 升到 48%。Anthropic官网
检索加 Wiki 平均每道题还省了约 2 万 token。知乎
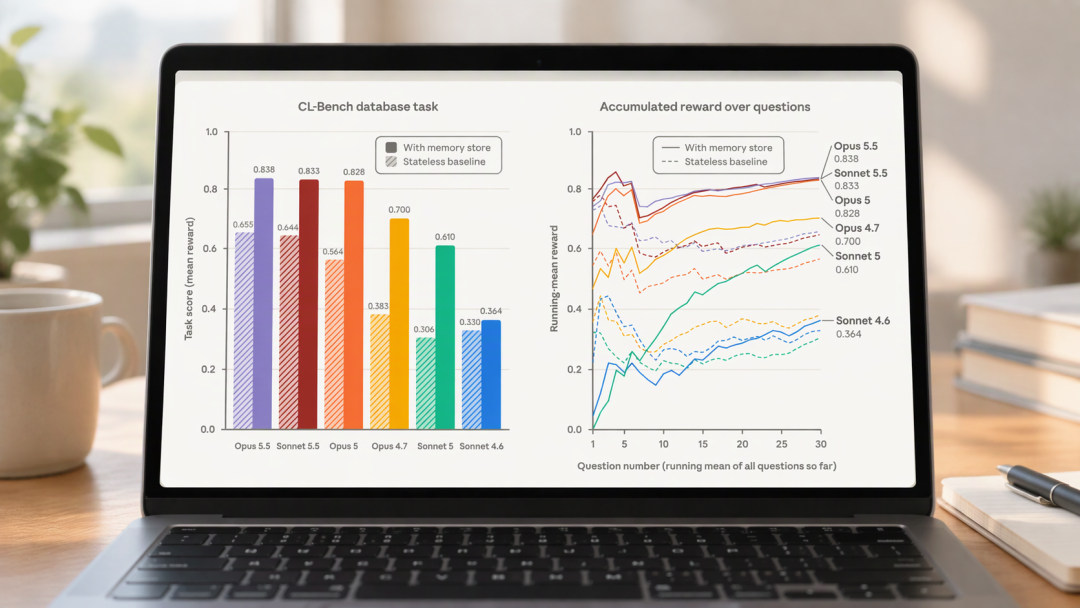
另一组 CL-Bench 数据库任务里,开启记忆让 Opus 5 的平均奖励从 0.564 提到 0.828。这组数字指的是校验与修正的闭环,不是"存完就完事"。知乎哔哩哔哩
至于 Dreams API,目前只在 Managed Agents 中提供,仍是需要单独申请的受限研究预览。但四层架构的思路——选择性记忆、配额化注入、离线纠错——今天就能动手搭。哔哩哔哩
克尔凯郭尔那句"人生只能向后理解,却必须向前生活",被 Anthropic 拿来给 Agent 记忆收尾。知乎
一个 Agent 经历了一万次任务,第一万零一次还在重复第一次的错误,那再长的 Context Window,也不叫记住。知乎

当前文章无评论,是时候发表评论了