

北京时间 11 月 21 日凌晨,OpenAI 发布了《Combatting adversarial distillation》(打击对抗性蒸馏)报告。在汇总六个攻击模型的黑盒红队评测中,事后套取模型上一轮对话里写下的完整推理,旧防线下的 GPT-6 Astra 平均攻击成功率是 54.0%,升级到 GPT-6.2 Astra 与新版防护后被压到 0.2%;套取本轮正在生成的推理,也从 22.9% 降到 0.9%。所以回到标题的问题:能做。0.2% 宣判的是一条特定的高价值提取路线,而蒸馏本身——用模型返回的可见内容训练小模型——这次并没有被封死。新智元IT之家知乎
0.2% 的分母是什么
OpenAI 采用的是自适应黑盒评测,“黑盒”描述测试方的视野:只能看到外部用户能够看到的信息,“自适应”描述测试方会根据系统的回应调整后续尝试。攻击问题也定义得很窄:给模型一个新请求,测试方能不能拿到它回答先前某一轮问题时写下的私有推理。知乎
这套评测汇总了六个攻击模型的结果,博客对照表只列 Astra,GPT-6.2 Sol 的数字写在两款模型的系统卡里。知乎
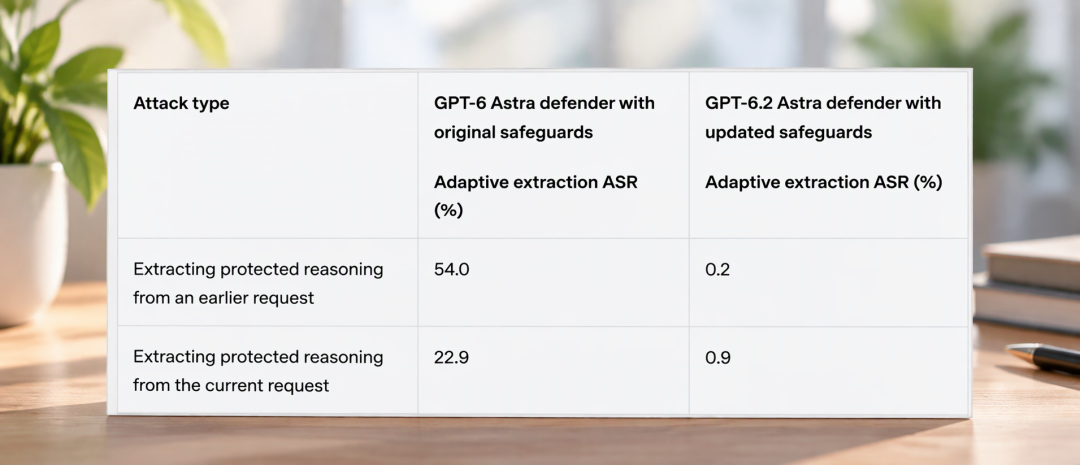
同样容易被误读的,是把 0.2% 乘上当天的一万次 API 调用——测试中的一次提取尝试并不能和线上请求一一对应,算出来的数字没有可解释的线上含义。“先前”与“本轮”问的也是两个问题。知乎
值得专门上锁的“草稿纸”,和用户看到的回答不是一回事:成批账号拿 GPT 的回答训练自己的模型时,最值钱的正是模型写下的完整推理,学完整推理的学生模型做网络安全题普遍更强。摘要已经挑过重点,而模型得出答案前走过的弯路、中途放弃一个想法的依据,最终回答未必留下痕迹——OpenAI 称这类内容为“受保护推理”。微博
防线怎么搭起来的
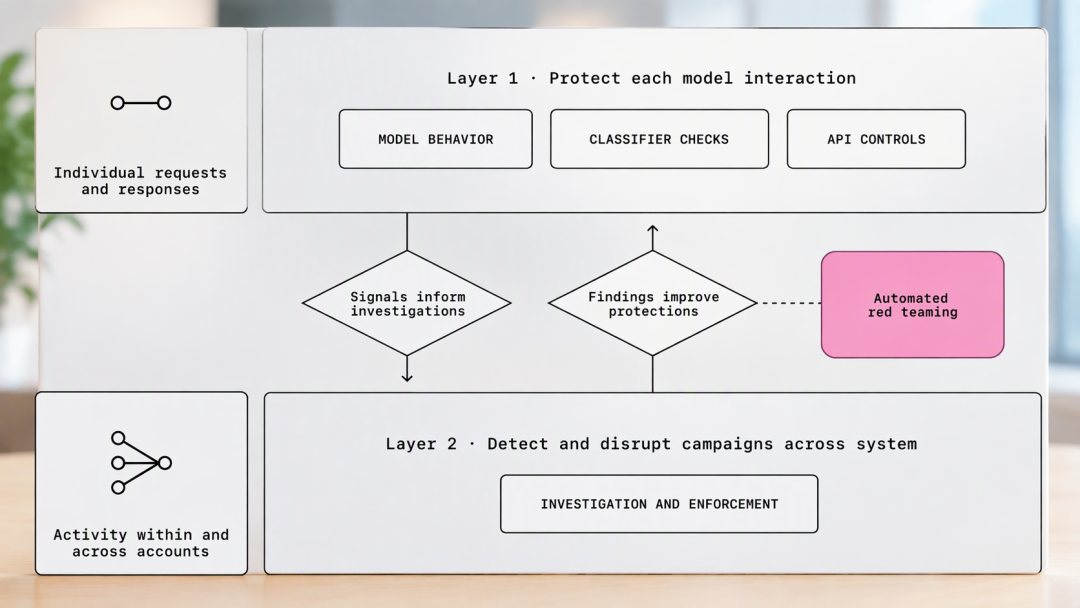
报告把防护分成两层。单次请求这一层有三道。第一道是对抗训练,让模型自己识别索取私有推理的意图并拒答,同时保留回答“这一步为什么成立”这类正当追问。第二道是输入、输出分类器,盯的不只是给用户的回复,还有被偷偷写进工具调用参数的推理,流式与非流式响应都在覆盖范围内。第三道在 API 层:受保护推理与产生它的会话历史硬绑定,改写前序消息,跟在其后的旧推理直接作废,防护更弱的旧模型族也被禁止读取 GPT-6.2 系列的推理记录。知乎知乎知乎
账号层面是另一层:把请求与账号信号汇总调查,确认违规后对整个账号网络处置,公司自曝今年夏天以来每周封禁数千到数万个账号。OpenAI 还会向其他模型提供方分享调查中识别的指标,供对方核查自家服务上的相关活动。公司也已呼吁美国国会出台法案、加强出口管制。微博知乎新智元
报告里另一个实验,对开发者更关键
OpenAI 用同一个预训练学生底座做了对照:两组都能看教师的最终回答、推理摘要和工具交互记录,精确轨迹组额外获得完整推理;微调后精确组总体领先,再做一轮轻量强化学习,胜负就取决于做题时能用多少推理预算——最高一档 524,288 个 token 的预算下,两项任务相差 7.79 和 9.78 个百分点,而预算收紧,摘要组反而领先。知乎
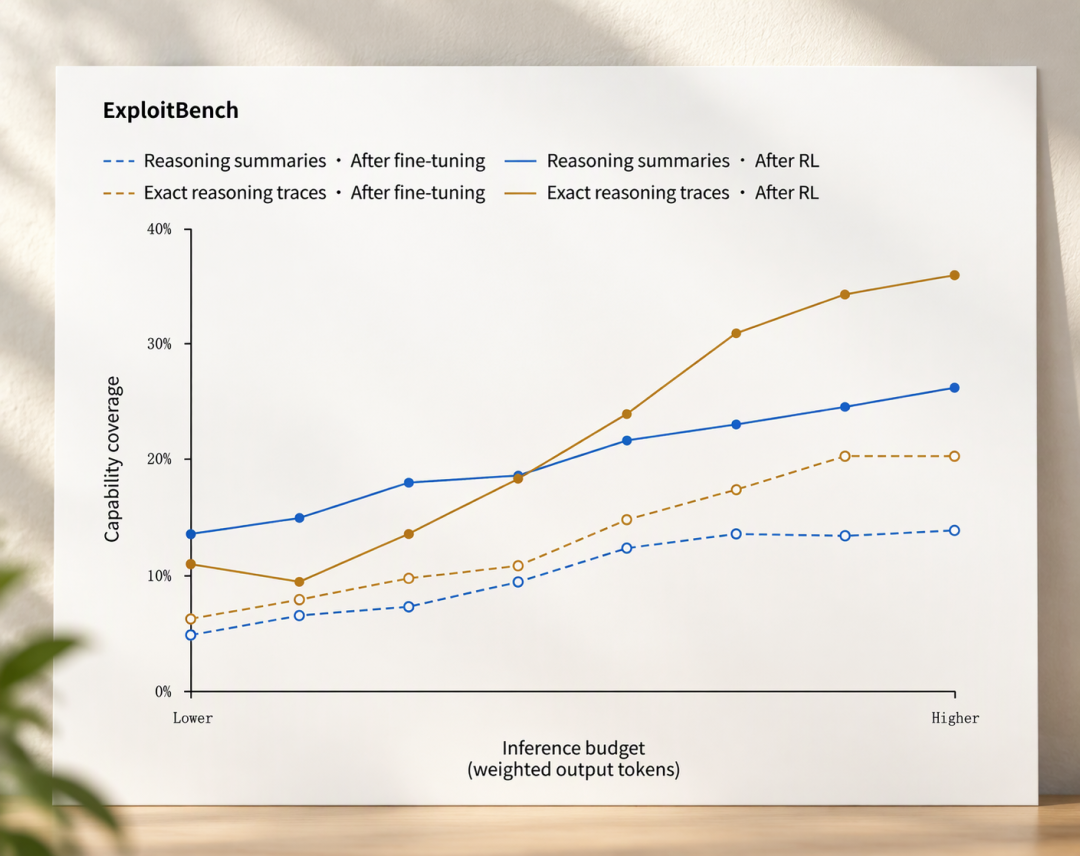
换句话说,OpenAI 的实验在证明精确轨迹值钱的同时,也反过来证明只用思维链摘要做蒸馏,收益仍然非常可观。要拿接近十个百分点的差距算收益,得先确认产品用得起那么高的推理预算。做低延迟小模型的团队,用可见摘要蒸馏拿到的仍是收益大头;真正被锁死的,是高推理预算下的能力上限。知乎知乎
开发者现在还能走哪几条路
第一类,用教师可见输出做训练数据,技术上依然通,但合规已经写实:Anthropic 的新用量政策 11 月 12 日生效,白纸黑字禁止未经授权用其输出训练模型。OpenAI 一侧则是账号封禁与跨厂商指标共享,批量采集的外部风险显著上升;也有自媒体把账算得更直接——反蒸馏措施的主要效果未必是阻止访问,而是将蒸馏方的成本提高了十倍以上,导致经济账需要重算。这是民间估算,OpenAI 没有公布对应的成本账单。知乎微博
第二类,开源权重模型、自蒸馏与数据合成,从来不在这条防线上。方法演进也在绕开对教师内部信号的依赖:清华团队 10 月提出的 ActionOPD 把监督单位从 token 换成语义动作,仅需访问黑盒教师模型的生成接口,无需获取 Token 概率。UIUC 等机构提出的 Ask-to-Distill 则反过来优化问题本身,直接衡量一道问题能激发多少可利用的教师监督信号,并用强化学习训练问题生成器。36氪知乎
一个观察信号:10 月中旬以来,大模型榜单前十已难见开源模型,有社区分析把这轮节奏变化归因于反蒸馏措施收紧——相关性与归因还不能画等号。微博
守不守得住,别看快照
54.0% 到 0.2% 是一次测试的成绩,不是历史的结尾。OpenAI 披露的口径本身就列明了剩余风险的依赖项:部署环境、攻击者能看到什么、攻击集何时更新,以及请求之外的账号调查能否及时跟上。知乎
防线一直在追着漏洞走。今年夏天,MATS、ELLIS 等机构的 8 位研究者发表论文,演示了前沿模型 API 都存在同一个架构级问题,导致模型隐藏的推理过程可以被大规模提取,而方法只需要两次 API 调用。OpenAI 在 9 月披露了跨会话复用加密推理的风险并把它堵上。10 月,丹麦奥尔堡大学等机构又发现,通过标准 API 注册一个简单的自定义工具,就能让前沿模型把中间推理过程外化出来,其中就包括 GPT-6 Astra。哔哩哔哩知乎知乎
更根本的争议在“草稿纸”本身。Lanham 等人的忠实性实验通过截断思维链或插入错误来干预作答,结果显示不同任务对可见推理的依赖差异明显,这种依赖与思维链带来的准确率收益也不完全同步。思维链未必是模型内部计算的全量记录,被这次防线锁走的“精确轨迹”,其价值本身也要打折看——这同时解释了摘要蒸馏为什么依然够用。知乎
对“AI 开发者还能不能做模型蒸馏”这个问题,答案是分层的:用可见输出训练,能做,但先过条款与账号风险这一关;白嫖精确思维链,GPT-6.2 系列上这扇门基本关死;指望这道防线一劳永逸,过去一年的攻防记录不支持这个指望。


当前文章无评论,是时候发表评论了