

降AI味第一步就上传全稿?你的存稿正在别人服务器上被阅读
做"去AI味",大多数人的第一步其实最危险:把整本书、整篇论文贴给云端AI,或者丢进某个"一键洗掉机器味"的网站。小红书上一条去AI味提示词笔记能被收藏六万多次,知乎上"有没有完全免费的降AI率工具"被反复追问,而底下最清醒的回答只有一句:降AI率需要实际调用模型改写,模型按token收费,因此不存在长期免费。。也就是说,稿子出了本机,账单按次到账。更扎心的是另一件事:网文平台在封杀AI作品,有人拿着朱雀检测100%人工的报告去问编辑,编辑还是一眼看出AI味。而检测分本身也是最不可靠的指挥棒——有作者公开了自己测过的数据:同一章只改约2%的字句,softmax值从0.3736直接跳到0.5542。盯着分数反复洗稿,改出来的全是噪声。知乎知乎知乎
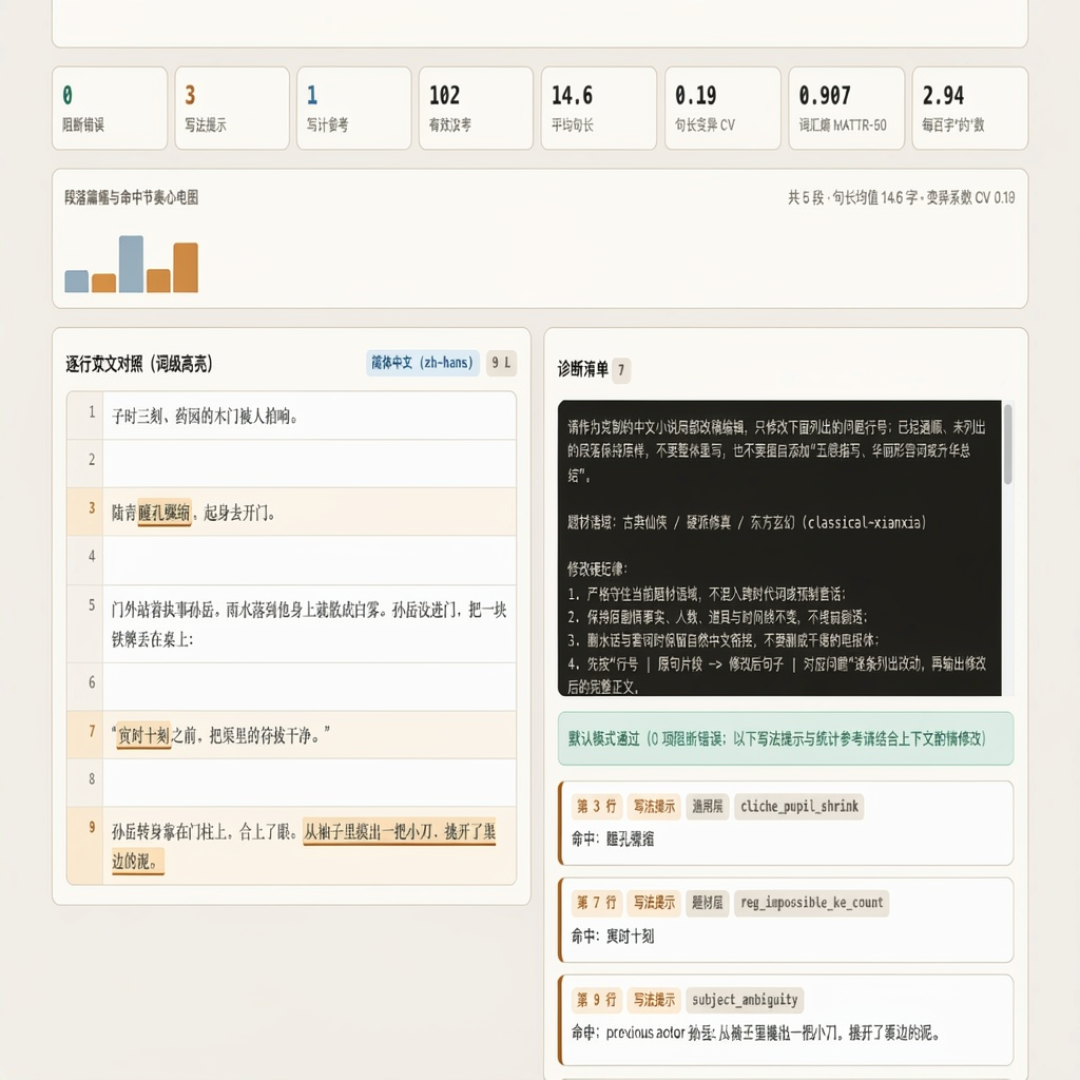
11月中旬,一个用AI写中文长篇连载的作者给出了第三条路。他把自己的质检流程做成了MIT开源项目InkBone(墨骨),核心动作只有一件:把"写故事"和"查硬伤"拆开,规则能管死的事,绝不交给大模型"自觉"。他的判断很实在:System Prompt越写越长也管不住会忘事的大模型——禁词塞得越多,模型复现得越勤;全书大纲喂进去,它能把第60章才揭晓的底牌顺手写进第18章的旁白。所以他用本地确定性脚本按行卡死:只扫引号外叙述的高频套话(“瞳孔骤缩"这类,角色正常对话不误报)、题材语域穿帮(古风文里冒出"性价比”,"寅时十刻"这种一个时辰最多八刻的伪历法)、还有中文省略主语造成的歧义。他自测4个题材的AI初稿:47处行内问题、17项警告、1项阻断硬伤,按行号精准点名改完后清零。数据出自作者单方测试,没有被独立复现过,但至少说明这类问题是能被规则稳定抓住的。知乎知乎
最值得抄走的设计是"双栏防剧透账本":每条伏笔拆成"当前表面线索"和"真正底牌"两栏,底牌绑定揭露章号;给第18章打包上下文时,未到揭露章的真相被代码自动遮蔽成[REDACTED]。模型压根看不见底牌,自然没法漏嘴。项目里还有一道审读打假阀:模型审稿必须附原文逐字可查的引文,查不到直接拒收,评语里敢劝你"多堆五感描写和形容词"的同样拦截——AI编造引文再教训你的文笔,这套流程见一次打一次。知乎知乎
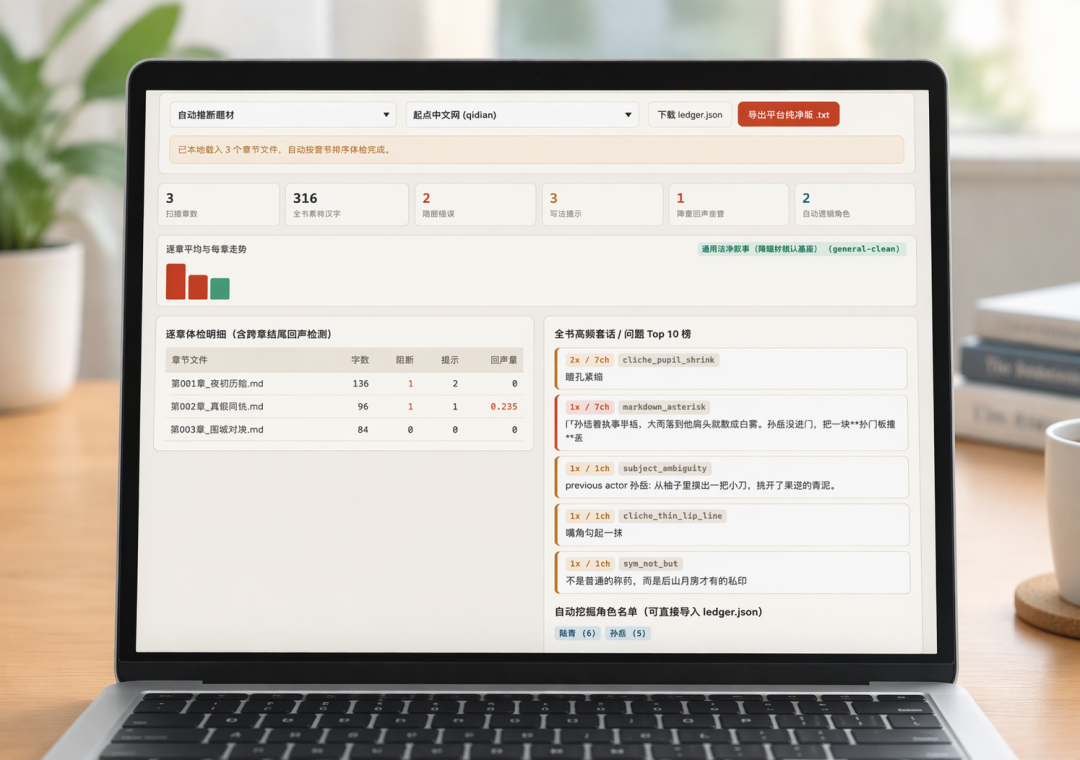
对"本地部署"玩家来说,真正的看点是它的部署形态,一共三档:不懂代码,直接用在线试跑台,100%浏览器本地运算,断网也能用,正文一个字都不上传;想跑整本书的全流程,Node 18+、零第三方依赖,内置9个题材包、19条命令,命令行里整本多卷目录直接体检;平时就在用Claude Code或Codex的,还能把它装成Agent Skill,让写稿流程本身接上质检。当然,边界也要说清楚:它管的是"哪里有问题",改稿那支笔仍然在你自己或你自选的模型手里;而且"本地"不等于"万能"。本地部署的价值从来不是省那几块钱token费,而是让你想明白一件事:有些稿子,本来就不该离开这台电脑。知乎知乎

当前文章无评论,是时候发表评论了