

先把容易误会的一件事说清楚:AMD 刚发的 ROCm 10.2,不是让老核显跑得更快,是让它跑得更名正言顺。
11 月 19 日前后,AMD 放出 ROCm 10.2。跟本地部署真正相关的是这条:GPU 计算支持又扩了 18 款 Ryzen 处理器,包括 Ryzen 7 253、Ryzen 7 249、Ryzen 7 217、Ryzen 5 224 及对应 PRO 版本,全部是 gfx1103 架构的 RDNA 3 核显——就是 Radeon 780M 那一挂,Windows 和 Linux 双平台都不需要额外配置。微博快科技
具体给到的是 HIP、PyTorch 和 vLLM 的验证支持,AMD 的说法是能在无需自定义构建或配置的情况下跑受支持的本地 AI 负载。同期放出的 Adrenalin 26.11.2 显卡驱动也主打稳定性,并新增 ROCm 10.2 支持。微博新浪数码
为什么说这是件值得单说的事?gfx1103 以前算黑户:ROCm 7.13 之前它不在 AMD 官方支持列表里,得靠 HSA_OVERRIDE_GFX_VERSION 环境变量把自己伪装成别的卡才能用。后来 7.13 技术预览版把它收了进来,可在 Windows 上走 WSL,还得手动给 librocdxg 补设备 ID,WDAG 和 Smart App Control 这类安全功能也会来捣乱。知乎专栏
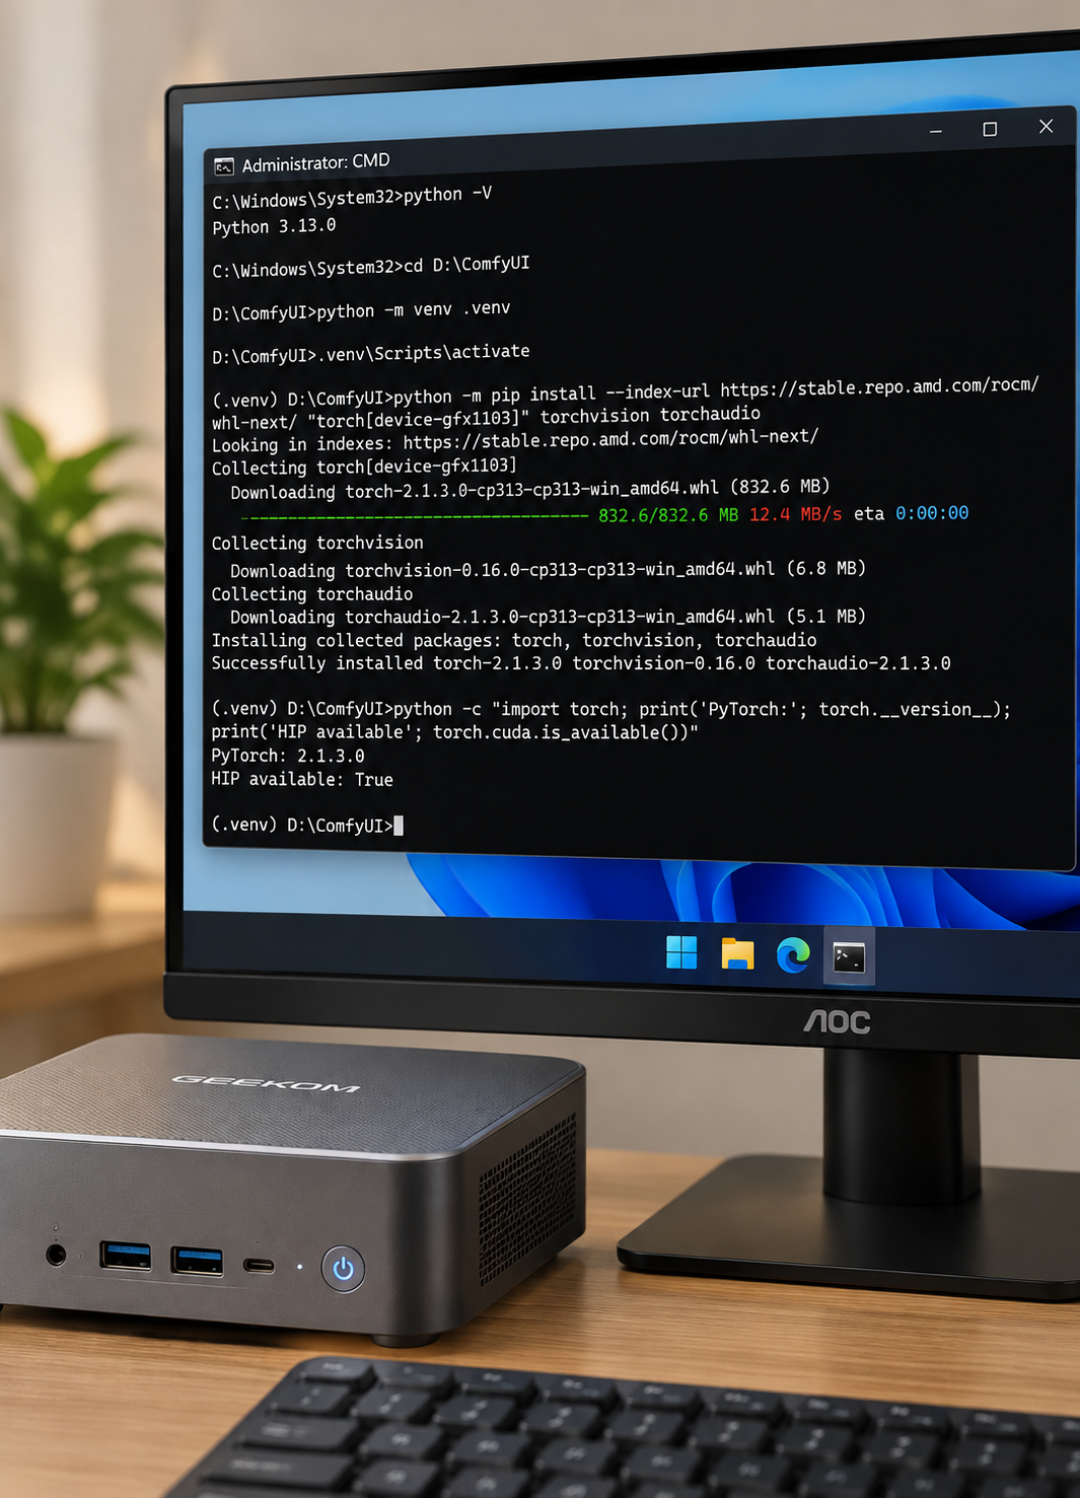
这套手续有多磨人,看昨天的一个记录就懂:一台零刻 SER7(7840HS+780M,Win11)手工装 ComfyUI,Python 必须 3.13 64 位、虚拟环境不能用 uv、cmd 要管理员、镜像源还缺包,作者自己的评价是安装过程挺折磨人。ROCm 10.2 想省掉的,正是这一堆。知乎专栏
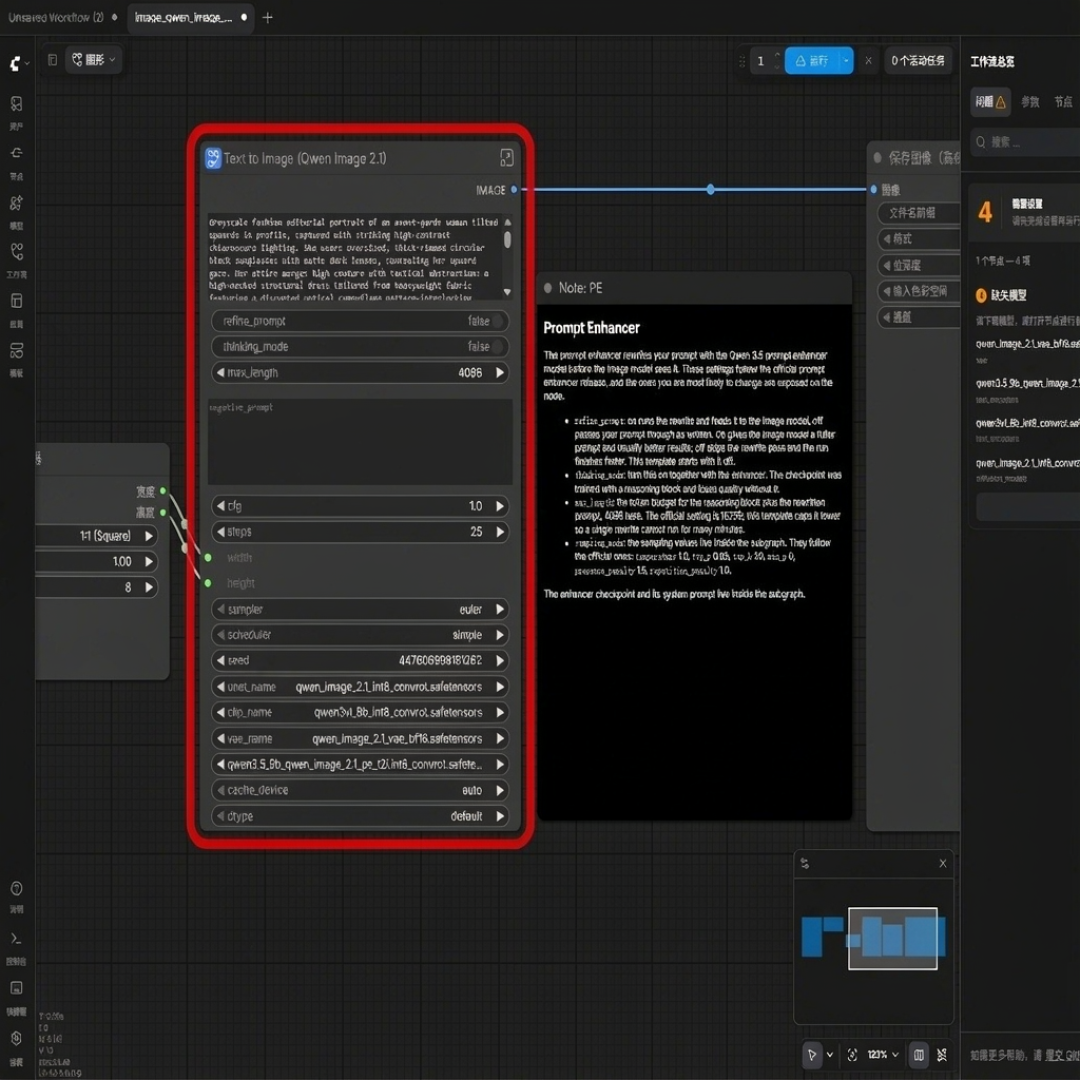
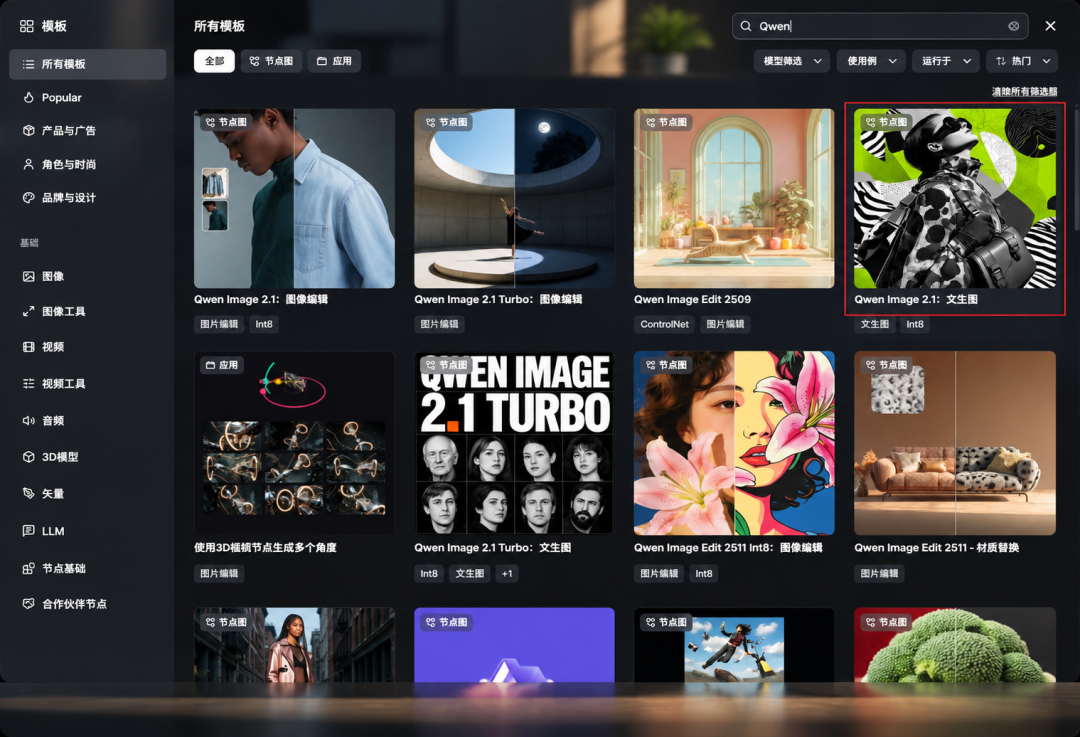
但它省不掉物理定律。核显没有独立显存,吃的是系统内存带宽:DDR5 双通道大约 80 到 90 GB/s,而一张 RTX 5070 的 GDDR7 是 672 GB/s。这条差距不会随驱动版本号变化。那位零刻用户的实测也摆着:默认配置出一张 Qwen-Image-2.1 大概要 300 秒,他的结论是作为生产工具肯定不行,只能当入门学习和娱乐。知乎知乎专栏
更微妙的是,AMD 自家后端未必是你该选的那个。Phoronix 用 Lemonade 2026.39.1 测了插 Radeon AI PRO R9700 的 System76 工作站和装 Ryzen AI Max+ 395 的 Framework Desktop:ROCm 首包响应更短,吞吐量却是 Vulkan 赢,Qwen3-14B 上约 1.5 倍,换到 Qwen3.5-14B 直接拉到 3 倍,llama.cpp 和 Lemonade 走势一致。这是独显和 Strix Halo 的数据,不是 780M 的。知乎专栏
同一个方向上还有更接地气的注脚:11 月 19 日知乎有人问 780M 用 Ollama 跑 DeepSeek 表现不佳该怎么提升,有个回答只给了一句话——绕开 ROCm 和 torch 的兼容坑,转投 Vulkan。知乎
所以这批老核显的正确期待是:门开了,路没变宽。它是"能跑",不是"能干活"。
动手前先分清目的。日常聊天、7B 级量化模型、让 Agent 在本机干点轻活,Vulkan 后端通常更省心也更快;要上 vLLM、SGLang,或者你在意首字延迟,ROCm 现在终于是条不用伪装的正路。
还有一条别省:驱动支持某款设备,不等于 ROCm 和你要用的框架在完全相同的系统组合下也支持。装之前先按自己那套 GPU+系统+驱动+ROCm 版本去查 AMD 的兼容矩阵,别只盯 latest 链接。小红书


当前文章无评论,是时候发表评论了