

这个 53.6 分来自 Scale AI 今年 10 月发布的 HSS 基准(Humanity’s Sixth Sense,“人类第六感”):500 多道图片和视频题,考的全是人类“一眼秒懂”的直觉判断。差距不在“会不会推理”,而在推理开始之前:AI 看错了画面、漏掉了线索,思考越深反而把错误越推越远。新智元知乎
一场专考“秒答题”的考试
论文里测试了 GPT-6 Astra、Opus 5.5 等最强模型,正确率全都没有超过 60%,而这些题人类可以秒答、正确率在 90% 以上。知乎
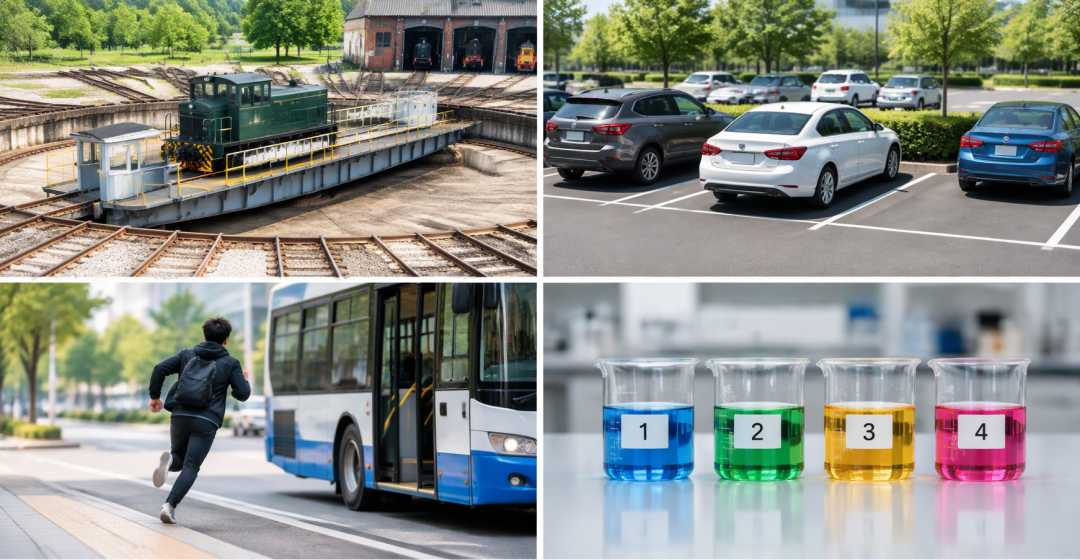
它的定位是和同门的高难基准 HLE(Humanity’s Last Exam)形成互补:HLE 考“人类答不出但 AI 会”的难题,HSS 反过来考“人类一眼就会、AI 却做错”的直觉题。题目覆盖看一眼还原过去与未来、判断车能不能停进车位、几秒视频看出房间里谁说了算、从片段里读出没写明的规则这类场景,分成时间因果、物理空间、社会理解、抽象推断 4 大主域,配套数据集和评测代码已在 HuggingFace 开源。知乎
错题本暴露了真正的短板
论文把失败样本逐一归因后发现,大部分错误都出现在感知层(Perception)和隐含信息推断(Latent),只有很少的错误落在逻辑推理(Reasoning)。换句话说,AI 不是“算错了”,而是第一步就看漏了——后面的推理再严密,也是在错误素材上做文章。知乎
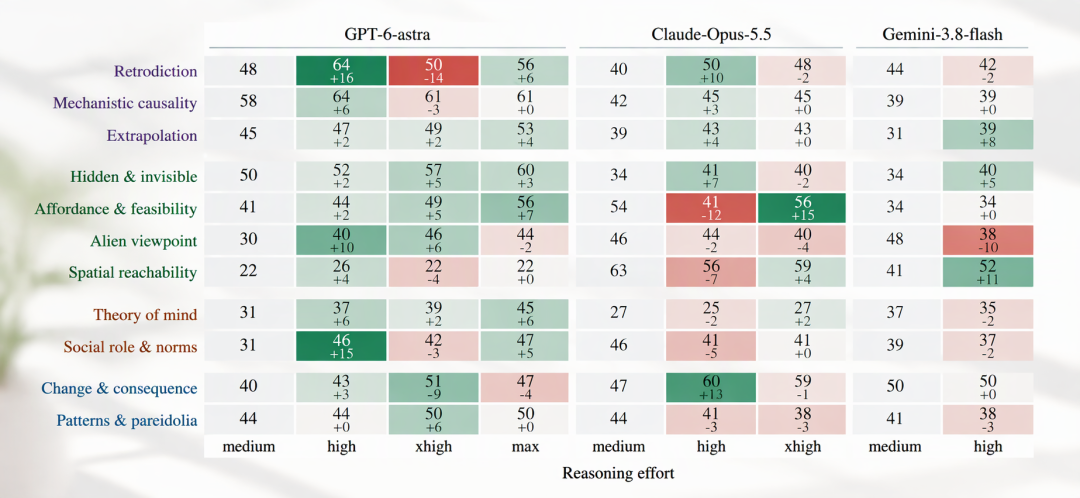
社会理解是最差的一块:Astra 正确率 46.1%,Opus 5.5 更是只有 34.8%,接近瞎猜。知乎
更能说明问题的是“加思考”实验:论文发现提升思考深度,效果反而会变得更差,同一模型把推理档位拉高,部分题型得分不升反降。当错误发生在感知阶段,更长的思考链只是在给看错的输入编理由——“深度思考”救不了“没看见”。知乎
行业押注“直觉层”,但还没交卷
人类这种“第六感”,是卡尼曼说的系统一:基于身体与社交经验的快速模式识别,先于语言发生。当前多模态模型却要从感知编码跳进语言空间再展开推理,第一跳的质量就是这场考试的天花板。行业已经在补课:TypeSafe 把 9 月发布的决策模型 Jev 称为「SystemOne模型」,它只做判断、不写文字,名字正取自《思考,快与慢》。36氪
OpenAI 在开发者日上推出 DecisionsAPI,Cloudflare 开源了 Clef,亚马逊放出 StrandsDecider,国内多家团队两周内在同一个品类里跟进,把这个新品类从“首发”打成“群战”。36氪
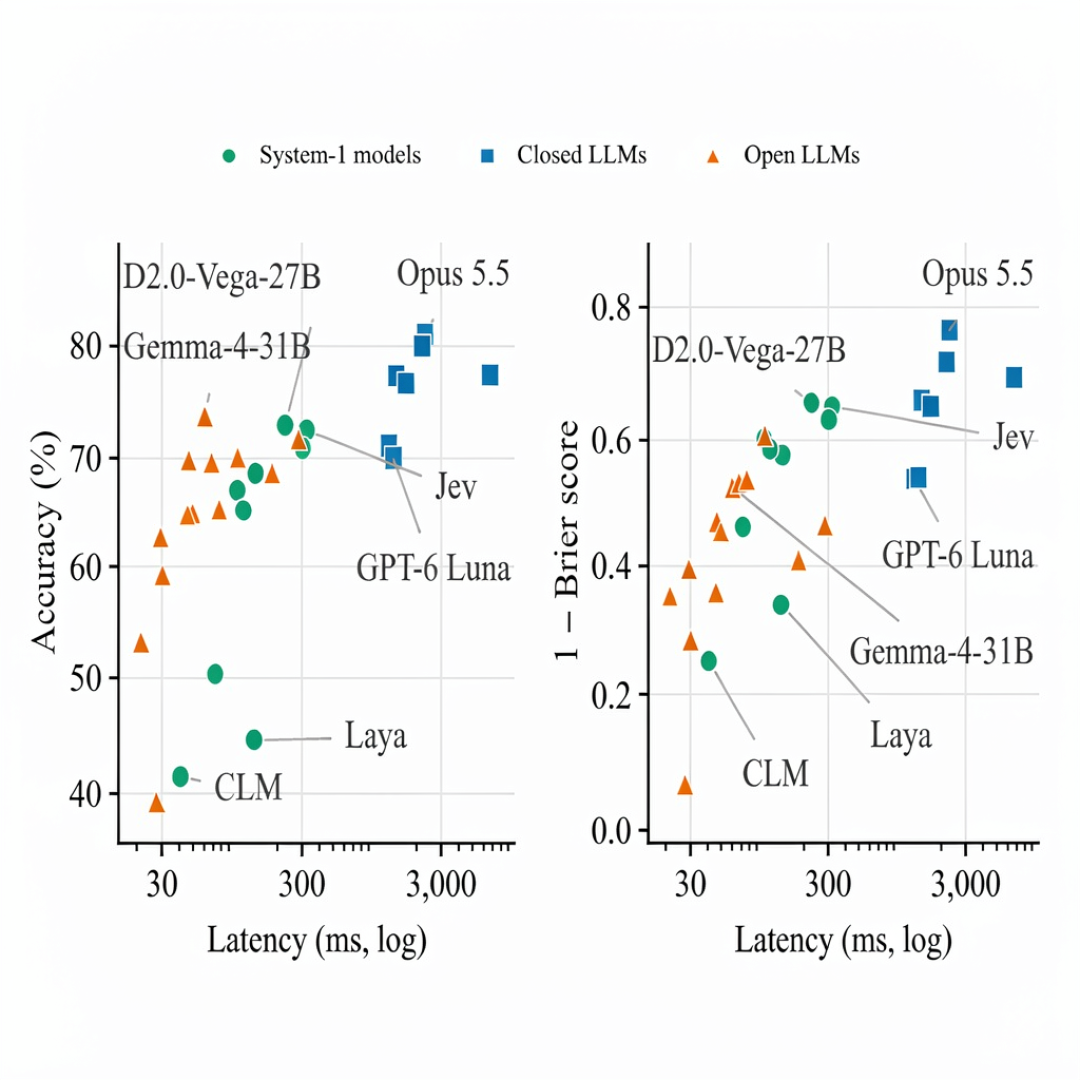
知乎答主转述的 System1-Arena 论文对比显示:Jev 用 300 毫秒拿到 73% 的决策准确率,Opus 5.5 用 2 秒拿到 81%——专职“直觉”的模型赢在速度,但准确率并没有质变,很难说这类模型已能对应人类直觉。知乎
同类“人类轻松、AI 翻车”的基准也在扎堆出现:普林斯顿的空间智能大考,人类 83.3%、大模型最高 39.7%。口径各不相同,方向却一致:靠“一眼”解决的任务,正在成为前沿模型集体失分的新前沿。知乎
53分之后,看什么
需要说明边界:53.6 是论文送审时点的快照,Scale AI 官网榜单的最新可见版本里,榜首换成 Gemini 4 Argon,也才 55.4 分,依然被人类甩开三十多分。11 月 18 日,OpenAI 正式推出 GPT-6.2 Astra 与 Sol 两款新模型,但尚未见到公开的 HSS 复测成绩。这张考卷的价值恰恰在于开源和冻结:榜单不会被一句“内测领先”带跑,新模型行不行,跑一遍这 500 多道题就知道。知乎
对普通用户的现实意义更直接:判断 AI 能不能接手“看场面”的活——从监控画面里发现不对劲,到从聊天记录里读出谁在敷衍——不能只看它知识题上的高分,它在感知层犯的都是些人类不会犯的低级错误,而这类错误不会因为打开“深度思考”而消失。人类一眼看穿的东西,恰恰是 AI 最缺的那一感。

当前文章无评论,是时候发表评论了