

这轮答案恰好被十一月的三件事同时写了出来:一个查无此主的匿名模型在设计盲评里超过了人类参考稿。一款刚刷新综合跑分纪录的旗舰,24 小时内被内测开发者骂到"基本不可用"。而《自然》杂志上,陶哲轩警告 AI 生成数学证明的速度已经快过人类理解的速度。把这三件事摆在一起,结论很清晰:当今 AI 模型的能力极限不是一堵墙,而是三条忽明忽暗的线——单点专业任务的"参考线"已经被跨过;任务一旦变长、验收一旦变严,"偏科线"立刻显形;而用来量这些线的尺子,正在比模型更快失效。哔哩哔哩知乎36氪知乎
第一条线:职业设计师的参考作品,第一次在盲评里输了
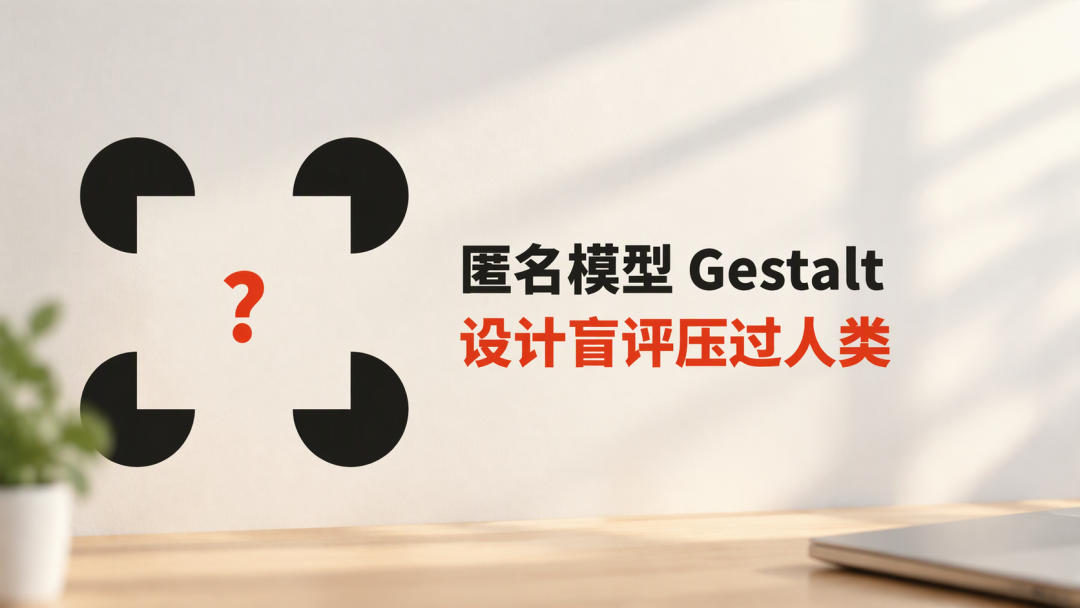
11 月 18 日,设计师接单平台 Contra Labs 与评测机构 BenchFlow 发布 Frontier Design Benchmark 首轮结果,题库不跑抽象题,全是真实生意里的活儿:多页营销网站、众筹结账流程、带小测验的在线课程,评审在不知道作品来源的情况下两两对比、投出自己更偏好的一个。知乎
28 次正面对决里,设计师有 20 次选了这个没有名字的匿名模型。分数的快照口径略有差异:18 日公布时是 1928 分对人类参考稿 1736 分,19 日查阅时更新为 1931 分对 1739 分,Claude Fable 5.2 以 1713 分排第三——两个来源独立记录,断层第一这个结论没有争议。哔哩哔哩知乎
评测方还单独统计了作品里常见的"AI 套路感":按这项指标,Gestalt 比其他模型更少呈现行业习以为常的生成套路,接近人类参考作品的水平。知乎
需要把胜利的范围说清楚:它赢的是这一轮盲评里的参考成品,而不是设计师的全部工作——客户中途改需求、上线后用户找不到入口、一个页面要维护两年,这些评测没有覆盖。它至少证明了一件事:在能被真实客户题目和真人审美验收的窄任务上,"AI 追不追得上专业人士"已经不是个问题。至于它到底是谁家的,截至发稿没有任何厂商认领,社区一种值得注意的推测认为它可能是靠多个模型循环组合取胜的路由型系统,同样没有实据。知乎
第二条线:跑分冠军和"不可用",可以是同一款模型
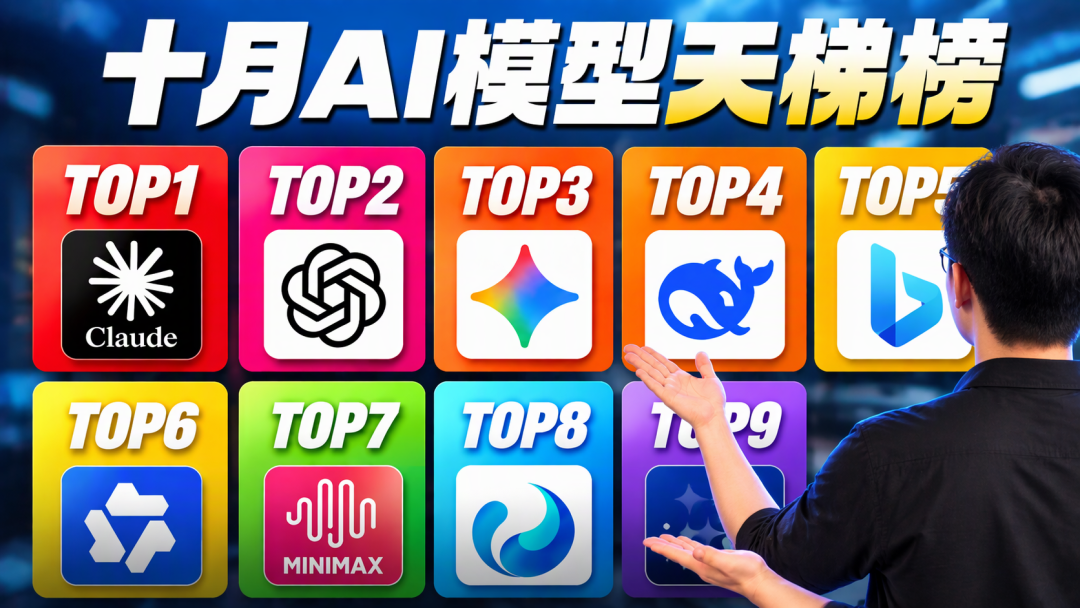
同一周的另一个样本更有警示性。11 月 18 日,OpenAI 在 Anthropic 上市当天发布 GPT-6.2 Astra 与 Sol,跑分确实刷新了纪录:Artificial Analysis 综合九大维度的智能指数上,Astra 暴涨 5 分拿到 62 分,超过 Gemini 4 Carbon 的 60 分和 Claude Opus 5.5 的 59 分。36氪
长程专业工作流才是它真正的主场:在 Agents’ Last Exam 上拿下 78.3%,完成同样评测任务的平均成本仅 2.89 美元,而 Claude Fable 5.2 是 60.05 美元。这是指定评测配置下的成本口径,不等于所有真实业务都能省九成以上;CAD 评测 BenchCAD 2.1 Core 也从上一代的 62.6% 跳到 82.5%,模型开始深入到零件装配关系、运动约束这类工程细节。36氪
然后口碑在 24 小时内翻车。开发者 Theo 把此前几代模型烧掉 30 多万美元 token 都没入门的 TypeScript 重写项目交给新旗舰,它闷头跑了整整 7 天性能零提升、反而把编译器搞慢 56%,被叫停"缩小体积"后又空转 4 天、代码改动量为 0。内容机构 Every 的 CEO 带 30 人团队内测数周的结论是"我们团队中没有人喜欢 Astra 6.2"。同样的性能问题,隔壁模型一句"因为你那块 SSD 太慢了"就说清,它却输出四段底层机制论文,连"按 5 岁小孩能听懂的话讲"的指令都不管用。36氪
第三方数据撕开了同一道缺口:基于 Codex 测试架满算力运行的 Coding Agent Index 上,GPT-6.2 Astra 得分与前代完全持平、0 提升,轻量款 Sol 甚至倒退 3 分。极限就藏在这个分裂里——连骂它最凶的 Theo 也承认这是"偏科怪才":代码审查能揪出所有其他模型漏掉的死角,常规软件工程就是不开窍。那份 112 次调用的回溯研究点破了机制:更强能力的价值,可能主要出现在更难的任务里,而不是每一道日常题上。36氪知乎
第三条线:量极限的尺子,正在比模型先过期
比"模型哪里不行"更根本的问题是:我们凭什么说它行不行。BetterStack 近来的提醒流传很广——你实际用的 AI,可能根本不是跑分测试的那个模型:路由、量化、档位映射,都会让榜单分数和体感对不上。哔哩哔哩
即便跑分可信,读法也极易出错。Crazyrouter 团队按 Artificial Analysis 公开数据整理出 517 个模型发布版本、对 7 款模型做了 112 次调用:同一把 Progress Index 标尺下,中美前沿分差 9 月底曾扩大到 27.61 分,Kimi K3.1 Pro 在 10 月 23 日发布后又收窄到 10.57 分——分差随谁发新旗舰反复摆动,写成"差距持续扩大"或"马上追平"都不成立;而 AA 已在 10 月 27 日把智能指数升级到 v5,新旧考卷的分差根本无法拼成同一条曲线。知乎
那篇研究还记录了更日常的一幕:Claude Opus 4.8 在订单提取任务里字段和值全部答对,只因为在 JSON 外面套了一层 Markdown 代码围栏,严格通过率就大幅掉档——变的不是模型,是验收口径。知乎
数学界的信号更直白:陶哲轩批评把攻克数学难题当作企业能力测试的做法,犹如抛出"有毒废料"。就在这两天,一份"数学家与 AI 合作证明黎曼猜想、证明稿超 25 万页"的说法在社区流传,是否成立尚无定论。但无论最后成不成立,一件人类读不完、只能交给机器逐步检查的"证明",都在提醒同一件事:生成能力正把瓶颈推给验证能力,而这恰恰是目前最没有公开榜单可量的一段。知乎知乎
那么,普通用户该盯着什么
如果你想知道 AI 到底"行不行到哪",别再问跑分。三个可自己操作的判断:其一,用你自己的验收标准测它——格式是否严格符合程序要求、连续几十步会不会中途停下来"问傻问题"卡死,这比榜单第一更说明问题;其二,观察新形态评测会不会成为主流,Gestalt 式的"真实客户题目加真人盲投"就是冲着跑分饱和来的,它给出的结论边界也更诚实;其三,盯住自我改进能力的官方披露——OpenAI 称 Astra 是其首个对外发布、在 AI 自我改进能力上达到 High 风险等级的模型,意味着模型开始展现出显著加速下一代 AI 研发的能力。如果这条线成立,上面所有关于极限的判断都会加速过期。36氪
能力极限不是一条固定的海拔线,而是一条参差的潮汐线:在网页设计、零部件级工程、科研工作流这些滩头,AI 已经漫过了人类的参考线;在长任务交付、格式纪律、原创提问这些地方,它还在原地甚至倒退;而用来标记潮位的水尺,本身正在漏水。对普通用户来说,真正的"极限"其实只剩一个问题——把你手里那件具体的事,按你真正的验收条件交给它,它能不能便宜、稳定地做完。能,这个极限对你就已经让开了;不能,那么榜单再第一,也与你无关。
当前文章无评论,是时候发表评论了