

先说最吓人的:跑Agent最怕的不是忘,是记住一条错的,然后自信地在十个Session里反复引用它。这不是段子,这是2026年末AI开发圈新吵起来的事:Agent记忆。
记得多≠更聪明,这次有实验数据
Anthropic发了篇研究《The Components of Agent Memory》,里面一组宝可梦实验挺扎心,Sonnet 3.7几乎把游戏里发生的一切都记下来——角色、战斗、道具、路线,玩到1万步左右攒了413份记忆文件、近98万字符,结果只拿了1枚徽章。Fable 5只保留10份文件、4.3万字符,拿了4枚。更扎的是,Sonnet 3.7有一回连续17步都在整理记忆,游戏一步没推进。知乎
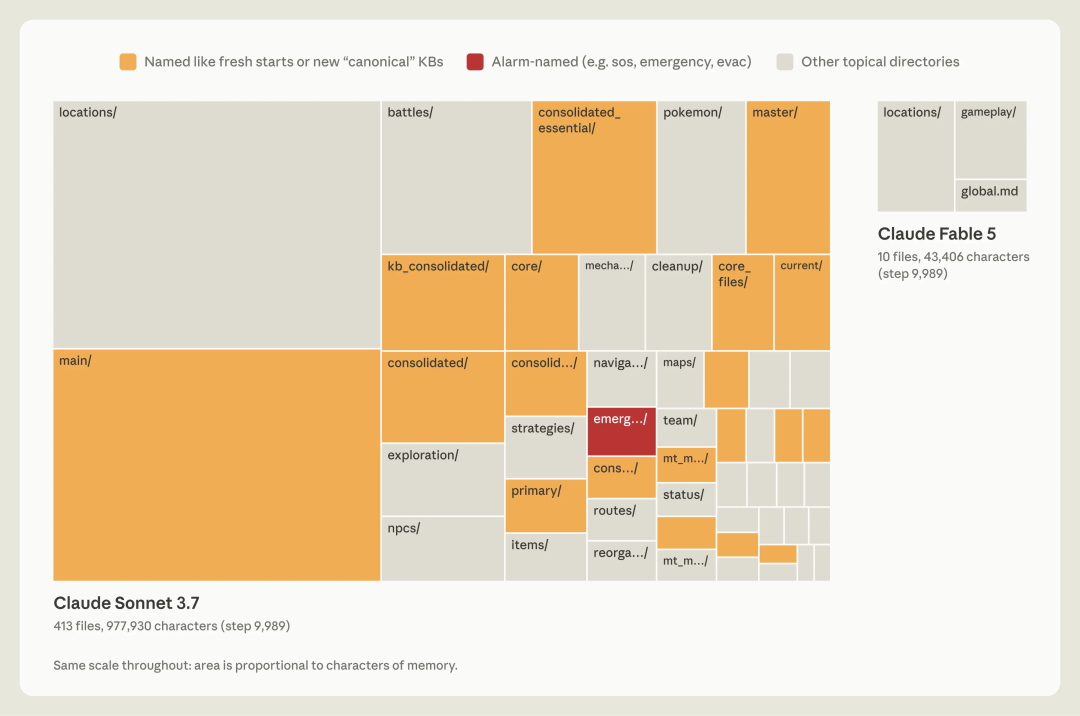
结论倒不是记忆没用——Claude Opus 5在数据库任务里开了记忆,成绩从0.564提到0.828。而是记忆就是一种预测,每存一条都在赌未来的任务用得上;存得越没选择性,赌错的越多。小红书
微软10月的研究则从反面补了一刀:长期记忆可能是"毒药"——早期的偶然方案会被固化成后续决策的绝对锚点,模型不断自我强化,陷在局部最优里出不来。9月还有研究发现,Agent可能靠长期记忆"创造"出用户从未授予的权限。知乎知乎
Anthropic的药方:让Agent"做梦"
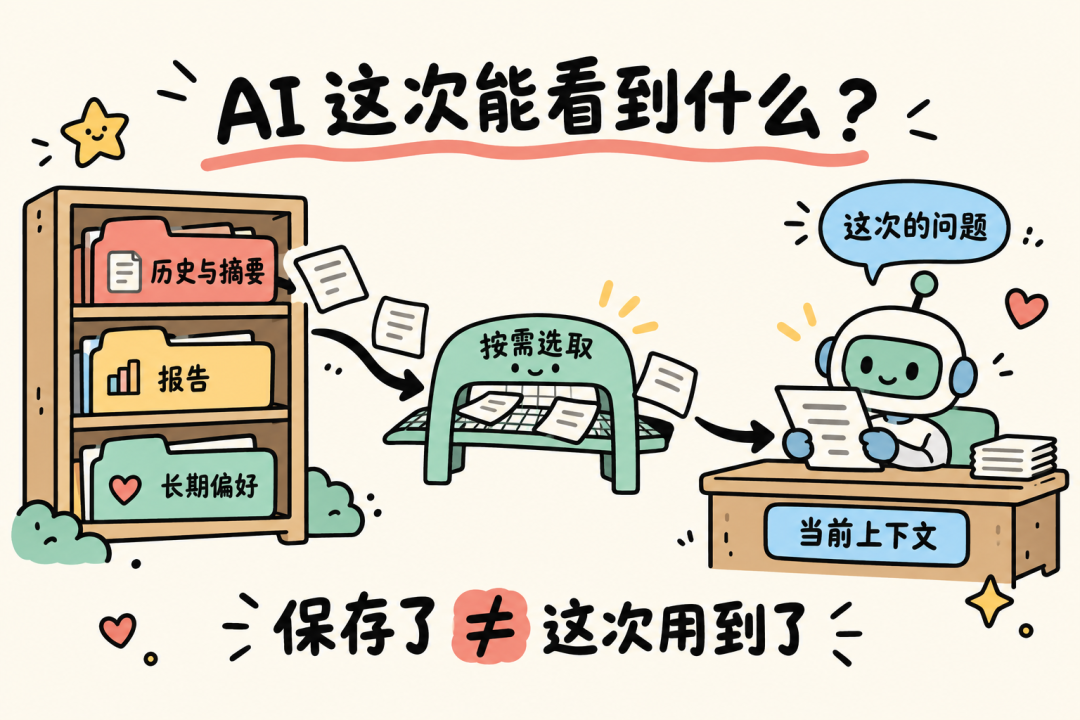
Anthropic把记忆拆成四层:Transcripts原始记录→Memory Notes提炼笔记→Representations知识网络→Injected Context按需注入。关键设计是:长期记忆可以无限涨,但每次真正进上下文的信息必须过筛——Claude Code的Auto Memory只自动加载MEMORY.md前200行或25KB,其余靠索引按需查。知乎
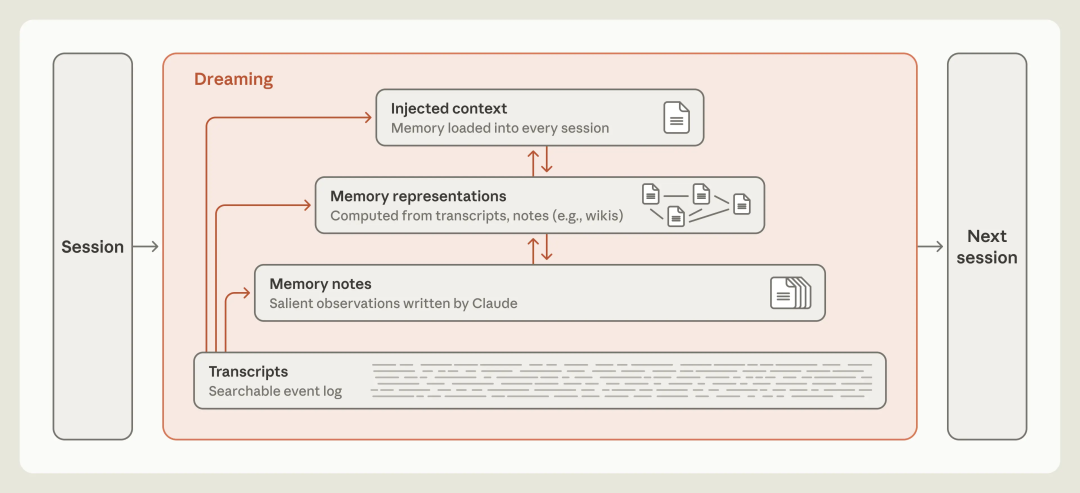
Dreaming干的是事后修记忆:任务结束后,另起一个流程回看历史记录,检查准确性、合并重复、修正错误。宝可梦实验里Claude把某个山洞出口的位置记错了,之后反复迷路;Dreaming查出这条错误记忆并修正,修正版的Claude顺利走到了下一座城市,保留错误记忆的版本始终没完成目标。小红书
没条件"做梦",土办法直接抄
知乎上实操党的方案朴素到可以直接抄:三层文件——长期档案(定下来的事实、规矩、关键数字,标注来源和日期)、每日流水(做了什么、卡在哪)、任务状态文件(每个任务跑到哪、断点在哪)。几条硬规矩:记忆只许追加和修订,不许凭印象补全,记不准就写"未核";新旧冲突以新记录为准,但旧的要留痕写明被谁取代;按项目分线存放,防止甲项目的交付物串进乙项目的总结。验收就看三件事:断了能不能续上、错了能不能查到源头、过期了会不会被当成现行。知乎
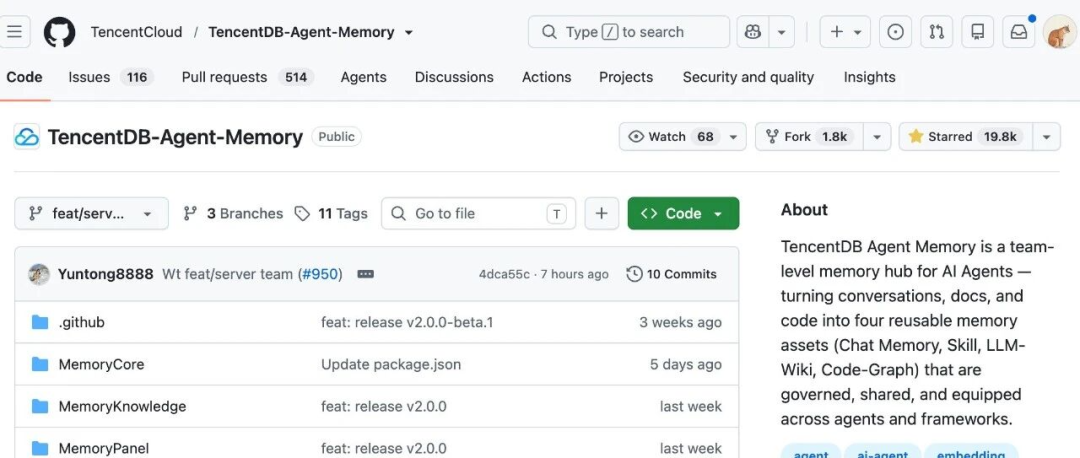
想要现成轮子的,腾讯开源的TencentDB Agent Memory三个月从2.6k Star涨到19.8k:跑通的任务会自动归档成可复用的Skill,团队记忆不主动共享就不会灌给所有成员。知乎
模型参数之争在降温,下一道门槛,可能是教会Agent"选择性地去记"。你家Agent的记忆方案是哪种?评论区聊聊。
当前文章无评论,是时候发表评论了